फ़ोन पर LFM3 चलाकर देखा कि क्या वह LangDict के AI फ़ीचर की जगह ले सकता है
हमने परखा कि क्या local LLM, यानी Liquid AI का छोटा मॉडल LFM3, जो फ़ोन पर ही चलता है, LangDict के AI फ़ीचर की जगह ले सकता है। LangDict भाषा सीखने का एक ऐप है, जिसे मैं बनाता हूँ।
यह चला, लेकिन परीक्षण के बाद मैंने इसे ऐप में न रखने का फ़ैसला किया।
हमने क्या परखा
LangDict एक फ़्लैशकार्ड ऐप है: आप जो शब्द सीखना चाहते हैं उन्हें दर्ज करते हैं और AI अनुवाद, उदाहरण वाक्य और उच्चारण बनाता है। यह तीन फ़ीचर के लिए Gemini API का उपयोग करता है।
| फ़ीचर | क्या करता है |
|---|---|
| अनुवाद | दर्ज किए गए पाठ का दूसरी भाषा में अनुवाद करता है |
| डेक बनाना | “Travel at the airport” जैसा कोई विषय लेकर शब्द, अनुवाद और पठन वाले कार्डों का एक समूह बनाता है |
| पाठ पहचान | फ़ोटो में मौजूद पाठ को संपादन योग्य पाठ में बदलता है (OCR) |
हमने परखा कि क्या local LLM इनकी जगह ले सकता है।
हमने तीन बातें देखीं:
- क्या तीनों फ़ीचर फ़ोन पर चलते हैं
- लगातार उपयोग में प्रतीक्षा का समय और गति
- आउटपुट की गुणवत्ता
परीक्षण की शर्तें
| मद | विवरण |
|---|---|
| फ़ोन | Android फ़ोन (7GB RAM) |
| मॉडल | LFM3-VL-2B (mmproj सहित लगभग 1.5GB) |
| तरीका | LangDict जैसे ही prompt वाला परीक्षण ऐप, चार्ज होते समय मापा गया |
| बार | हर शर्त पर एक बार (विचलन नहीं मापा गया) |
आँकड़ों को केवल मार्गदर्शन के रूप में लें। जिन मदों का PC पर भी परीक्षण हुआ, उन पर “PC पर” लिखा है।
समस्या 1: पहला अनुवाद लगभग 20 सेकंड अटका रहता है
ऐप खोलने के बाद पहले अनुवाद में पाठ आना शुरू होने में 21.2 सेकंड लगे, और स्क्रीन जमी हुई लग रही थी। दूसरा 0.9 सेकंड में शुरू हो गया।
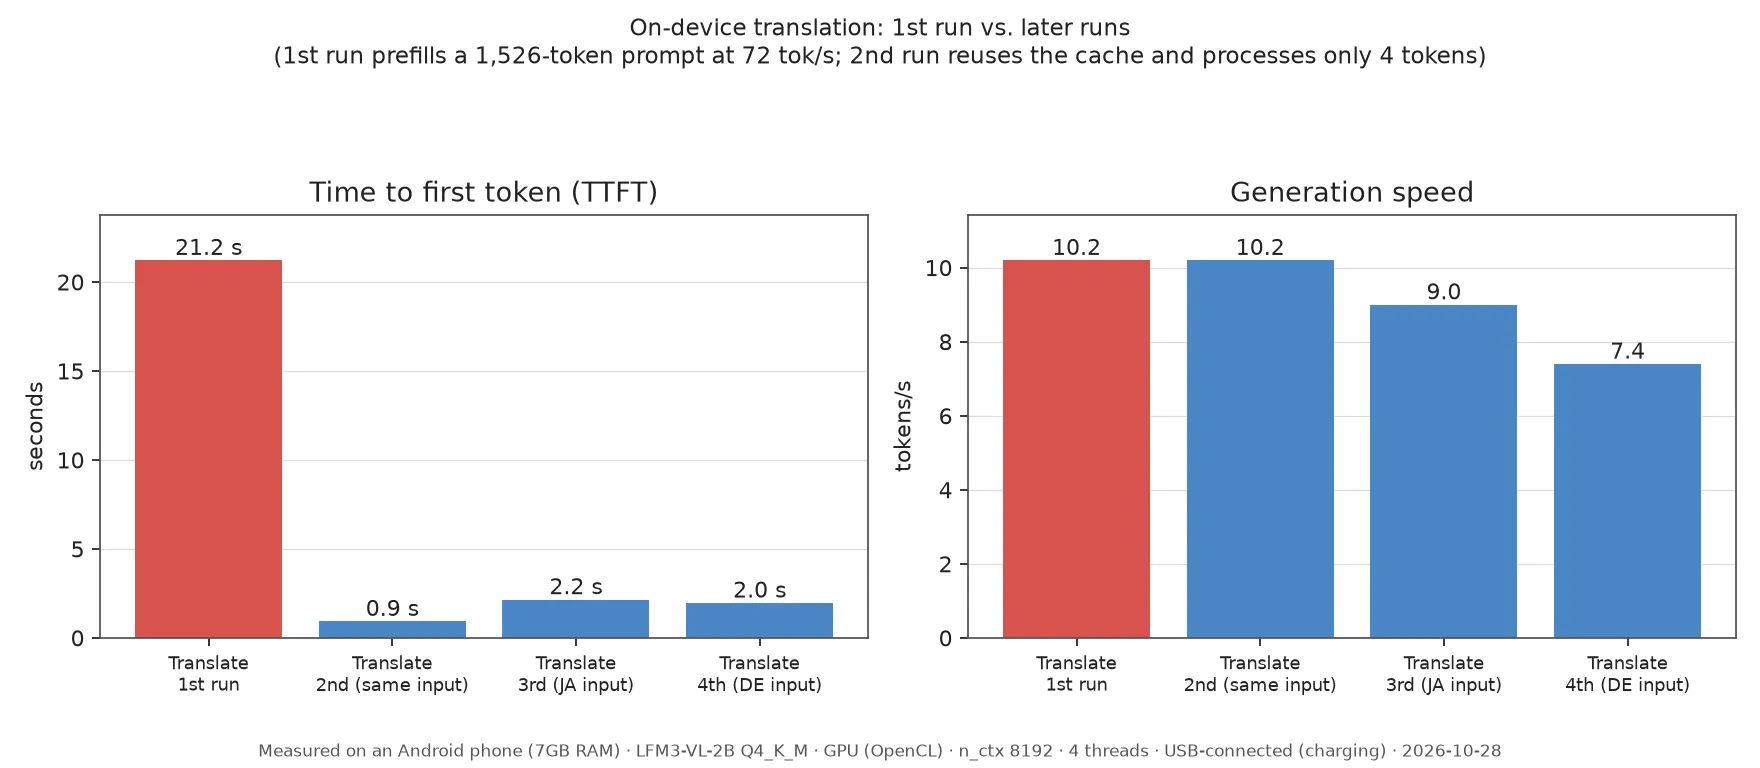
कारण prompt की लंबाई थी। अनुवाद का prompt 1,526 token का है और फ़ोन 72 tok/s पर प्रोसेस करता है, इसलिए उसे पढ़ने में ही लगभग 20 सेकंड लगते हैं। दूसरी बार तेज़ इसलिए है कि cache काम करता है।
prompt लगभग स्थिर है, इसलिए स्क्रीन खुलते समय उसका prefill कर देने से प्रतीक्षा घट सकती है। यह केवल एक विचार है; हमने अभी इसे आज़माया नहीं है।
समस्या 2: लगातार उपयोग से यह धीमा पड़ता है
कुछ मिनट उपयोग के बाद गर्मी से जनरेशन की गति घट जाती है, इसलिए बाद के काम को ज़्यादा इंतज़ार करना पड़ता है।
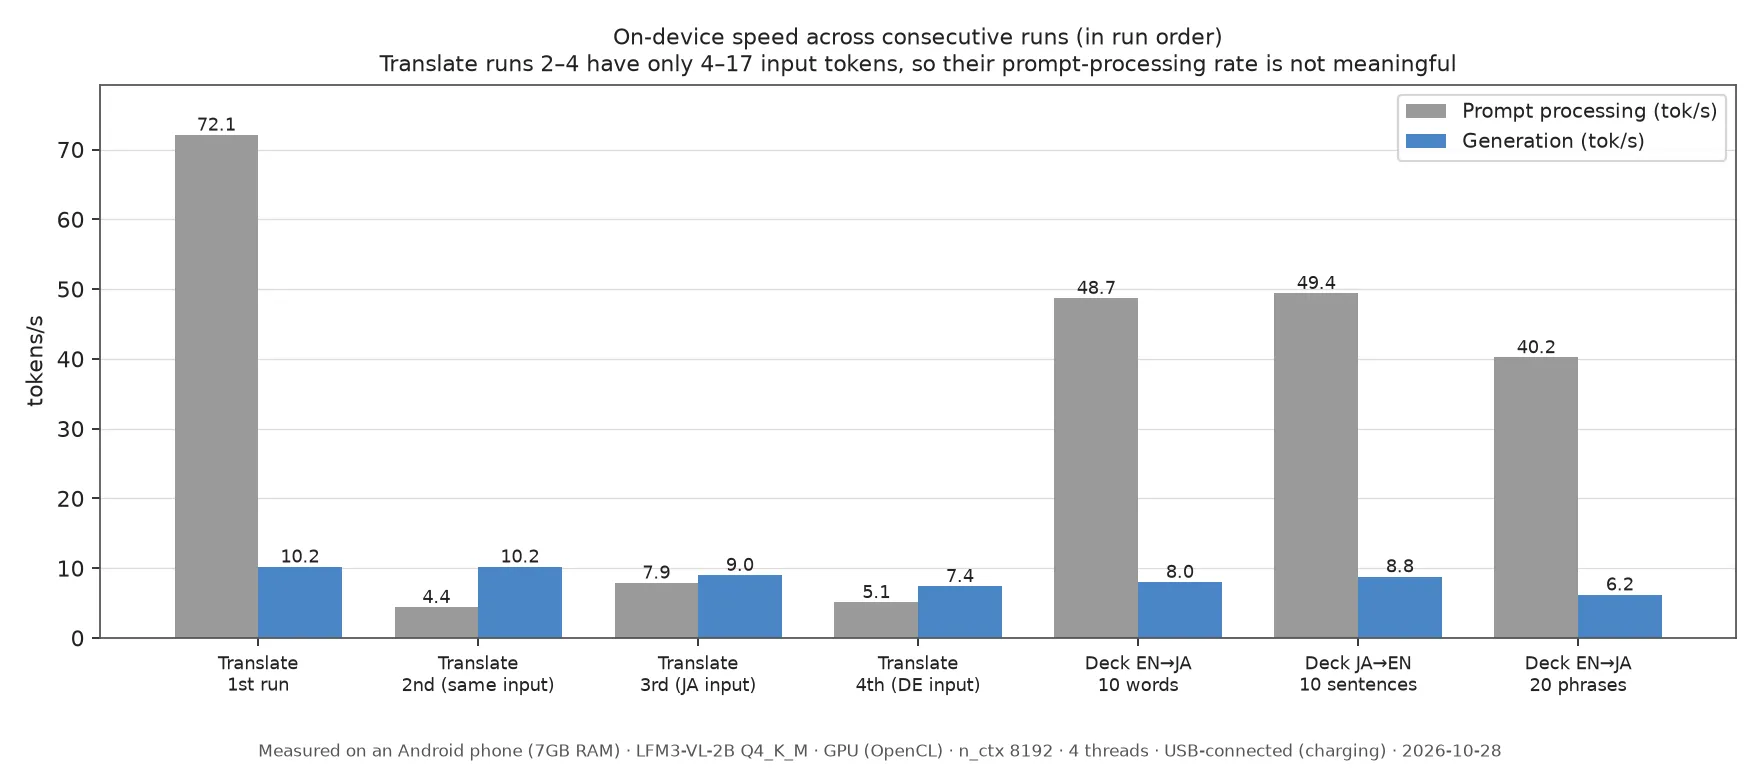
जनरेशन की गति 10.2 tok/s से घटकर 6.2 tok/s रह गई। 20 वाक्यांशों के डेक में 156.3 सेकंड लगे, और 10 शब्दों के डेक में भी 66.6 सेकंड लगे।
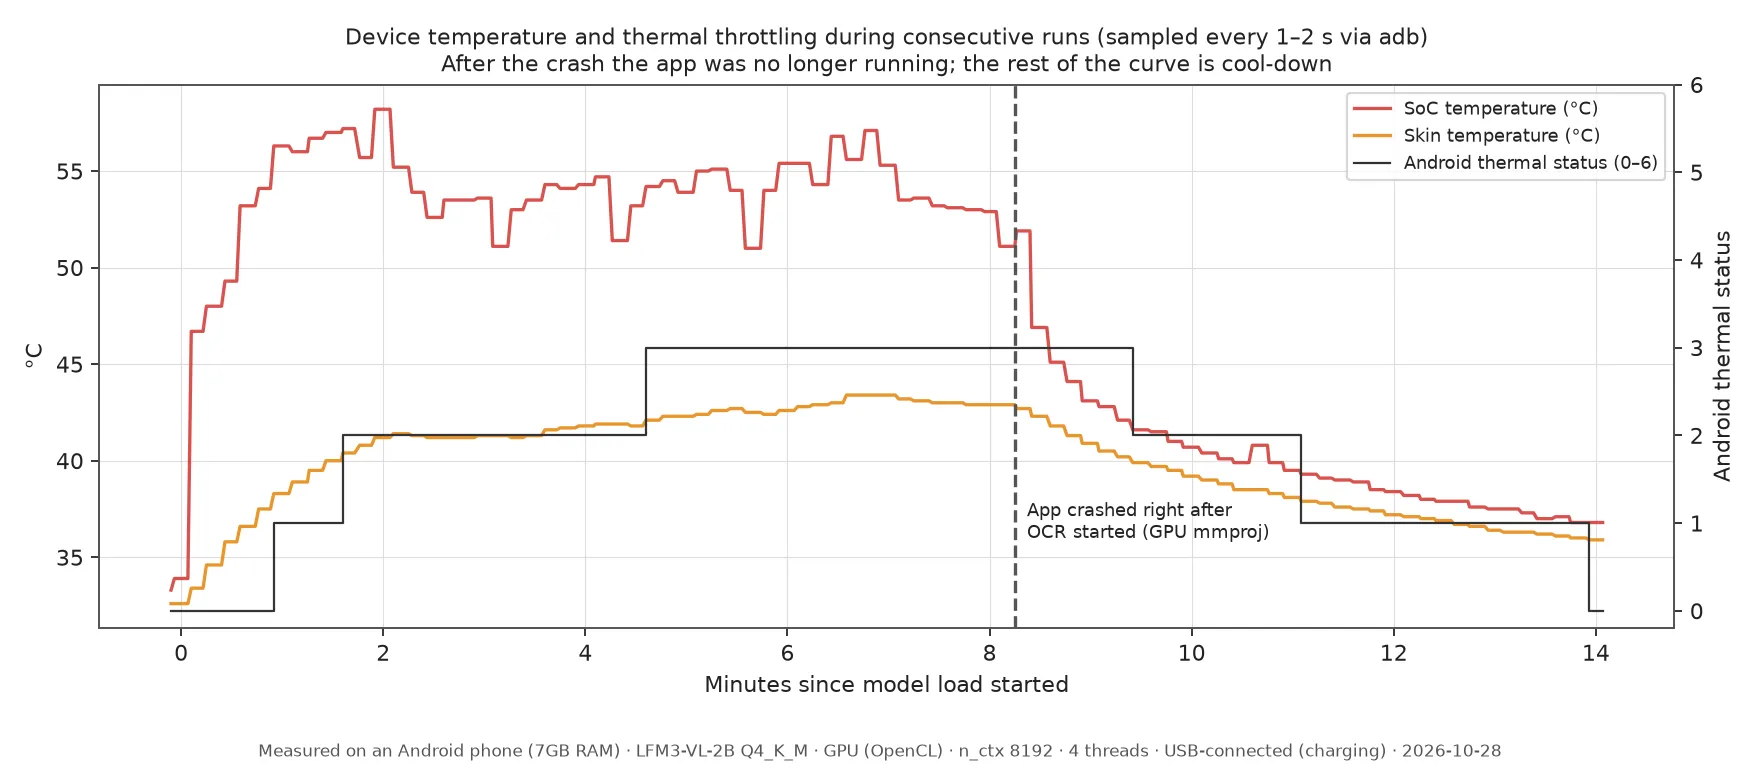
Android की थर्मल स्थिति लगभग 1 मिनट बाद 1 पर, लगभग 1.6 मिनट बाद 2 पर और लगभग 4.6 मिनट बाद 3 पर पहुँची। ग्राफ़ के दूसरे भाग में तापमान इसलिए गिरता है कि अगले इमेज टेस्ट के दौरान ऐप क्रैश हो गया।
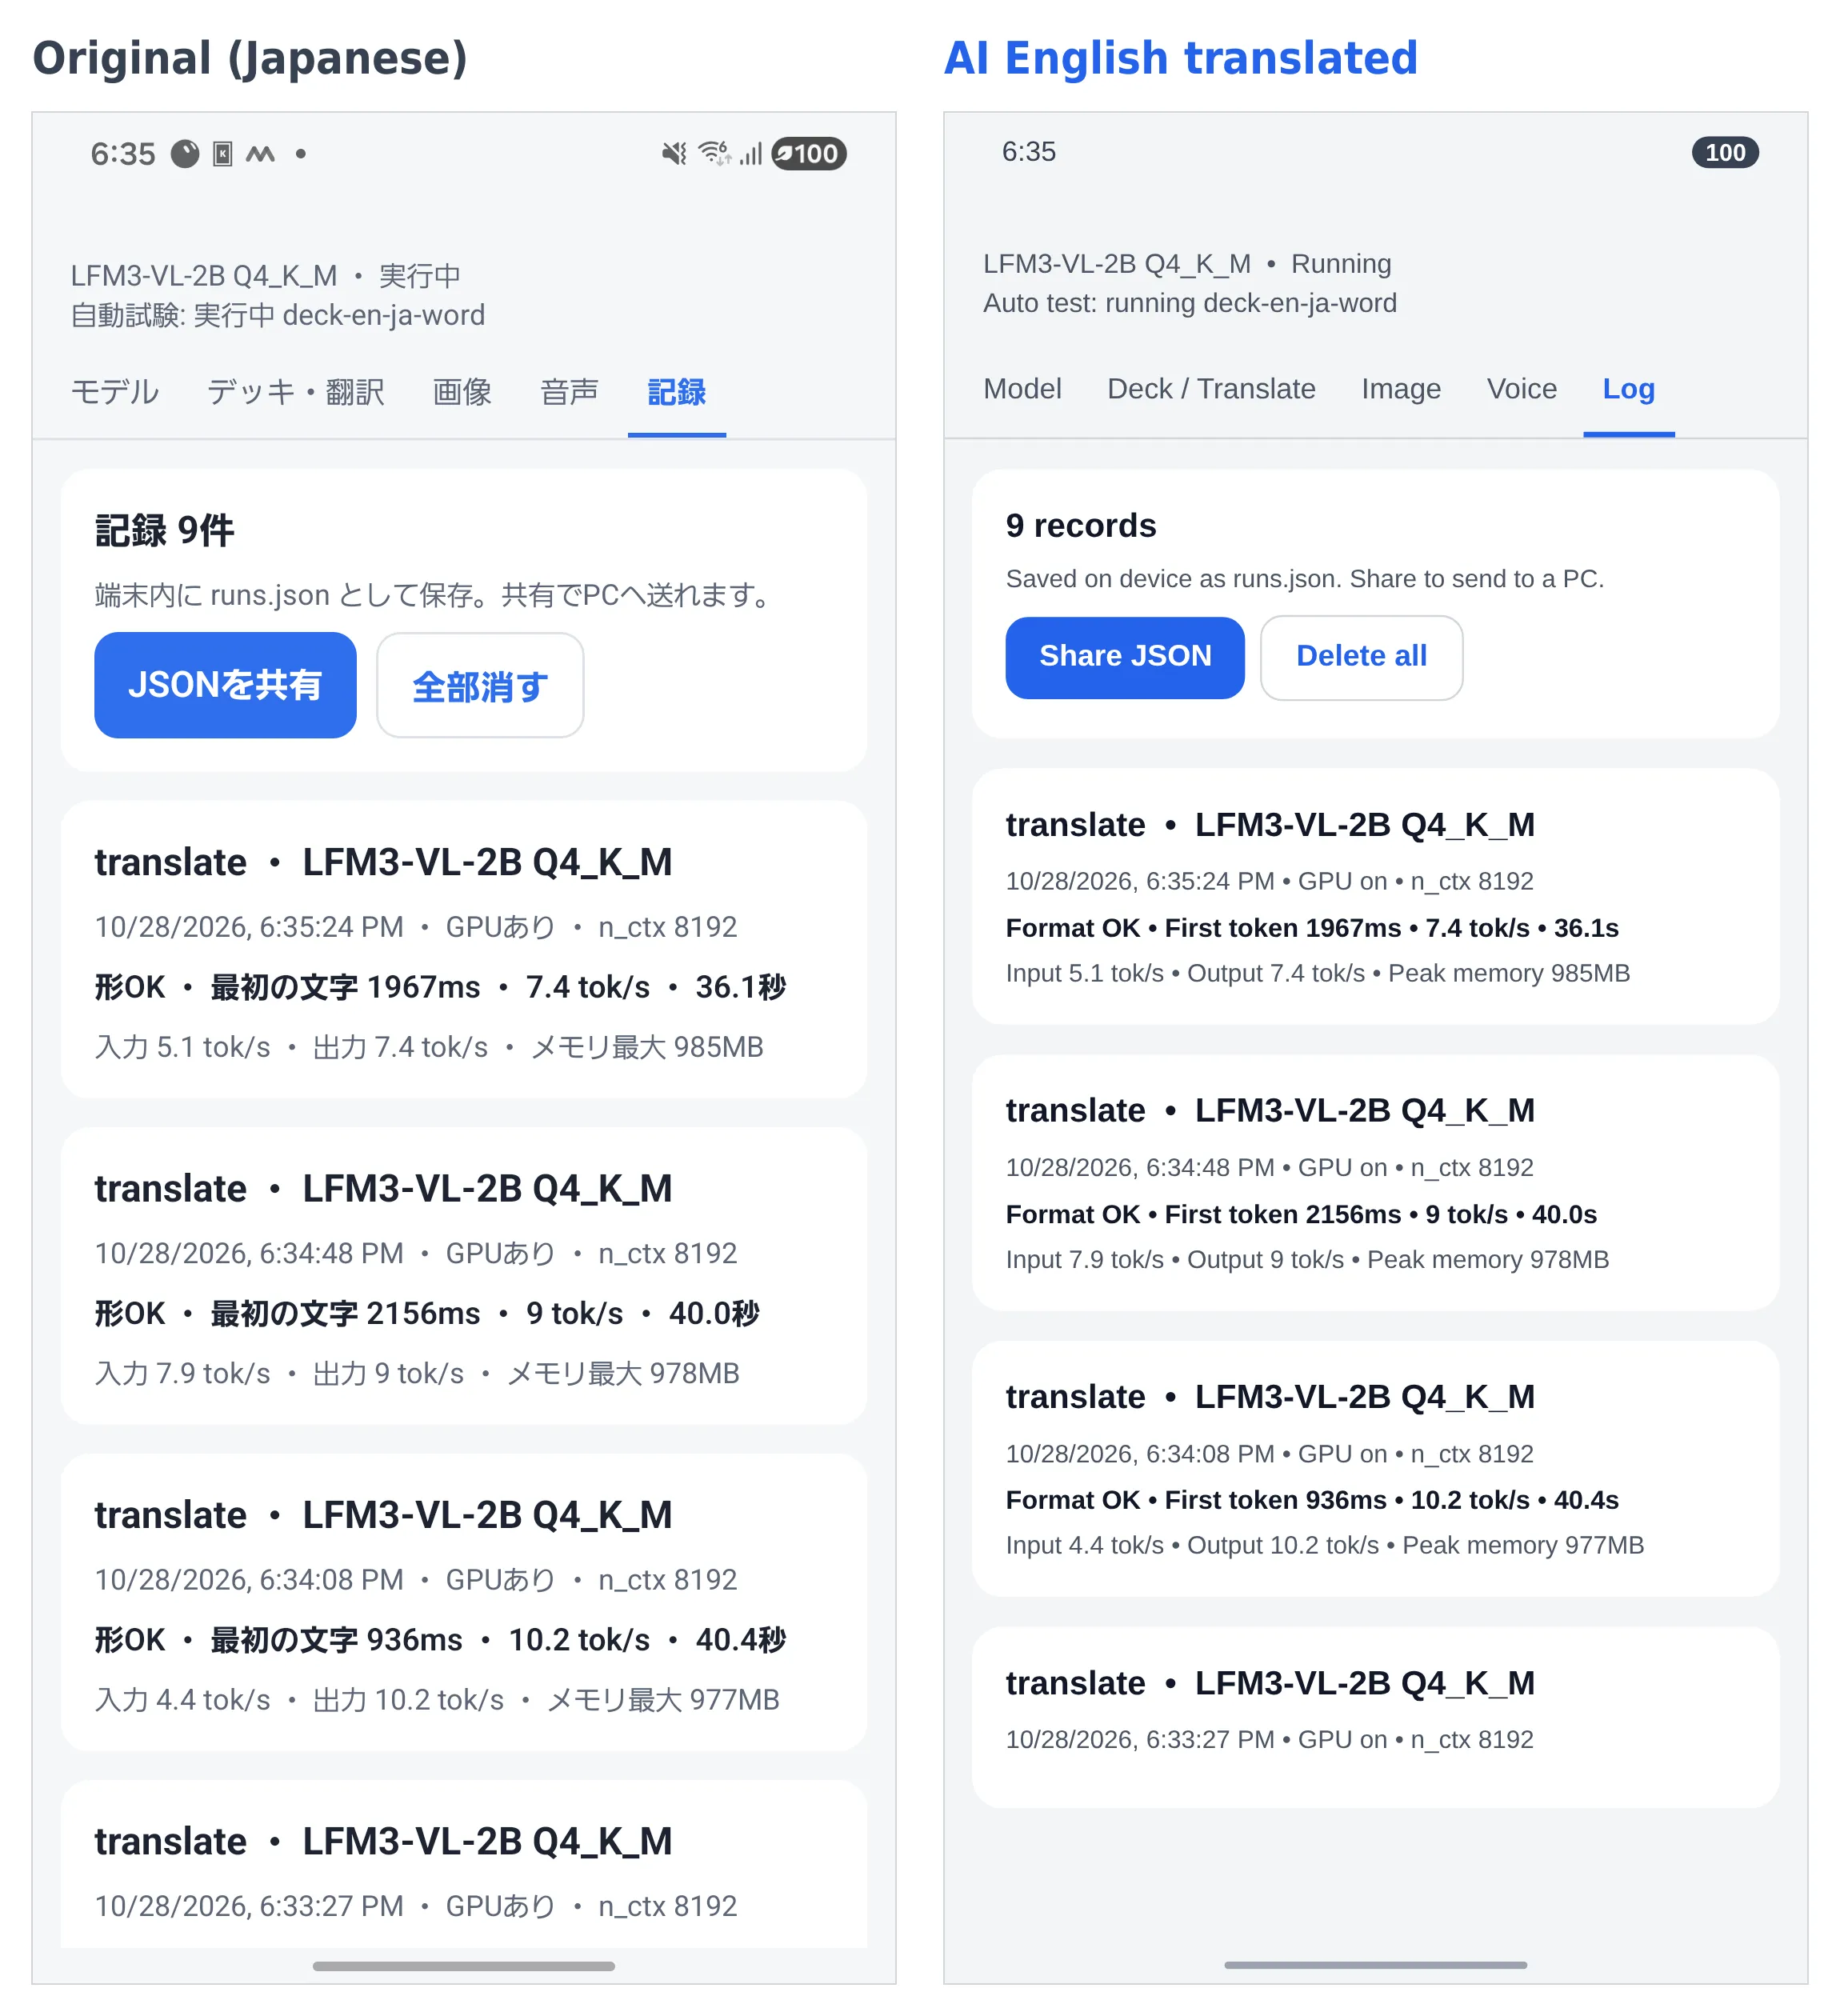
केवल CPU पर चलाना
अब तक के आँकड़े GPU पर चलाने से आए हैं। केवल CPU पर डेक बनाना तेज़ हुआ, 64.2 से 46.2 सेकंड, लेकिन मेमोरी का उपयोग बढ़ा और फ़ोन जल्दी गर्म हुआ।
| GPU | केवल CPU | |
|---|---|---|
| 10 शब्दों का डेक बनाने का समय | 64.2 s | 46.2 s |
| ऐप मेमोरी (चरम) | 1052MB | 1923MB |
| थर्मल स्थिति 3 तक पहुँचने का समय | लगभग 2 मिनट 35 सेकंड | लगभग 1 मिनट 35 सेकंड |
| SoC का चरम तापमान | 57.4℃ | 60.4℃ |
मेमोरी resident memory है और इसमें GPU पर रखे गए weights शामिल नहीं हैं।
समस्या 3: अनुवाद और पठन ग़लत हैं
मॉडल JSON प्रारूप का पालन करता है, लेकिन सामग्री में साफ़ दिखने वाली ग़लतियाँ हैं। फ़्लैशकार्ड ऐप में यह गंभीर समस्या है, क्योंकि सीखने वाले ग़लतियों को ज्यों का त्यों याद कर लेते हैं।
- जापानी पठन लगभग कभी सही नहीं थे। 空港 (हवाई अड्डा)
kū kōkunबन गया, और 荷物 (सामान)nagōबन गया। - अंग्रेज़ी से जापानी अनुवाद कभी-कभी जापानी बनने के बजाय रोमन लिपि में ही रह गए।
- उसने जर्मन वाक्य “Ich habe Hunger” को अंग्रेज़ी बताया।
- PC पर परखे गए कोरियाई से जापानी डेक में 10 में से केवल 1 कार्ड बना, और कोरियाई फ़ील्ड में जापानी था।
- 10 उदाहरण वाक्य माँगने पर वह GPU पर 2 कार्ड पर और केवल CPU पर 8 कार्ड पर रुक गया।
वही ग़लतियाँ PC पर भी आईं, इसलिए हम इसे मॉडल की सीमा मानते हैं। model card में बताए गए इच्छित उपयोग भी चित्र और दस्तावेज़ पढ़ने जैसी चीज़ें हैं, इसलिए अनुवाद और डेक बनाना शायद उसकी ताक़त हैं ही नहीं।
अन्य मॉडलों से तुलना
हमने फ़ोन पर Gemma 4 E2B और Qwen3.5-2B भी आज़माए।
| मॉडल | फ़ोन पर परिणाम |
|---|---|
| Gemma 4 E2B (Google, लगभग 3.1GB) | चारों बार लोड होते समय ऐप बंद हो गया |
| Qwen3.5-2B (लगभग 1.3GB) | चलता है, पर अनुवाद में 577.4 s लगे और डेक में 10 में से 1 से 2 कार्ड बने |
PC पर Gemma 4 E2B की गुणवत्ता कहीं बेहतर थी, जैसे 飛行機 (हवाई जहाज़) को सही ढंग से hikōki पढ़ना। लेकिन फ़ोन पर GPU सेटिंग के साथ वह लोड नहीं हुआ। पहले प्रयास के लॉग में दर्ज है कि Android ने मेमोरी की कमी से ऐप बंद कर दिया। हमने केवल CPU वाली सेटिंग नहीं आज़माई।
थिंकिंग मोड
हमने 1,024 token की सीमा के साथ थिंकिंग मोड भी आज़माया। उसने उत्तर दिए, लेकिन प्रोसेसिंग में लगभग 3.5 से 7 गुना समय लगा। 10 शब्दों का डेक 64.2 से बढ़कर 257.7 सेकंड का हो गया, और पठन तब भी ग़लत थे।
समस्या 4: वह पाठ पढ़ सकता है, पर हर इमेज में 20 से 80 सेकंड लगते हैं
तीनों फ़ीचर में पाठ पहचान सबसे आशाजनक थी। 4 परीक्षण इमेज में से 2 में उसने हर पंक्ति सही पढ़ी। लेकिन हर इमेज में 20 से 80 सेकंड लगते हैं।
| इमेज | सही पढ़ी गई पंक्तियाँ | समय |
|---|---|---|
| अंग्रेज़ी मेन्यू | 9 में से 4 | 77.7 s |
| जापानी स्टेशन साइन | 5 में से 5 | 38.4 s |
| कोरियाई मेन्यू | 5 में से 5 | 39.2 s |
| छोटा, धुंधला जापानी पाठ | 4 में से 3 | 18.6 s |
सभी इमेज इसी परीक्षण के लिए बनाई गई थीं। अंग्रेज़ी मेन्यू में उसने 5 पंक्तियों की क़ीमत छोड़ दी, और जापानी पाठ में 天ぷら को 天ぶら पढ़ा।
शुरू में हमने इमेज प्रोसेसिंग वाला हिस्सा GPU पर चलाया, और मेमोरी की कमी से ऐप क्रैश हो गया। उसे CPU पर ले जाने के बाद चारों इमेज अंत तक चलीं। लेकिन जब फ़ोन अनुवाद और डेक बनाने से पहले ही गर्म था, तो वही अंग्रेज़ी मेन्यू 122.6 सेकंड में हुआ।
हमने क्या सीखा
- फ़ोन पर मॉडल चलाना संभव है
- अनुवाद और डेक बनाना प्रतीक्षा समय और गुणवत्ता, दोनों में कमज़ोर पड़ते हैं
- पाठ पहचान गुणवत्ता में आशाजनक है, पर प्रतीक्षा लंबी है
- PC पर अच्छी गुणवत्ता वाला बड़ा मॉडल 7GB RAM वाले फ़ोन पर लोड न भी हो सकता है
निष्कर्ष: LangDict के लिए नहीं
मैंने तय किया कि Gemini API को कॉल करते रहना बेहतर उपयोगकर्ता अनुभव देता है। local LLM के साथ प्रतीक्षा लंबी थी और अनुवादों व पठनों में बहुत ग़लतियाँ थीं।
फिर भी मुझे लगा कि जहाँ नेटवर्क नहीं है, जैसे विमान में, वहीं तुरंत इसका उपयोग कर पाना भाषा-सीखने वाले ऐप के लिए एक वास्तविक लाभ होगा।
तकनीकी विवरण
उन पाठकों के लिए नोट जो तकनीकी विवरण चाहते हैं।
- मॉडल: LFM3-VL-2B Q4_K_M (1.10GB) और mmproj F16 (0.38GB)
- Runtime: Expo और llama.rn। हमने llama.cpp को LFM3 का समर्थन करने वाले संस्करण से बदला और llama.rn में JSON constraint का एक bug स्थानीय रूप से ठीक किया
- जनरेशन सेटिंग: temperature 0.1, top_k 50, repetition penalty 1.0। आधिकारिक सिफ़ारिश 1.1 है, पर हमने इसे बदला क्योंकि JSON बीच में रुक जाता था
- आउटपुट प्रारूप: JSON schema से निर्दिष्ट
- PC: RTX 2060 6GB, llama-server और Vulkan के साथ
स्रोत
2026-10-31 को जाँचे गए। गति, गर्मी और पाठ पहचान के सभी आँकड़े हमारे अपने मापे हुए हैं।
- LiquidAI/LFM3-VL-2B (आधिकारिक मॉडल विवरण)
- LiquidAI/LFM3-VL-2B-GGUF (हमने जो फ़ाइलें उपयोग कीं)