Faire tourner LFM3 sur un téléphone pour voir s'il peut remplacer les fonctions d'IA de LangDict
Nous avons testé si un local LLM, le petit modèle LFM3 de Liquid AI exécuté sur le téléphone lui-même, pouvait remplacer les fonctions d’IA de LangDict, une application d’apprentissage des langues que je développe.
Il fonctionne, mais après les tests, j’ai décidé de ne pas l’intégrer à l’application.
Ce que nous avons testé
LangDict est une application de cartes mémoire : on saisit les mots qu’on veut apprendre et l’IA génère des traductions, des phrases d’exemple et des prononciations. Elle utilise la Gemini API pour trois fonctions.
| Fonction | Ce qu’elle fait |
|---|---|
| Traduction | Traduit le texte saisi dans une autre langue |
| Génération de decks | Prend un thème comme “Travel at the airport” et crée un lot de cartes avec mots, traductions et lectures |
| Reconnaissance de texte | Transforme le texte d’une photo en texte modifiable (OCR) |
Nous avons testé si un local LLM pouvait les remplacer.
Nous avons examiné trois points :
- Si les trois fonctions tournent sur le téléphone
- Les temps d’attente et la vitesse en usage continu
- La qualité de la sortie
Conditions du test
| Élément | Détails |
|---|---|
| Téléphone | Téléphone Android (7GB de RAM) |
| Modèle | LFM3-VL-2B (environ 1,5GB avec mmproj) |
| Méthode | Une application de test utilisant les mêmes prompts que LangDict, mesurée pendant la charge |
| Exécutions | Une exécution par condition (variance non mesurée) |
Considérez les chiffres comme une indication. Les éléments également testés sur PC sont marqués « sur PC ».
Problème 1 : la première traduction se fige pendant environ 20 secondes
La première traduction après l’ouverture de l’application a mis 21,2 secondes à commencer à produire du texte, et l’écran semblait figé. La deuxième a démarré en 0,9 seconde.
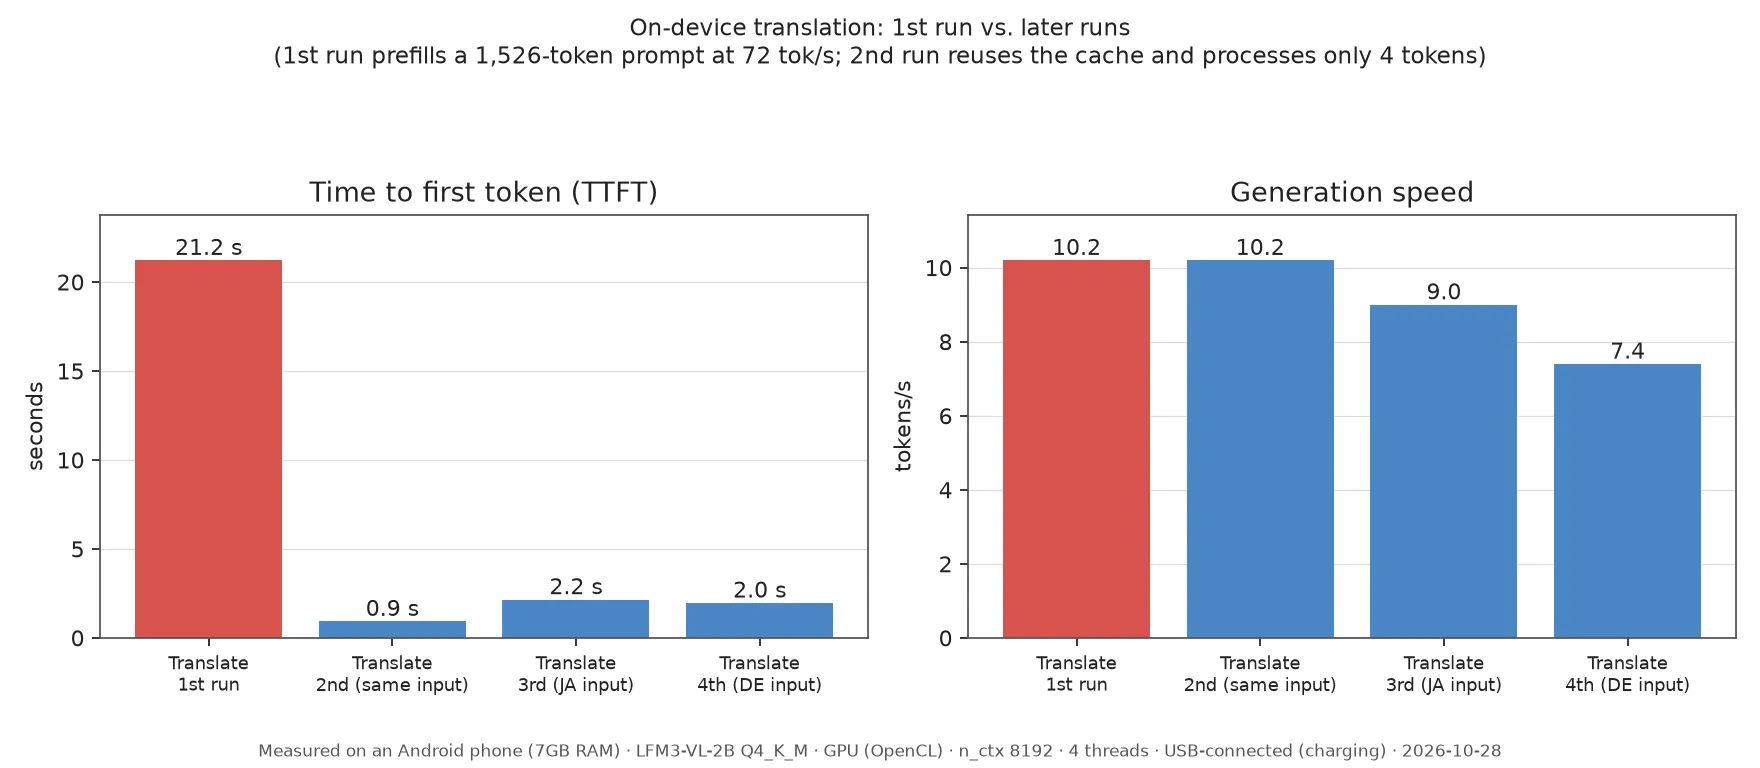
La cause est la longueur du prompt. Le prompt de traduction fait 1 526 tokens et le téléphone traite 72 tok/s ; sa seule lecture prend donc environ 20 secondes. La deuxième exécution est plus rapide parce que le cache entre en jeu.
Le prompt est quasiment fixe ; le pré-remplir à l’ouverture de l’écran pourrait donc raccourcir l’attente. Ce n’est qu’une idée, nous ne l’avons pas encore essayée.
Problème 2 : il ralentit à l’usage
Après quelques minutes d’utilisation, la chaleur réduit la vitesse de génération, et les tâches suivantes attendent plus longtemps.
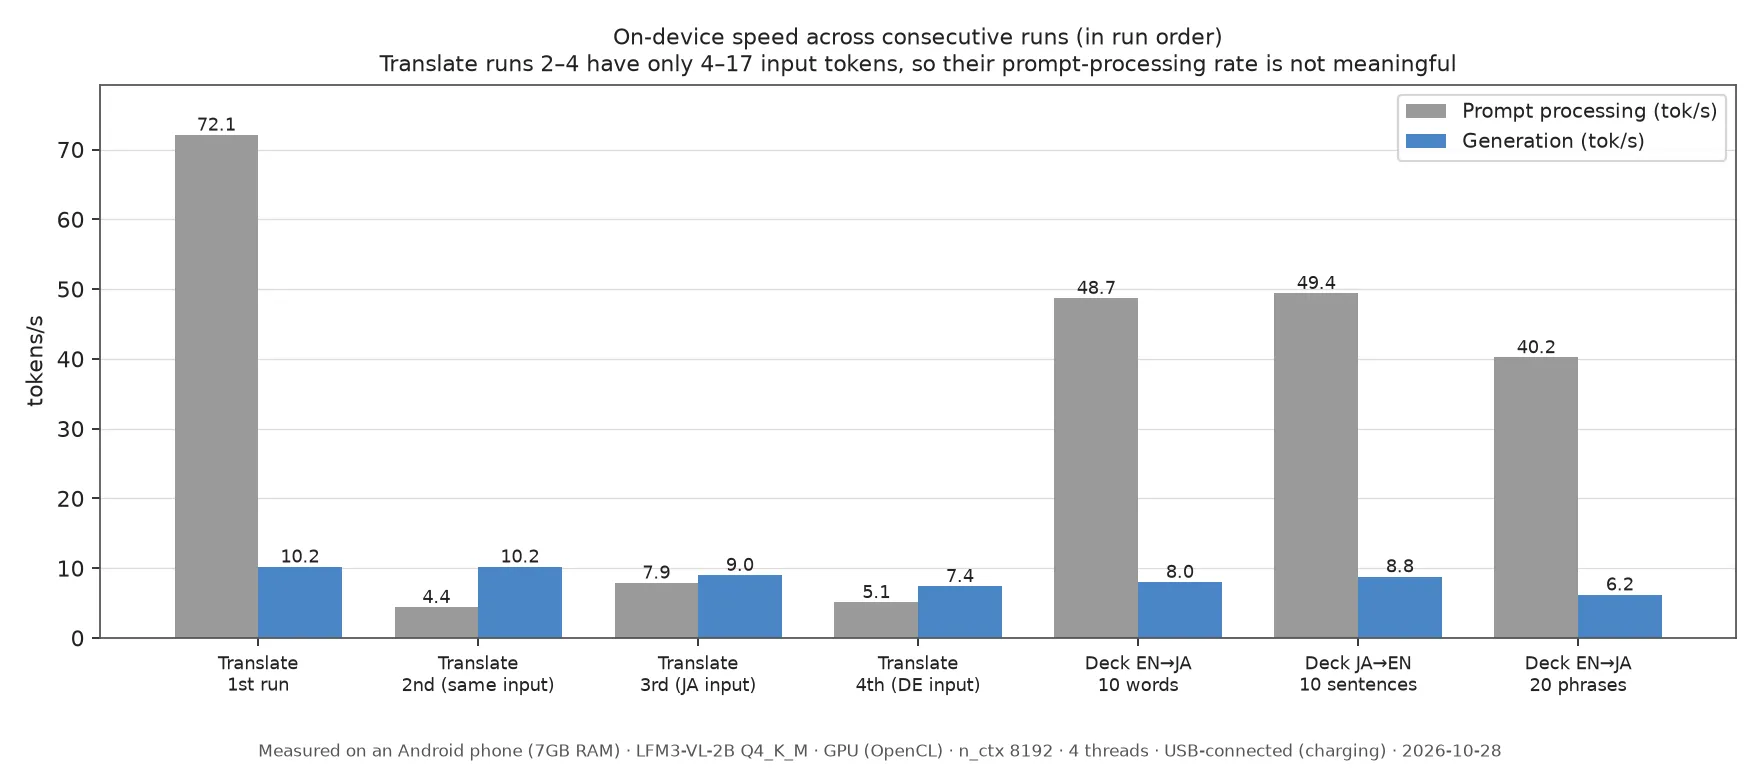
La vitesse de génération est passée de 10,2 tok/s à 6,2 tok/s. Un deck de 20 phrases a pris 156,3 secondes, et même un deck de 10 mots a pris 66,6 secondes.
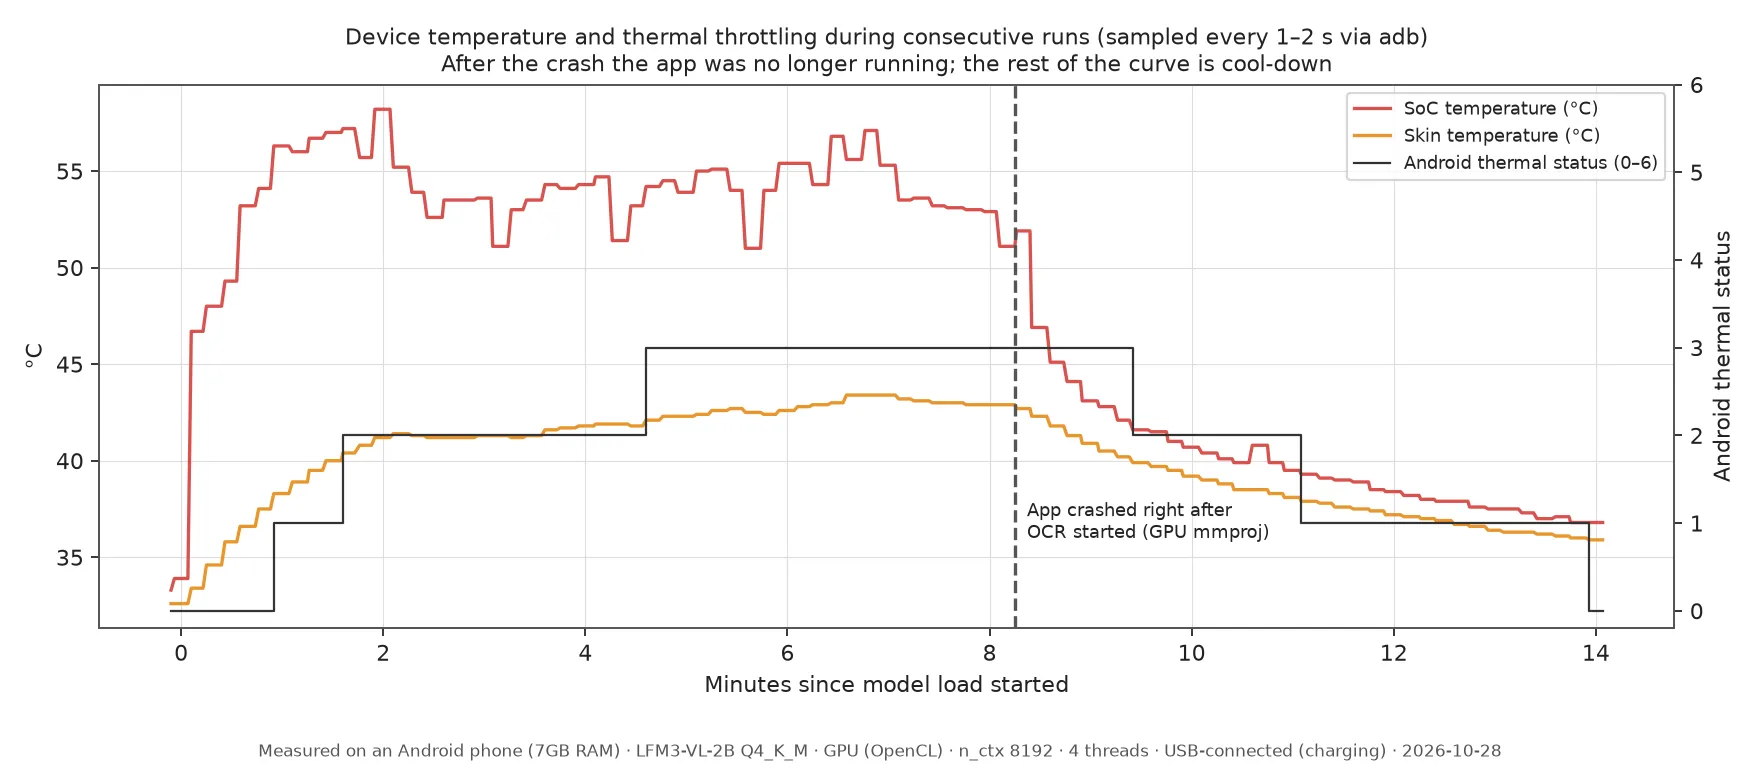
L’état thermique d’Android est monté à 1 après environ 1 minute, à 2 après environ 1,6 minute et à 3 après environ 4,6 minutes. La température baisse dans la seconde moitié du graphique parce que l’application a planté pendant le test d’images qui a suivi.
Exécution sur CPU seul
Les chiffres précédents proviennent d’une exécution sur GPU. Sur CPU seul, la génération d’un deck est devenue plus rapide, de 64,2 à 46,2 secondes, mais l’utilisation de la mémoire a augmenté et le téléphone a chauffé plus tôt.
| GPU | CPU seul | |
|---|---|---|
| Temps de génération d’un deck de 10 mots | 64,2 s | 46,2 s |
| Mémoire de l’application (pic) | 1052MB | 1923MB |
| Temps jusqu’à l’état thermique 3 | Environ 2 min 35 s | Environ 1 min 35 s |
| Température maximale du SoC | 57,4℃ | 60,4℃ |
La mémoire est la mémoire résidente et n’inclut pas les poids placés sur le GPU.
Problème 3 : les traductions et les lectures sont fausses
Le modèle respecte le format JSON, mais le contenu comporte des erreurs visibles. C’est un problème grave dans une application de cartes mémoire, car les apprenants retiennent les erreurs telles quelles.
- Les lectures du japonais n’étaient presque jamais correctes. 空港 (aéroport) est devenu
kū kōkun, et 荷物 (bagage) est devenunagō. - Les traductions de l’anglais vers le japonais restaient parfois en texte romanisé au lieu de devenir du japonais.
- Il a identifié comme de l’anglais la phrase allemande “Ich habe Hunger”.
- Un deck coréen vers japonais, testé sur PC, n’a produit qu’une carte sur 10, avec du japonais dans le champ coréen.
- Quand on lui demandait 10 phrases d’exemple, il s’est arrêté à 2 cartes sur GPU et à 8 sur CPU seul.
Les mêmes erreurs sont apparues sur PC ; nous y voyons donc une limite du modèle. Les usages prévus de la fiche du modèle concernent aussi la lecture d’images et de documents, de sorte que la traduction et la génération de decks ne sont peut-être tout simplement pas son point fort.
Comparaison avec d’autres modèles
Nous avons aussi essayé Gemma 4 E2B et Qwen3.5-2B sur le téléphone.
| Modèle | Résultat sur le téléphone |
|---|---|
| Gemma 4 E2B (Google, environ 3,1GB) | L’application a été arrêtée pendant le chargement les 4 fois |
| Qwen3.5-2B (environ 1,3GB) | Fonctionne, mais la traduction a pris 577,4 s et les decks ont produit 1 à 2 cartes sur 10 |
Sur PC, Gemma 4 E2B offrait une qualité bien meilleure, par exemple en lisant correctement 飛行機 (avion) comme hikōki. Sur le téléphone, en revanche, il ne se chargeait pas avec le réglage GPU. Le journal de la première tentative indique qu’Android a arrêté l’application par manque de mémoire. Nous n’avons pas essayé le réglage sur CPU seul.
Mode de réflexion
Nous avons aussi essayé le mode de réflexion avec une limite de 1 024 tokens. Il a renvoyé des réponses, mais le traitement a pris environ 3,5 à 7 fois plus de temps. Un deck de 10 mots est passé de 64,2 à 257,7 secondes, et les lectures étaient toujours fausses.
Problème 4 : il sait lire du texte, mais chaque image prend de 20 à 80 secondes
La reconnaissance de texte était la plus prometteuse des trois fonctions. Sur les 4 images de test, il a lu correctement toutes les lignes dans 2 cas. Cependant, chaque image prend de 20 à 80 secondes.
| Image | Lignes lues correctement | Temps |
|---|---|---|
| Menu en anglais | 4 sur 9 | 77,7 s |
| Panneau de gare en japonais | 5 sur 5 | 38,4 s |
| Menu en coréen | 5 sur 5 | 39,2 s |
| Petit texte japonais flou | 3 sur 4 | 18,6 s |
Toutes les images ont été créées pour ce test. Sur le menu en anglais, il a omis le prix sur 5 lignes, et dans le texte japonais, il a lu 天ぷら comme 天ぶら.
Au début, nous avons exécuté la partie traitement d’image sur le GPU, et l’application a planté par manque de mémoire. Après son passage sur le CPU, les 4 images ont été traitées jusqu’au bout. Mais lorsque le téléphone était déjà chaud après la traduction et la génération de decks, le même menu en anglais a pris 122,6 secondes.
Ce que nous avons appris
- Exécuter le modèle sur un téléphone est possible
- La traduction et la génération de decks sont insuffisantes, tant pour le temps d’attente que pour la qualité
- La reconnaissance de texte est prometteuse en qualité, mais l’attente est longue
- Un modèle plus grand, de bonne qualité sur PC, peut ne pas se charger sur un téléphone avec 7GB de RAM
Conclusion : pas pour LangDict
J’ai décidé que continuer à appeler la Gemini API offrait une meilleure expérience utilisateur. Avec le local LLM, les attentes étaient longues et les traductions et lectures comportaient beaucoup d’erreurs.
Cela dit, j’ai senti que pouvoir l’utiliser sur place, là où il n’y a pas de réseau, comme dans un avion, serait un vrai avantage pour une application d’apprentissage des langues.
Détails techniques
Notes pour les lecteurs qui veulent les détails techniques.
- Modèle : LFM3-VL-2B Q4_K_M (1,10GB) et mmproj F16 (0,38GB)
- Runtime : Expo et llama.rn. Nous avons remplacé llama.cpp par une version compatible avec LFM3 et corrigé localement un bug de contrainte JSON dans llama.rn
- Réglages de génération : temperature 0.1, top_k 50, repetition penalty 1.0. La recommandation officielle est 1.1, mais nous l’avons changée parce que le JSON avait tendance à s’arrêter en cours de route
- Format de sortie : spécifié avec un JSON schema
- PC : RTX 2060 6GB, avec llama-server et Vulkan
Sources
Vérifiées le 2026-10-31. Tous les chiffres de vitesse, de chaleur et de reconnaissance de texte sont nos propres mesures.
- LiquidAI/LFM3-VL-2B (description officielle du modèle)
- LiquidAI/LFM3-VL-2B-GGUF (les fichiers que nous avons utilisés)