在手机上运行 LFM3,看它能否替代 LangDict 的 AI 功能
我们测试了 local LLM,即在手机本机上运行的 Liquid AI 小型模型 LFM3,能否替代 LangDict 的 AI 功能。LangDict 是我开发的一款语言学习应用。
它可以运行,但经过测试,我决定不把它放进应用。
测试内容
LangDict 是一款闪卡应用:输入想学的单词,AI 会生成翻译、例句和读音。它在三个功能中使用 Gemini API。
| 功能 | 作用 |
|---|---|
| 翻译 | 将输入的文本翻译成另一种语言 |
| 卡组生成 | 根据“Travel at the airport”这样的主题,批量创建包含单词、翻译和读音的卡片 |
| 文字识别 | 将照片中的文字转换为可编辑的文本(OCR) |
我们测试了 local LLM 能否替代这些功能。
我们考察了三点:
- 三个功能能否都在手机上运行
- 连续使用时的等待时间和速度
- 输出质量
测试条件
| 项目 | 详情 |
|---|---|
| 手机 | Android 手机(7GB RAM) |
| 模型 | LFM3-VL-2B(含 mmproj 约 1.5GB) |
| 方法 | 使用与 LangDict 相同提示词的测试应用,在充电状态下测量 |
| 次数 | 每种条件运行一次(未测量方差) |
数值仅供参考。同时在 PC 上测试过的项目标注为“PC 上”。
问题 1:第一次翻译会卡住约 20 秒
打开应用后的第一次翻译,过了 21.2 秒才开始输出文字,画面看起来像是卡死了。第二次只用了 0.9 秒就开始输出。
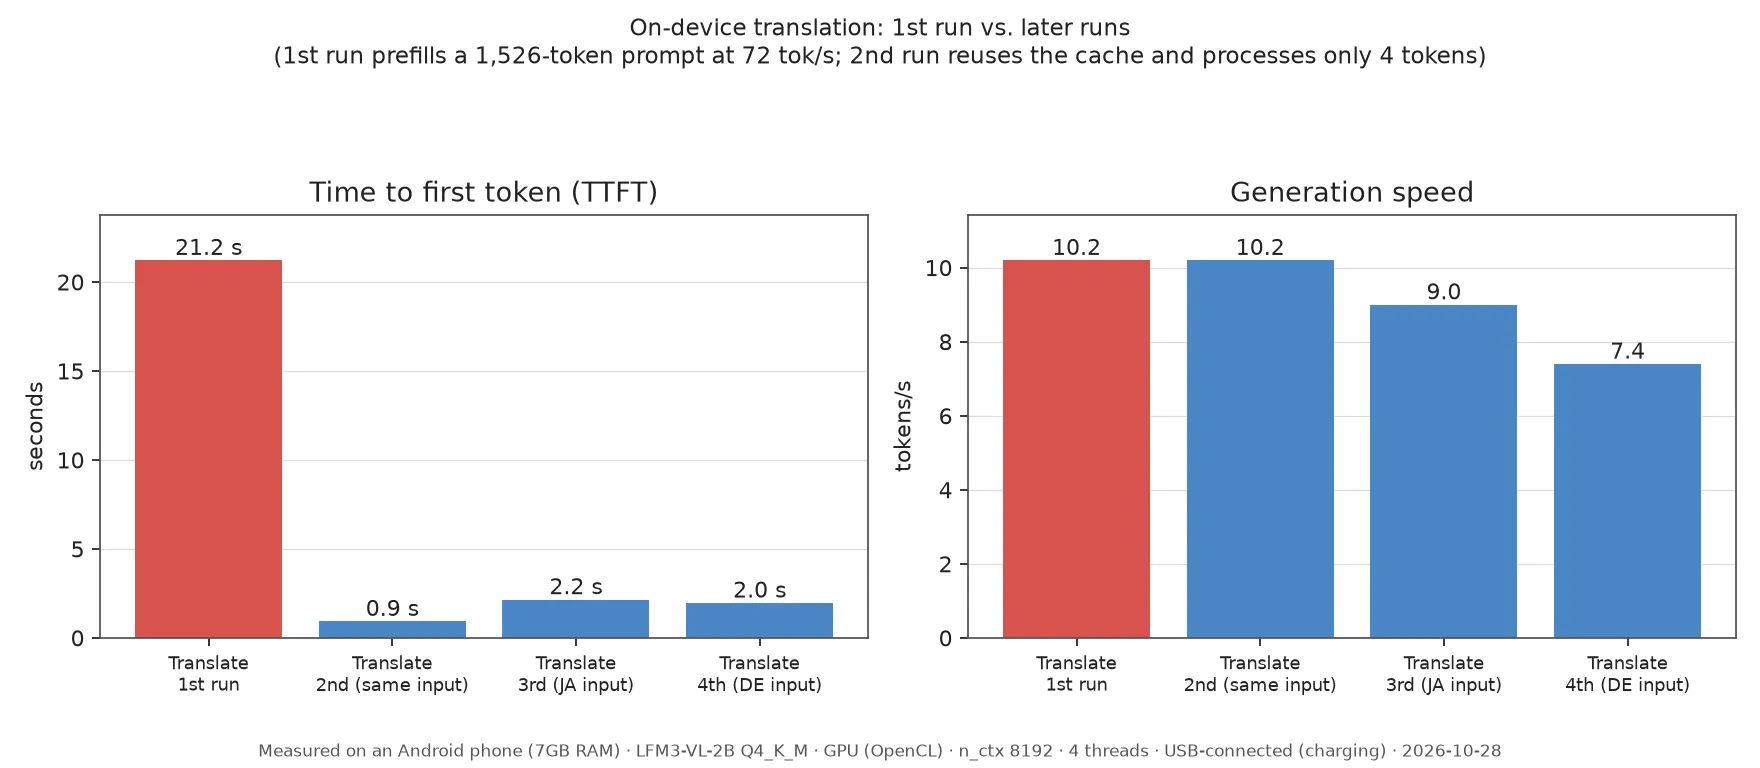
原因在于提示词的长度。翻译提示词有 1,526 个 token,而手机的处理速度是 72 tok/s,光读取它就要约 20 秒。第二次更快,是因为缓存生效了。
提示词几乎是固定的,所以在打开画面时预先处理它,也许能缩短等待。这只是一个想法,我们还没有尝试。
问题 2:持续使用会变慢
使用几分钟后,发热会降低生成速度,后面的任务等待时间更长。
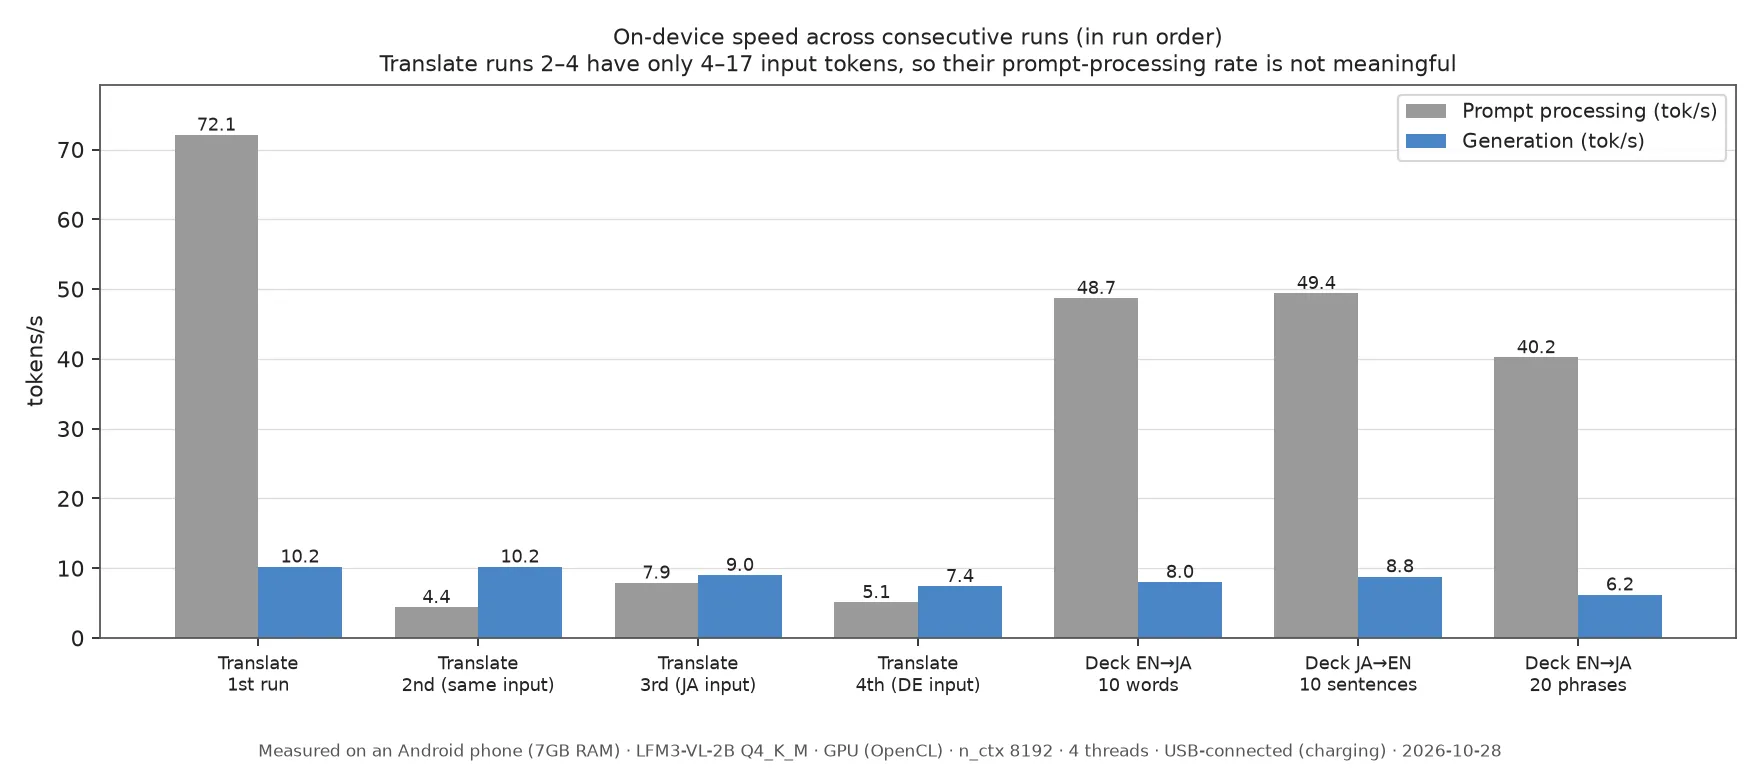
生成速度从 10.2 tok/s 降到 6.2 tok/s。生成 20 个短语的卡组用了 156.3 秒,即使是 10 个单词的卡组也用了 66.6 秒。
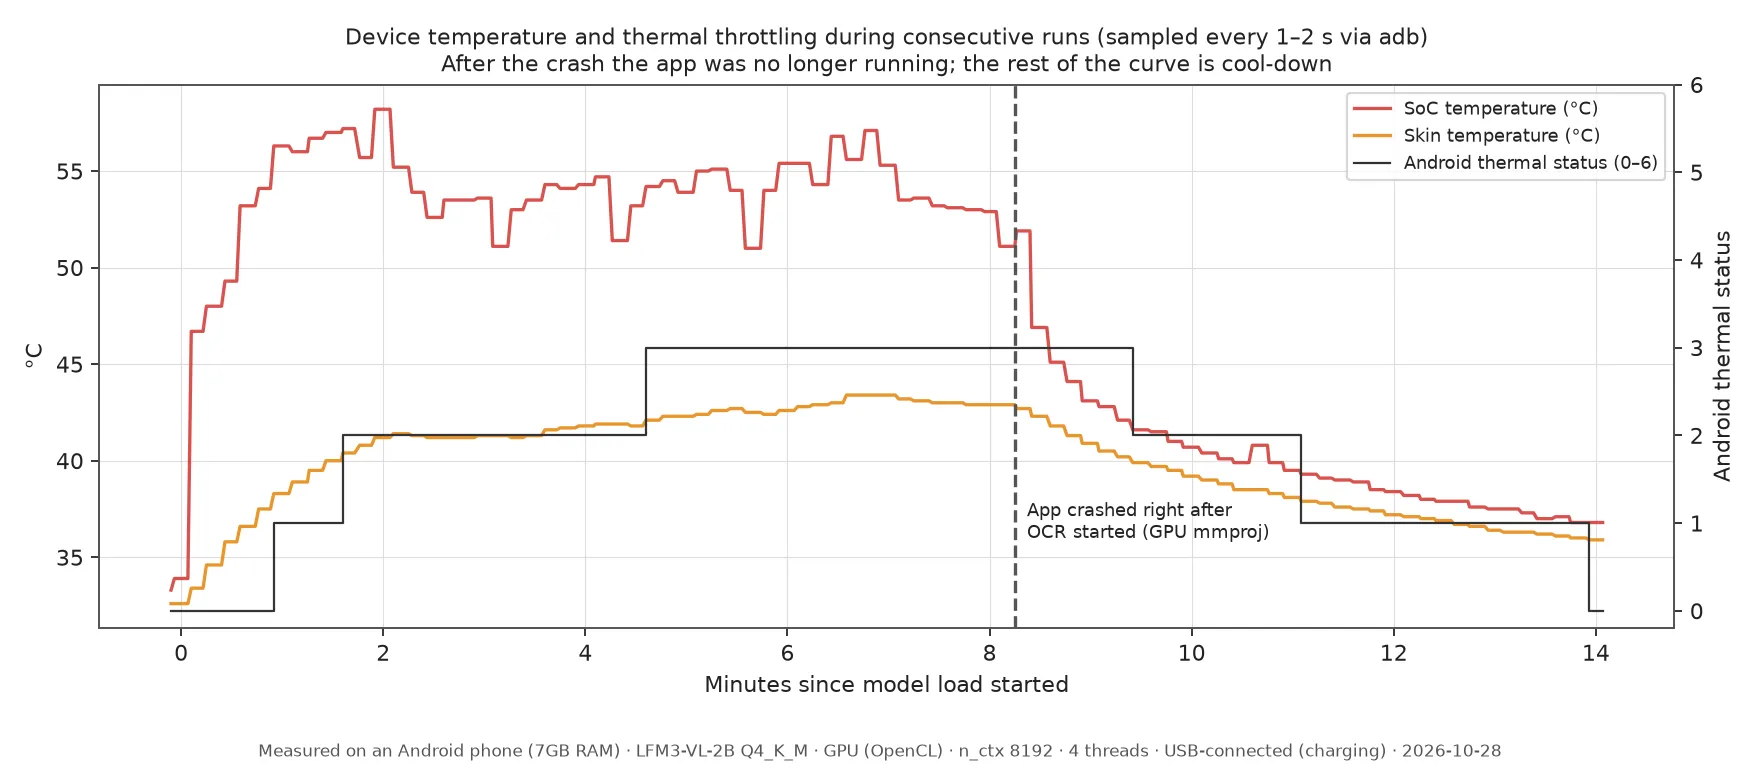
Android 的热状态约 1 分钟后升到 1,约 1.6 分钟后升到 2,约 4.6 分钟后升到 3。图的后半段温度下降,是因为应用在接下来的图像测试中崩溃了。
仅使用 CPU 运行
到目前为止的数值都是在 GPU 上运行得到的。仅用 CPU 时,卡组生成变快了,从 64.2 秒缩短到 46.2 秒,但内存占用增加,手机也更早发热。
| GPU | 仅 CPU | |
|---|---|---|
| 生成 10 个单词卡组的时间 | 64.2 s | 46.2 s |
| 应用内存(峰值) | 1052MB | 1923MB |
| 达到热状态 3 的时间 | 约 2 分 35 秒 | 约 1 分 35 秒 |
| SoC 峰值温度 | 57.4℃ | 60.4℃ |
内存为常驻内存,不包括放在 GPU 上的权重。
问题 3:翻译和读音有错误
模型能保持 JSON 格式,但内容有明显错误。这在闪卡应用中是严重的问题,因为学习者会把错误原样记住。
- 日语读音几乎没有正确的。空港(机场)变成了
kū kōkun,荷物(行李)变成了nagō。 - 英语到日语的翻译有时停留在罗马字,没有变成日语。
- 它把德语的 “Ich habe Hunger” 识别成了英语。
- 在 PC 上测试的韩语到日语卡组,10 张只生成了 1 张,且韩语字段里是日语。
- 要求生成 10 个例句时,GPU 上停在 2 张,仅 CPU 时停在 8 张。
PC 上也出现了同样的错误,所以我们认为这是模型本身的局限。模型卡中的预期用途也是读取图像和文档之类,翻译和卡组生成可能本来就不是它的强项。
与其他模型的比较
我们还在手机上试了 Gemma 4 E2B 和 Qwen3.5-2B。
| 模型 | 在手机上的结果 |
|---|---|
| Gemma 4 E2B(Google,约 3.1GB) | 4 次加载过程中应用都被终止 |
| Qwen3.5-2B(约 1.3GB) | 能运行,但翻译用了 577.4 秒,卡组 10 张只生成 1 到 2 张 |
在 PC 上,Gemma 4 E2B 的质量好得多,例如能正确读出飛行機(飞机)的读音 hikōki。但在手机上,使用 GPU 设置时它无法加载。第一次尝试的日志记录了 Android 因内存不足而终止应用。我们没有尝试仅用 CPU 的设置。
思考模式
我们还以 1,024 token 为上限试了思考模式。它能给出答案,但处理时间约为 3.5 到 7 倍。10 个单词的卡组从 64.2 秒变成 257.7 秒,读音仍然是错的。
问题 4:能读取文字,但每张图片要 20 到 80 秒
文字识别是三个功能中最有希望的。4 张测试图片中,有 2 张每一行都读对了。但是每张图片需要 20 到 80 秒。
| 图片 | 读对的行数 | 时间 |
|---|---|---|
| 英文菜单 | 9 行中的 4 行 | 77.7 s |
| 日语车站标识 | 5 行中的 5 行 | 38.4 s |
| 韩语菜单 | 5 行中的 5 行 | 39.2 s |
| 小而模糊的日语文字 | 4 行中的 3 行 | 18.6 s |
所有图片都是为本次测试制作的。在英文菜单上,它漏掉了 5 行的价格;在日语文字中,它把天ぷら读成了天ぶら。
起初我们让图像处理部分在 GPU 上运行,应用因内存不足而崩溃。改到 CPU 后,4 张图片都跑完了。但当手机已经因翻译和卡组生成而发热时,同一张英文菜单用了 122.6 秒。
我们学到了什么
- 在手机上运行模型是可行的
- 翻译和卡组生成在等待时间和质量上都不达标
- 文字识别在质量上有希望,但等待时间长
- 在 PC 上质量不错的更大模型,可能无法在 7GB RAM 的手机上加载
结论:不用于 LangDict
我认为继续调用 Gemini API 能带来更好的用户体验。使用 local LLM 时,等待时间长,翻译和读音错误很多。
不过我觉得,在没有网络的地方也能立即使用,比如在飞机上,对语言学习应用来说会是一个实实在在的好处。
技术细节
写给想了解技术细节的读者。
- 模型:LFM3-VL-2B Q4_K_M(1.10GB)和 mmproj F16(0.38GB)
- 运行时:Expo 和 llama.rn。我们将 llama.cpp 换成了支持 LFM3 的版本,并在本地修复了 llama.rn 中的 JSON 约束 bug
- 生成设置:temperature 0.1、top_k 50、repetition penalty 1.0。官方推荐值是 1.1,但由于 JSON 容易中途停止,我们做了改动
- 输出格式:用 JSON schema 指定
- PC:RTX 2060 6GB,使用 llama-server 和 Vulkan
来源
2026-10-31 确认。所有速度、发热和文字识别的数值均为我们自己的测量结果。
- LiquidAI/LFM3-VL-2B(官方模型说明)
- LiquidAI/LFM3-VL-2B-GGUF(我们使用的文件)