LFM3 på en telefon: kan den ersätta AI-funktionerna i LangDict?
Vi testade om ett local LLM, Liquid AI:s lilla LFM3-modell som körs på själva telefonen, kunde ersätta AI-funktionerna i LangDict, en språkinlärningsapp som jag utvecklar.
Den gick att köra, men efter testerna bestämde jag mig för att inte lägga in den i appen.
Vad vi testade
LangDict är en app med flashcards: du skriver in orden du vill lära dig och AI:n genererar översättningar, exempelmeningar och uttal. Den använder Gemini API för tre funktioner.
| Funktion | Vad den gör |
|---|---|
| Översättning | Översätter den inmatade texten till ett annat språk |
| Kortlekgenerering | Tar ett tema som “Travel at the airport” och skapar en omgång kort med ord, översättningar och läsningar |
| Textigenkänning | Gör om texten i ett foto till redigerbar text (OCR) |
Vi testade om ett local LLM kunde ersätta dessa.
Vi tittade på tre saker:
- Om alla tre funktionerna körs på telefonen
- Väntetider och hastighet vid kontinuerlig användning
- Utdatans kvalitet
Testförhållanden
| Punkt | Detaljer |
|---|---|
| Telefon | Android-telefon (7GB RAM) |
| Modell | LFM3-VL-2B (cirka 1,5GB inklusive mmproj) |
| Metod | En testapp med samma prompter som LangDict, mätt under laddning |
| Körningar | En körning per villkor (varians inte mätt) |
Se siffrorna som en fingervisning. Punkter som också testats på PC är markerade “på PC”.
Problem 1: den första översättningen fryser i cirka 20 sekunder
Den första översättningen efter att appen öppnats tog 21,2 sekunder innan text började produceras, och skärmen såg frusen ut. Den andra började efter 0,9 sekunder.
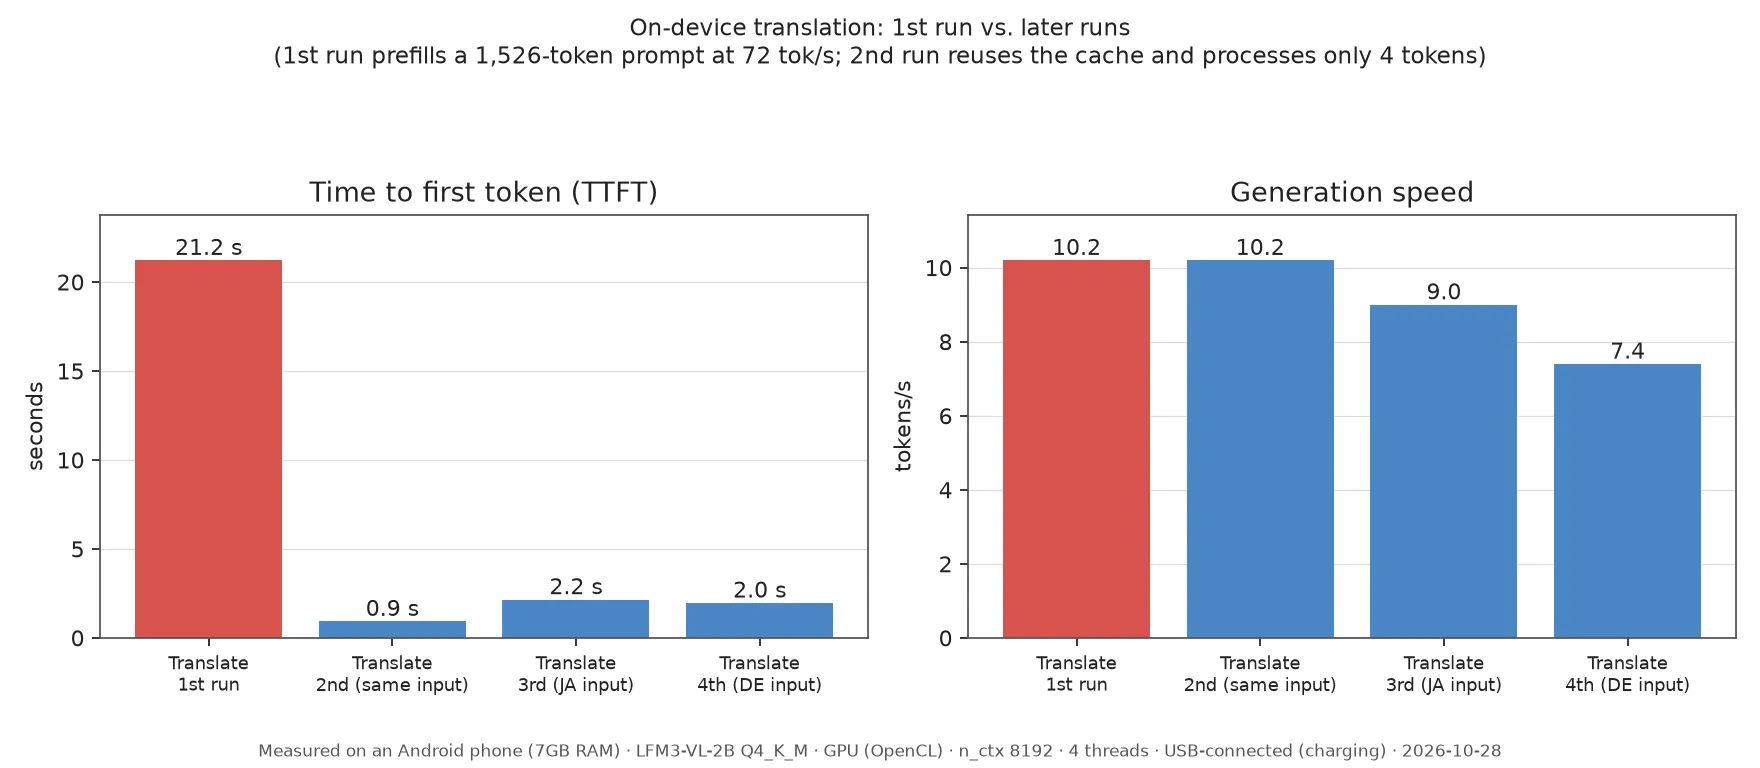
Orsaken var promptens längd. Översättningsprompten är 1 526 tokens och telefonen bearbetar 72 tok/s, så bara att läsa den tar cirka 20 sekunder. Den andra körningen går snabbare eftersom cachen slår in.
Prompten är nästan fast, så att göra en prefill av den när skärmen öppnas kan korta väntan. Det är bara en idé; vi har inte provat den än.
Problem 2: den blir långsammare vid fortsatt användning
Efter några minuters användning minskar värmen genereringshastigheten, så senare uppgifter får vänta längre.
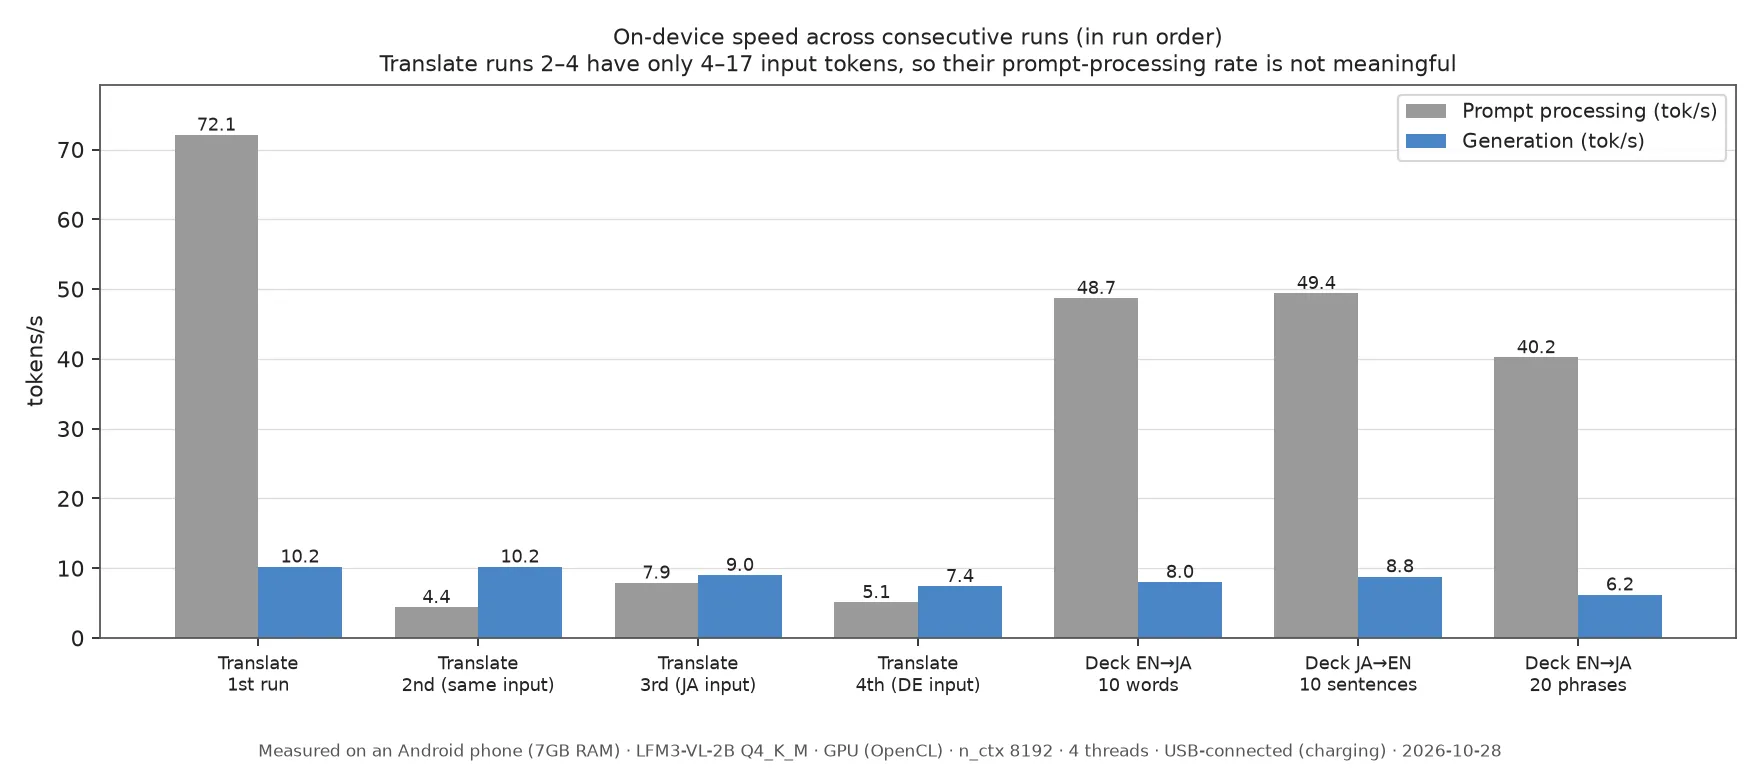
Genereringshastigheten föll från 10,2 tok/s till 6,2 tok/s. En kortlek med 20 fraser tog 156,3 sekunder, och till och med en kortlek med 10 ord tog 66,6 sekunder.
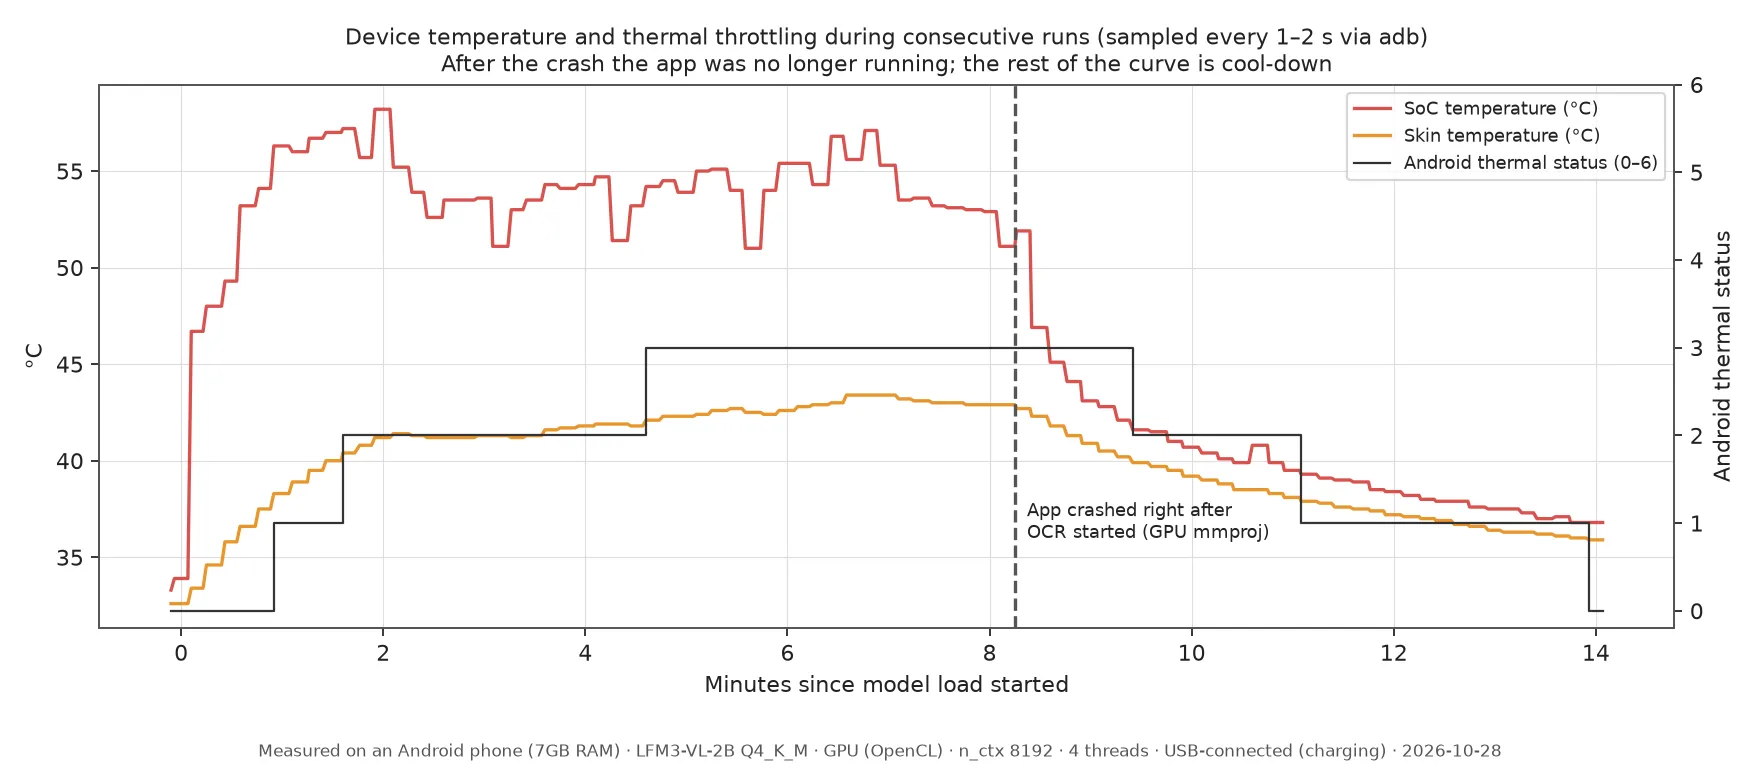
Androids termiska status steg till 1 efter cirka 1 minut, till 2 efter cirka 1,6 minuter och till 3 efter cirka 4,6 minuter. Temperaturen sjunker i grafens andra hälft eftersom appen kraschade under bildtestet som följde.
Körning enbart på CPU
Siffrorna hittills kommer från körning på GPU. Enbart på CPU gick kortlekgenereringen snabbare, från 64,2 till 46,2 sekunder, men minnesanvändningen ökade och telefonen blev varm tidigare.
| GPU | Enbart CPU | |
|---|---|---|
| Tid för att generera en kortlek med 10 ord | 64,2 s | 46,2 s |
| Appminne (topp) | 1052MB | 1923MB |
| Tid till termisk status 3 | Cirka 2 min 35 s | Cirka 1 min 35 s |
| Högsta SoC-temperatur | 57,4℃ | 60,4℃ |
Minnet är resident minne och inkluderar inte vikterna som placerats på GPU:n.
Problem 3: översättningar och läsningar är fel
Modellen håller sig till JSON-formatet, men innehållet har tydliga fel. Det är ett allvarligt problem i en flashcard-app, eftersom den som lär sig memorerar felen som de är.
- Japanska läsningar var nästan aldrig rätt. 空港 (flygplats) blev
kū kōkunoch 荷物 (bagage) blevnagō. - Översättningar från engelska till japanska blev ibland kvar som romaniserad text i stället för japanska.
- Den identifierade tyskans “Ich habe Hunger” som engelska.
- En kortlek från koreanska till japanska, testad på PC, gav bara 1 kort av 10, med japanska i det koreanska fältet.
- När den ombads om 10 exempelmeningar stannade den på 2 kort på GPU och 8 enbart på CPU.
Samma fel dök upp på PC, så vi ser det som en begränsning hos modellen. Modellkortets avsedda användningsområden är också sådant som att läsa bilder och dokument, så översättning och kortlekgenerering kanske helt enkelt inte är dess styrka.
Jämförelse med andra modeller
Vi provade också Gemma 4 E2B och Qwen3.5-2B på telefonen.
| Modell | Resultat på telefonen |
|---|---|
| Gemma 4 E2B (Google, cirka 3,1GB) | Appen avslutades under inläsningen alla 4 gånger |
| Qwen3.5-2B (cirka 1,3GB) | Kör, men översättningen tog 577,4 s och kortlekar gav 1 till 2 kort av 10 |
På PC höll Gemma 4 E2B mycket bättre kvalitet och läste till exempel 飛行機 (flygplan) rätt som hikōki. På telefonen gick den dock inte att läsa in med GPU-inställningen. Loggen från det första försöket visar att Android avslutade appen på grund av minnesbrist. Vi provade inte inställningen enbart med CPU.
Tänkande läge
Vi provade också tänkande läge med en gräns på 1 024 tokens. Det gav svar, men bearbetningen tog cirka 3,5 till 7 gånger längre tid. En kortlek med 10 ord gick från 64,2 till 257,7 sekunder, och läsningarna var fortfarande fel.
Problem 4: den kan läsa text, men varje bild tar 20 till 80 sekunder
Textigenkänning var den mest lovande av de tre funktionerna. Av de 4 testbilderna läste den varje rad rätt i 2. Men varje bild tar 20 till 80 sekunder.
| Bild | Rätt lästa rader | Tid |
|---|---|---|
| Engelsk meny | 4 av 9 | 77,7 s |
| Japansk stationsskylt | 5 av 5 | 38,4 s |
| Koreansk meny | 5 av 5 | 39,2 s |
| Liten, suddig japansk text | 3 av 4 | 18,6 s |
Alla bilder gjordes för det här testet. På den engelska menyn utelämnade den priset på 5 rader, och i den japanska texten läste den 天ぷら som 天ぶら.
Först körde vi bildbearbetningsdelen på GPU:n, och appen kraschade av minnesbrist. Efter flytten till CPU:n kördes alla 4 bilderna till slut. Men när telefonen redan var varm av översättning och kortlekgenerering tog samma engelska meny 122,6 sekunder.
Vad vi lärde oss
- Det går att köra modellen på en telefon
- Översättning och kortlekgenerering räcker inte till, varken i väntetid eller kvalitet
- Textigenkänning är lovande i kvalitet, men väntan är lång
- En större modell som har bra kvalitet på PC kanske inte går att läsa in på en telefon med 7GB RAM
Slutsats: inte för LangDict
Jag bestämde mig för att det ger en bättre användarupplevelse att fortsätta anropa Gemini API. Med det local LLM var väntetiderna långa och översättningarna och läsningarna hade många fel.
Med det sagt kände jag att möjligheten att använda det på stående fot där det inte finns något nätverk, till exempel på ett flygplan, skulle vara en verklig fördel för en språkinlärningsapp.
Tekniska detaljer
Anteckningar för läsare som vill ha de tekniska detaljerna.
- Modell: LFM3-VL-2B Q4_K_M (1,10GB) och mmproj F16 (0,38GB)
- Runtime: Expo och llama.rn. Vi bytte ut llama.cpp mot en version som stöder LFM3 och rättade lokalt en bugg med JSON-begränsningar i llama.rn
- Genereringsinställningar: temperature 0.1, top_k 50, repetition penalty 1.0. Den officiella rekommendationen är 1.1, men vi ändrade den eftersom JSON tenderade att avbrytas halvvägs
- Utdataformat: angivet med ett JSON schema
- PC: RTX 2060 6GB, med llama-server och Vulkan
Källor
Kontrollerade 2026-10-31. Alla siffror för hastighet, värme och textigenkänning är våra egna mätningar.
- LiquidAI/LFM3-VL-2B (officiell modellbeskrivning)
- LiquidAI/LFM3-VL-2B-GGUF (filerna vi använde)