LFM3 auf einem Smartphone ausgeführt, um zu prüfen, ob es die KI-Funktionen von LangDict ersetzen kann
Wir haben getestet, ob ein local LLM, das kleine LFM3-Modell von Liquid AI, das direkt auf dem Smartphone läuft, die KI-Funktionen von LangDict ersetzen kann, einer Sprachlern-App, die ich entwickle.
Es lief, aber nach den Tests habe ich entschieden, es nicht in die App einzubauen.
Was wir getestet haben
LangDict ist eine Karteikarten-App: Man gibt die Wörter ein, die man lernen möchte, und die KI erzeugt Übersetzungen, Beispielsätze und Aussprachen. Sie nutzt die Gemini API für drei Funktionen.
| Funktion | Was sie tut |
|---|---|
| Übersetzung | Übersetzt den eingegebenen Text in eine andere Sprache |
| Deck-Erstellung | Nimmt ein Thema wie “Travel at the airport” und erstellt einen Stapel Karten mit Wörtern, Übersetzungen und Lesungen |
| Texterkennung | Wandelt den Text auf einem Foto in bearbeitbaren Text um (OCR) |
Wir haben getestet, ob ein local LLM diese ersetzen kann.
Wir haben drei Dinge betrachtet:
- Ob alle drei Funktionen auf dem Smartphone laufen
- Wartezeiten und Geschwindigkeit bei Dauerbetrieb
- Ausgabequalität
Testbedingungen
| Punkt | Details |
|---|---|
| Smartphone | Android-Smartphone (7GB RAM) |
| Modell | LFM3-VL-2B (etwa 1,5GB inklusive mmproj) |
| Methode | Eine Test-App mit denselben Prompts wie LangDict, gemessen beim Laden |
| Durchläufe | Ein Durchlauf pro Bedingung (Varianz nicht gemessen) |
Die Zahlen sind als Richtwert zu verstehen. Punkte, die auch auf einem PC getestet wurden, sind mit “auf dem PC” gekennzeichnet.
Problem 1: Die erste Übersetzung friert etwa 20 Sekunden lang ein
Die erste Übersetzung nach dem Öffnen der App brauchte 21,2 Sekunden, bis Text erschien, und der Bildschirm wirkte eingefroren. Die zweite begann nach 0,9 Sekunden.
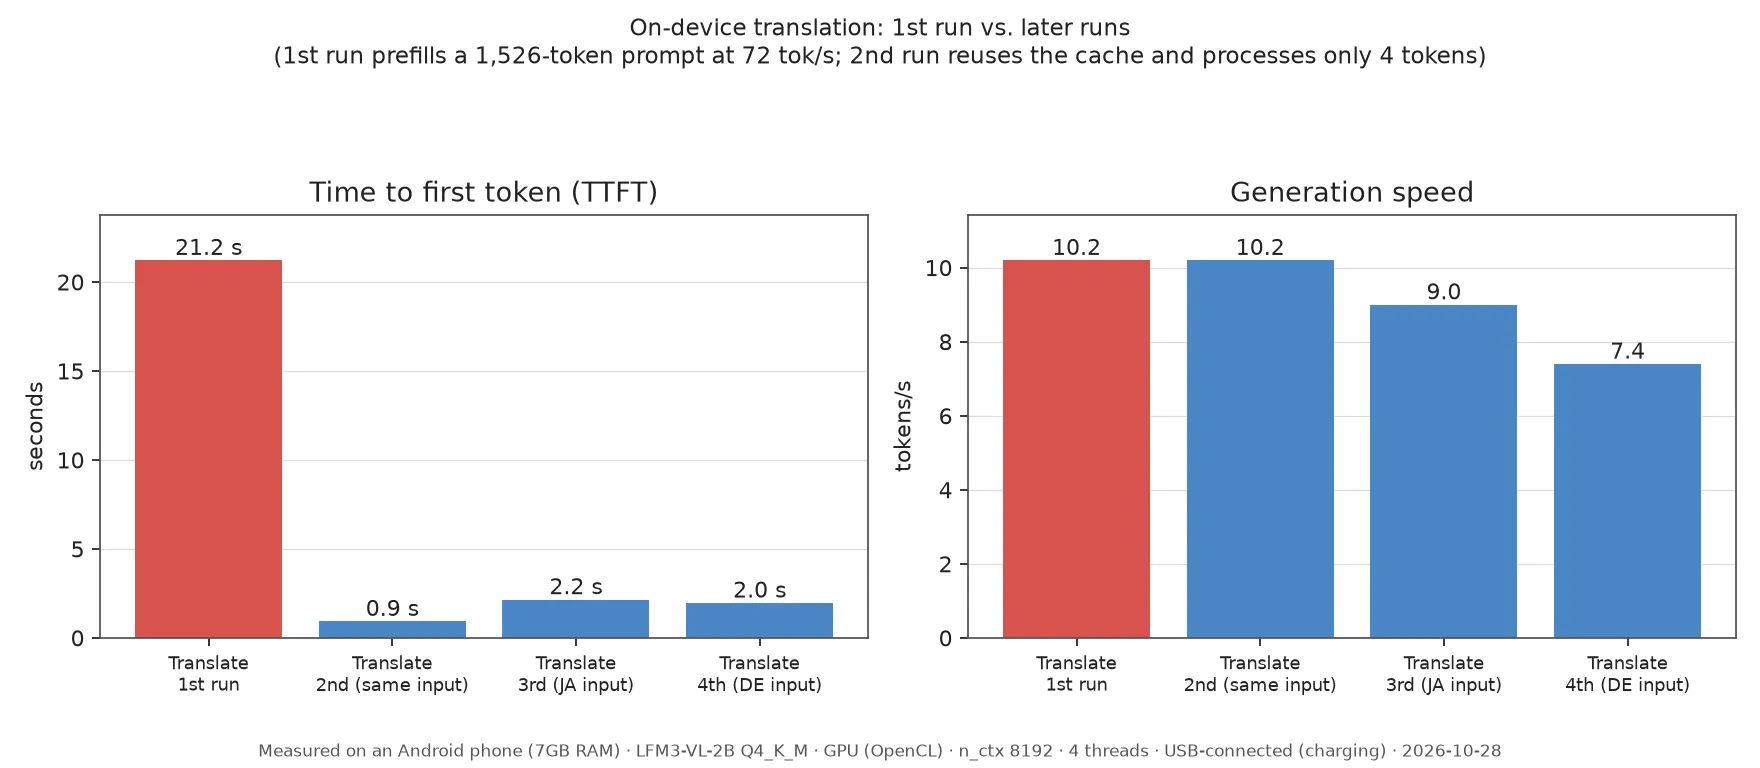
Die Ursache war die Länge des Prompts. Der Übersetzungs-Prompt hat 1.526 Tokens, und das Smartphone verarbeitet 72 tok/s, allein das Lesen dauert also etwa 20 Sekunden. Der zweite Durchlauf ist schneller, weil der Cache greift.
Der Prompt ist nahezu fest, daher könnte ein Prefill beim Öffnen des Bildschirms die Wartezeit verkürzen. Das ist nur eine Idee; wir haben es noch nicht ausprobiert.
Problem 2: Bei fortgesetzter Nutzung wird es langsamer
Nach einigen Minuten Nutzung senkt die Wärme die Generierungsgeschwindigkeit, sodass spätere Aufgaben länger warten.
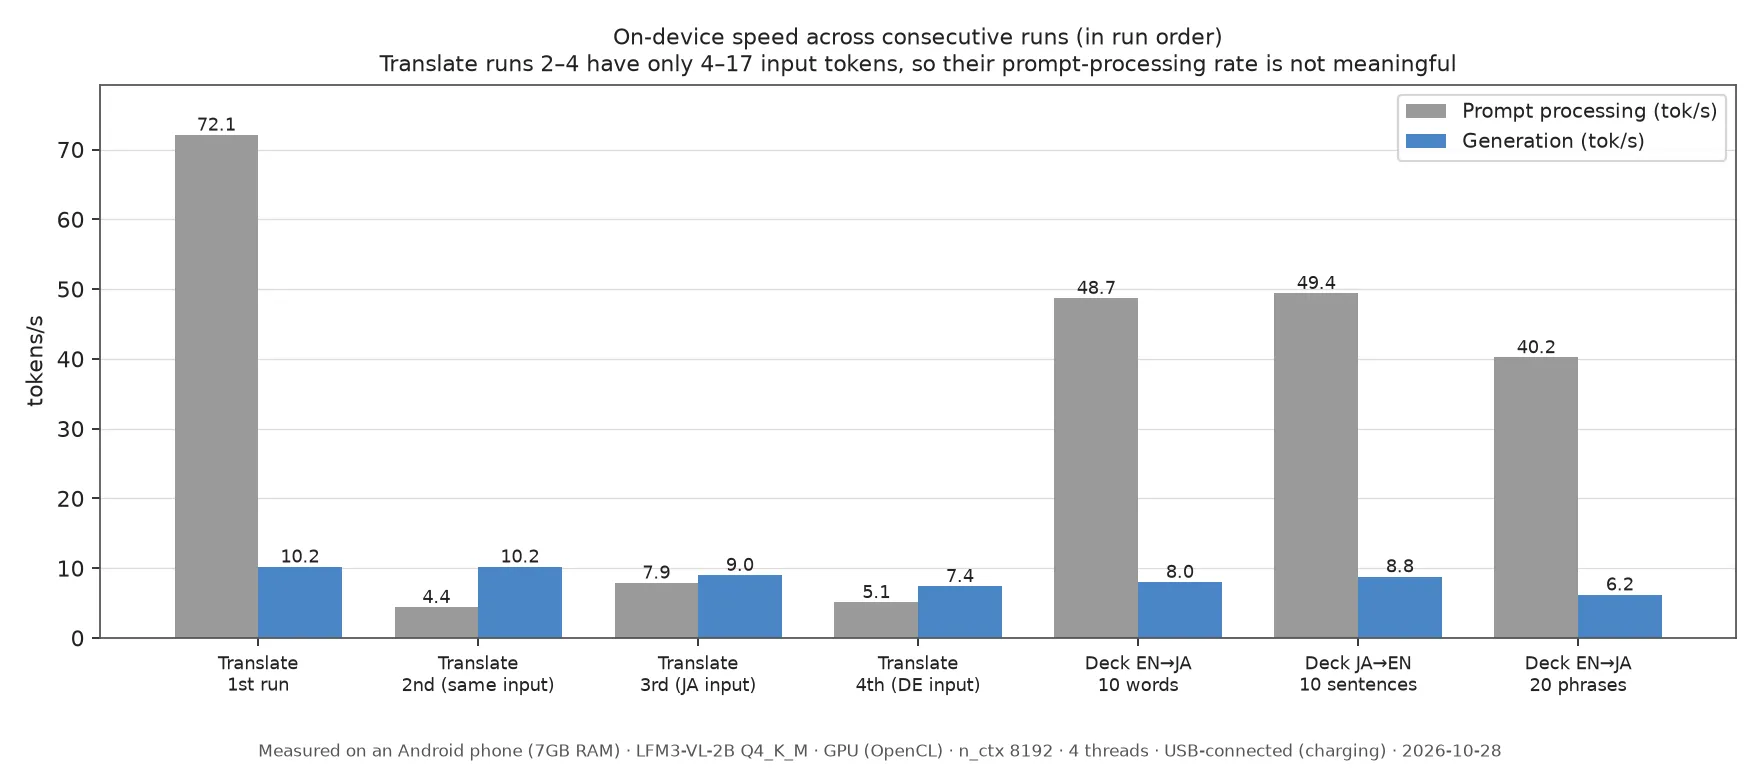
Die Generierungsgeschwindigkeit fiel von 10,2 tok/s auf 6,2 tok/s. Ein Deck mit 20 Wendungen brauchte 156,3 Sekunden, und selbst ein Deck mit 10 Wörtern brauchte 66,6 Sekunden.
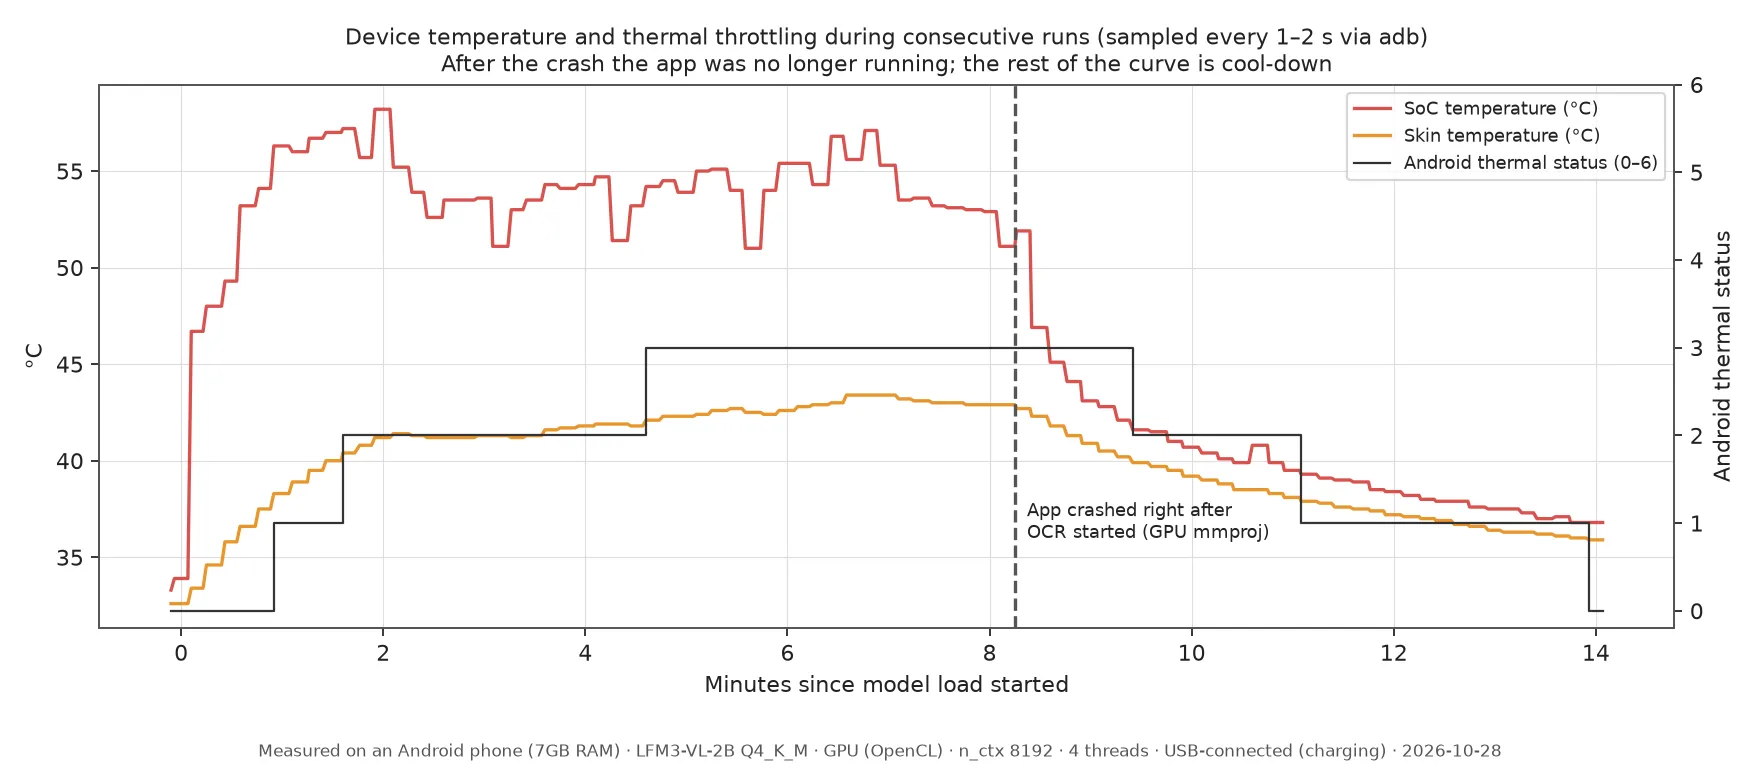
Der thermische Status von Android stieg nach etwa 1 Minute auf 1, nach etwa 1,6 Minuten auf 2 und nach etwa 4,6 Minuten auf 3. Die Temperatur sinkt in der zweiten Hälfte der Grafik, weil die App beim darauffolgenden Bildtest abgestürzt ist.
Ausführung nur auf der CPU
Die bisherigen Zahlen stammen aus der Ausführung auf der GPU. Nur auf der CPU wurde die Deck-Erstellung schneller, von 64,2 auf 46,2 Sekunden, aber der Speicherverbrauch stieg und das Smartphone erwärmte sich früher.
| GPU | Nur CPU | |
|---|---|---|
| Zeit für die Erstellung eines Decks mit 10 Wörtern | 64,2 s | 46,2 s |
| App-Speicher (Spitze) | 1052MB | 1923MB |
| Zeit bis zum thermischen Status 3 | Etwa 2 min 35 s | Etwa 1 min 35 s |
| Maximale SoC-Temperatur | 57,4℃ | 60,4℃ |
Der Speicher ist der residente Speicher und enthält nicht die auf der GPU abgelegten Gewichte.
Problem 3: Übersetzungen und Lesungen sind falsch
Das Modell hält das JSON-Format ein, aber der Inhalt weist deutliche Fehler auf. Das ist in einer Karteikarten-App ein ernstes Problem, weil Lernende die Fehler so auswendig lernen, wie sie sind.
- Japanische Lesungen waren fast nie korrekt. 空港 (Flughafen) wurde zu
kū kōkun, und 荷物 (Gepäck) wurde zunagō. - Übersetzungen vom Englischen ins Japanische blieben manchmal in romanisiertem Text, statt zu Japanisch zu werden.
- Es erkannte das deutsche “Ich habe Hunger” als Englisch.
- Ein Deck Koreanisch-Japanisch, auf dem PC getestet, ergab nur 1 Karte von 10, mit Japanisch im koreanischen Feld.
- Bei der Aufforderung, 10 Beispielsätze zu erzeugen, hörte es auf der GPU bei 2 Karten und nur auf der CPU bei 8 auf.
Auf dem PC traten dieselben Fehler auf, deshalb sehen wir darin eine Grenze des Modells. Die vorgesehenen Einsatzzwecke auf der Model Card sind ebenfalls Dinge wie das Lesen von Bildern und Dokumenten, sodass Übersetzung und Deck-Erstellung möglicherweise einfach nicht seine Stärke sind.
Vergleich mit anderen Modellen
Wir haben auf dem Smartphone auch Gemma 4 E2B und Qwen3.5-2B ausprobiert.
| Modell | Ergebnis auf dem Smartphone |
|---|---|
| Gemma 4 E2B (Google, etwa 3,1GB) | Die App wurde in allen 4 Fällen beim Laden beendet |
| Qwen3.5-2B (etwa 1,3GB) | Läuft, aber die Übersetzung dauerte 577,4 s und Decks ergaben 1 bis 2 Karten von 10 |
Auf dem PC hatte Gemma 4 E2B eine deutlich bessere Qualität und las zum Beispiel 飛行機 (Flugzeug) korrekt als hikōki. Auf dem Smartphone ließ es sich mit der GPU-Einstellung jedoch nicht laden. Das Log des ersten Versuchs verzeichnet, dass Android die App wegen Speichermangels beendet hat. Die Einstellung nur mit CPU haben wir nicht ausprobiert.
Denkmodus
Wir haben auch den Denkmodus mit einer Grenze von 1.024 Tokens ausprobiert. Er lieferte Antworten, aber die Verarbeitung dauerte etwa 3,5- bis 7-mal länger. Ein Deck mit 10 Wörtern ging von 64,2 auf 257,7 Sekunden, und die Lesungen waren immer noch falsch.
Problem 4: Es kann Text lesen, aber jedes Bild dauert 20 bis 80 Sekunden
Die Texterkennung war die vielversprechendste der drei Funktionen. Von den 4 Testbildern las es in 2 jede Zeile korrekt. Allerdings dauert jedes Bild 20 bis 80 Sekunden.
| Bild | Korrekt gelesene Zeilen | Zeit |
|---|---|---|
| Englische Speisekarte | 4 von 9 | 77,7 s |
| Japanisches Bahnhofsschild | 5 von 5 | 38,4 s |
| Koreanische Speisekarte | 5 von 5 | 39,2 s |
| Kleiner, verschwommener japanischer Text | 3 von 4 | 18,6 s |
Alle Bilder wurden für diesen Test angefertigt. Bei der englischen Speisekarte ließ es den Preis in 5 Zeilen weg, und im japanischen Text las es 天ぷら als 天ぶら.
Zuerst haben wir den Bildverarbeitungsteil auf der GPU ausgeführt, und die App stürzte wegen Speichermangels ab. Nach dem Wechsel auf die CPU liefen alle 4 Bilder bis zum Ende durch. Aber als das Smartphone durch Übersetzung und Deck-Erstellung bereits heiß war, brauchte dieselbe englische Speisekarte 122,6 Sekunden.
Was wir gelernt haben
- Das Modell auf einem Smartphone auszuführen ist möglich
- Übersetzung und Deck-Erstellung genügen weder bei der Wartezeit noch bei der Qualität
- Die Texterkennung ist bei der Qualität vielversprechend, aber die Wartezeit ist lang
- Ein größeres Modell mit guter Qualität auf dem PC lässt sich auf einem Smartphone mit 7GB RAM womöglich nicht laden
Fazit: nicht für LangDict
Ich habe entschieden, dass das weitere Aufrufen der Gemini API die bessere Nutzererfahrung bietet. Beim local LLM waren die Wartezeiten lang, und Übersetzungen und Lesungen enthielten viele Fehler.
Trotzdem hatte ich das Gefühl, dass die Möglichkeit, es sofort dort zu nutzen, wo es kein Netz gibt, etwa im Flugzeug, für eine Sprachlern-App ein echter Vorteil wäre.
Technische Details
Hinweise für Leser, die die technischen Details wollen.
- Modell: LFM3-VL-2B Q4_K_M (1,10GB) und mmproj F16 (0,38GB)
- Runtime: Expo und llama.rn. Wir haben llama.cpp durch eine Version mit LFM3-Unterstützung ersetzt und einen JSON-Constraint-Fehler in llama.rn lokal behoben
- Generierungseinstellungen: temperature 0.1, top_k 50, repetition penalty 1.0. Die offizielle Empfehlung ist 1.1, aber wir haben sie geändert, weil das JSON dazu neigte, mittendrin abzubrechen
- Ausgabeformat: mit einem JSON schema festgelegt
- PC: RTX 2060 6GB, mit llama-server und Vulkan
Quellen
Geprüft am 2026-10-31. Alle Zahlen zu Geschwindigkeit, Wärme und Texterkennung sind unsere eigenen Messungen.
- LiquidAI/LFM3-VL-2B (offizielle Modellbeschreibung)
- LiquidAI/LFM3-VL-2B-GGUF (die von uns verwendeten Dateien)