Executando o LFM3 em um celular para ver se ele pode substituir os recursos de IA do LangDict
Testamos se um local LLM, o pequeno modelo LFM3 da Liquid AI rodando no próprio celular, poderia substituir os recursos de IA do LangDict, um aplicativo de aprendizado de idiomas que eu desenvolvo.
Ele rodou, mas, depois dos testes, decidi não colocá-lo no aplicativo.
O que testamos
O LangDict é um aplicativo de flashcards: você digita as palavras que quer aprender e a IA gera traduções, frases de exemplo e pronúncias. Ele usa a Gemini API em três recursos.
| Recurso | O que faz |
|---|---|
| Tradução | Traduz o texto digitado para outro idioma |
| Geração de decks | Recebe um tema como “Travel at the airport” e cria um lote de cartões com palavras, traduções e leituras |
| Reconhecimento de texto | Transforma o texto de uma foto em texto editável (OCR) |
Testamos se um local LLM poderia substituí-los.
Observamos três pontos:
- Se os três recursos rodam no celular
- Tempos de espera e velocidade em uso contínuo
- Qualidade da saída
Condições do teste
| Item | Detalhes |
|---|---|
| Celular | Celular Android (7GB de RAM) |
| Modelo | LFM3-VL-2B (cerca de 1,5GB incluindo o mmproj) |
| Método | Um aplicativo de teste com os mesmos prompts do LangDict, medido durante o carregamento da bateria |
| Execuções | Uma execução por condição (variância não medida) |
Trate os números como uma referência. Os itens também testados em um PC estão marcados como “no PC”.
Problema 1: a primeira tradução congela por cerca de 20 segundos
A primeira tradução depois de abrir o aplicativo levou 21,2 segundos para começar a produzir texto, e a tela parecia congelada. A segunda começou em 0,9 segundo.
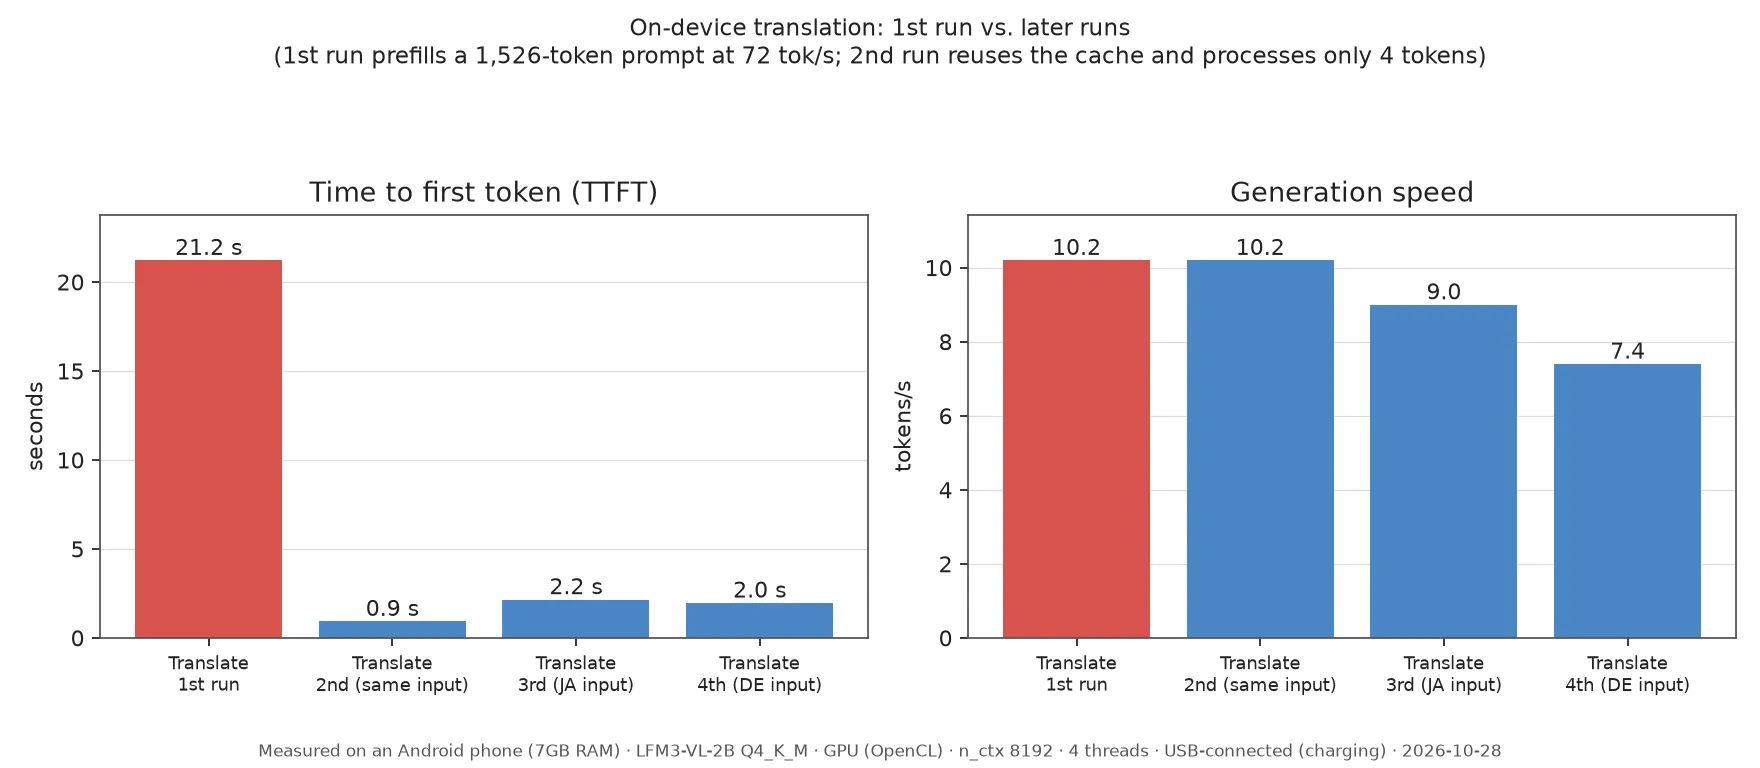
A causa foi o tamanho do prompt. O prompt de tradução tem 1.526 tokens e o celular processa 72 tok/s, então só ler o prompt leva cerca de 20 segundos. A segunda execução é mais rápida porque o cache entra em ação.
O prompt é quase fixo, então fazer o prefill dele ao abrir a tela pode reduzir a espera. É apenas uma ideia; ainda não a testamos.
Problema 2: fica mais lento com o uso contínuo
Depois de alguns minutos de uso, o calor reduz a velocidade de geração, e as tarefas seguintes esperam mais.
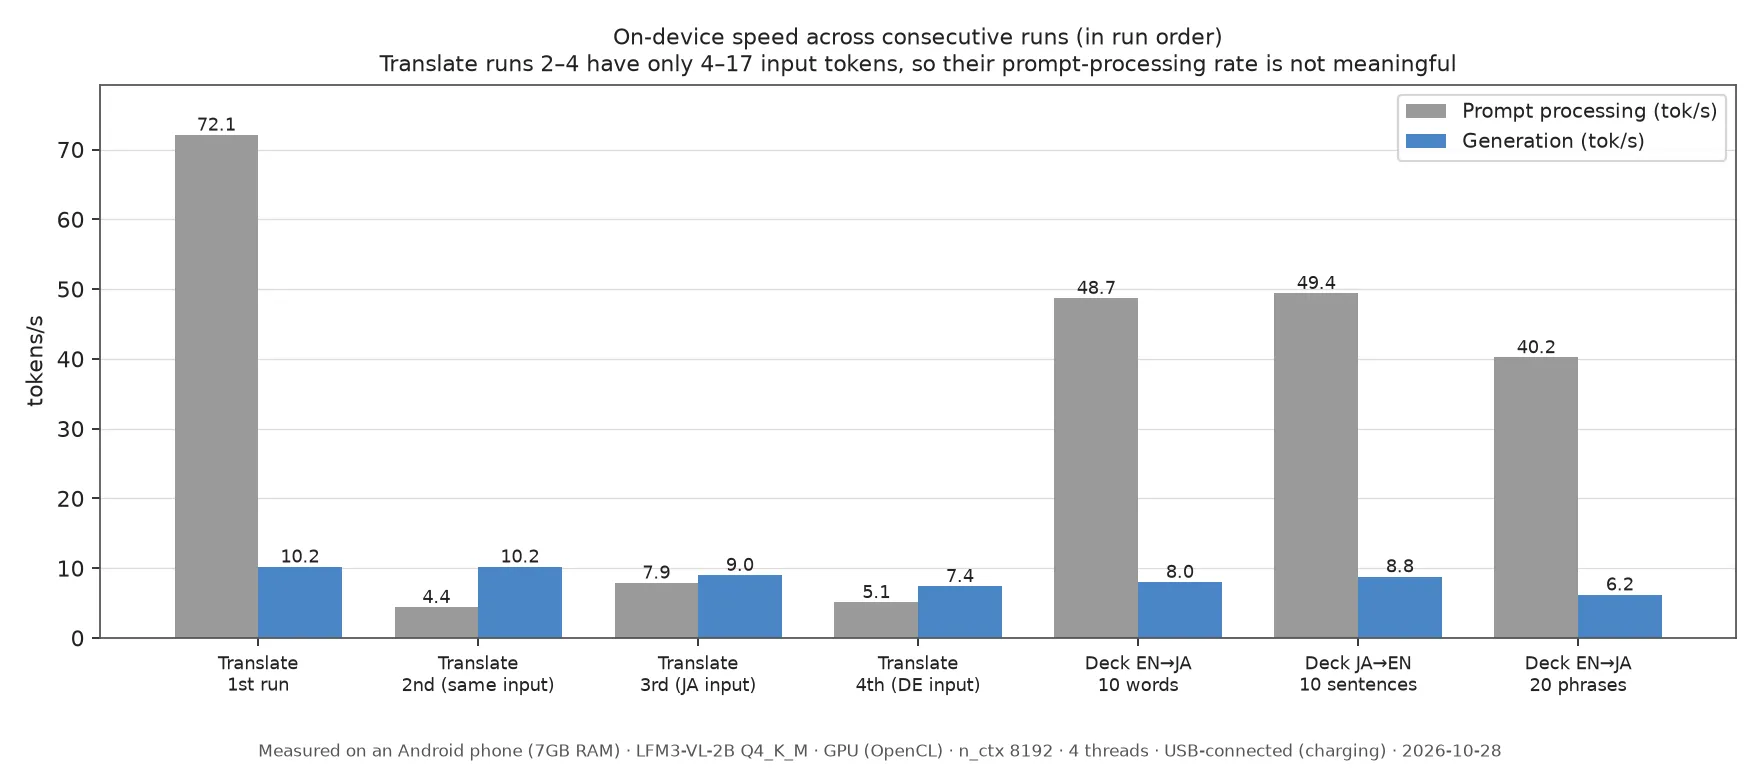
A velocidade de geração caiu de 10,2 tok/s para 6,2 tok/s. Um deck de 20 frases levou 156,3 segundos, e até um deck de 10 palavras levou 66,6 segundos.
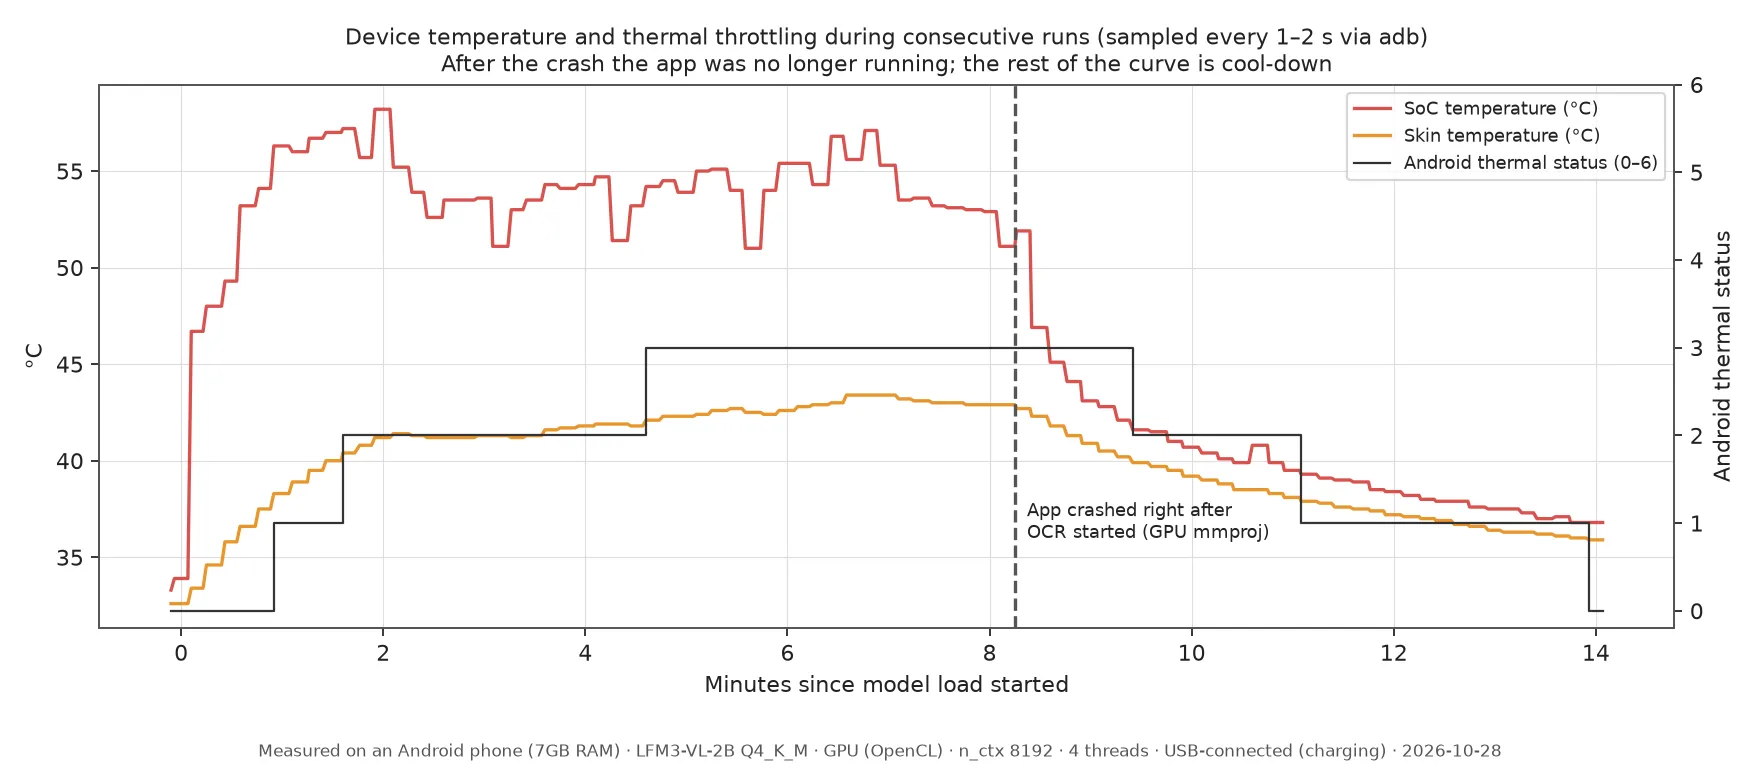
O estado térmico do Android subiu para 1 após cerca de 1 minuto, para 2 após cerca de 1,6 minuto e para 3 após cerca de 4,6 minutos. A temperatura cai na segunda metade do gráfico porque o aplicativo travou durante o teste de imagens que veio em seguida.
Executando só com CPU
Os números até aqui vêm da execução na GPU. Só com CPU, a geração de um deck ficou mais rápida, de 64,2 para 46,2 segundos, mas o uso de memória aumentou e o celular esquentou mais cedo.
| GPU | Só CPU | |
|---|---|---|
| Tempo para gerar um deck de 10 palavras | 64,2 s | 46,2 s |
| Memória do aplicativo (pico) | 1052MB | 1923MB |
| Tempo até o estado térmico 3 | Cerca de 2 min 35 s | Cerca de 1 min 35 s |
| Temperatura máxima do SoC | 57,4℃ | 60,4℃ |
A memória é a memória residente e não inclui os pesos colocados na GPU.
Problema 3: traduções e leituras estão erradas
O modelo respeita o formato JSON, mas o conteúdo tem erros evidentes. Isso é um problema sério em um aplicativo de flashcards, porque os estudantes memorizam os erros como estão.
- As leituras do japonês quase nunca estavam corretas. 空港 (aeroporto) virou
kū kōkun, e 荷物 (bagagem) virounagō. - As traduções de inglês para japonês às vezes ficavam em texto romanizado em vez de virar japonês.
- Ele identificou como inglês a frase alemã “Ich habe Hunger”.
- Um deck de coreano para japonês, testado no PC, produziu apenas 1 cartão de 10, com japonês no campo coreano.
- Quando pedimos 10 frases de exemplo, ele parou em 2 cartões na GPU e em 8 só com CPU.
Os mesmos erros apareceram no PC, então vemos isso como um limite do modelo. Os usos previstos no model card também são coisas como ler imagens e documentos, então tradução e geração de decks talvez simplesmente não sejam o ponto forte dele.
Comparação com outros modelos
Também testamos o Gemma 4 E2B e o Qwen3.5-2B no celular.
| Modelo | Resultado no celular |
|---|---|
| Gemma 4 E2B (Google, cerca de 3,1GB) | O aplicativo foi encerrado durante o carregamento nas 4 vezes |
| Qwen3.5-2B (cerca de 1,3GB) | Roda, mas a tradução levou 577,4 s e os decks produziram de 1 a 2 cartões de 10 |
No PC, o Gemma 4 E2B teve qualidade muito melhor, por exemplo lendo corretamente 飛行機 (avião) como hikōki. No celular, porém, ele não carregava com a configuração de GPU. O log da primeira tentativa registra o Android encerrando o aplicativo por falta de memória. Não testamos a configuração só com CPU.
Modo de raciocínio
Também testamos o modo de raciocínio com limite de 1.024 tokens. Ele devolveu respostas, mas o processamento levou de 3,5 a 7 vezes mais tempo. Um deck de 10 palavras passou de 64,2 para 257,7 segundos, e as leituras continuaram erradas.
Problema 4: ele consegue ler texto, mas cada imagem leva de 20 a 80 segundos
O reconhecimento de texto foi o mais promissor dos três recursos. Das 4 imagens de teste, ele leu corretamente todas as linhas em 2. No entanto, cada imagem leva de 20 a 80 segundos.
| Imagem | Linhas lidas corretamente | Tempo |
|---|---|---|
| Cardápio em inglês | 4 de 9 | 77,7 s |
| Placa de estação em japonês | 5 de 5 | 38,4 s |
| Cardápio em coreano | 5 de 5 | 39,2 s |
| Texto japonês pequeno e borrado | 3 de 4 | 18,6 s |
Todas as imagens foram feitas para este teste. No cardápio em inglês, ele omitiu o preço em 5 linhas e, no texto japonês, leu 天ぷら como 天ぶら.
No começo, rodamos a parte de processamento de imagem na GPU, e o aplicativo travou por falta de memória. Depois de passá-la para a CPU, as 4 imagens rodaram até o fim. Mas, quando o celular já estava quente por causa da tradução e da geração de decks, o mesmo cardápio em inglês levou 122,6 segundos.
O que aprendemos
- Executar o modelo em um celular é possível
- Tradução e geração de decks ficam aquém tanto no tempo de espera quanto na qualidade
- O reconhecimento de texto é promissor em qualidade, mas a espera é longa
- Um modelo maior que tem boa qualidade no PC pode não carregar em um celular com 7GB de RAM
Conclusão: não para o LangDict
Decidi que continuar chamando a Gemini API oferece uma experiência melhor ao usuário. Com o local LLM, as esperas eram longas e as traduções e leituras tinham muitos erros.
Dito isso, achei que poder usá-lo na hora, onde não há rede, como em um avião, seria um benefício real para um aplicativo de aprendizado de idiomas.
Detalhes técnicos
Notas para os leitores que querem os detalhes técnicos.
- Modelo: LFM3-VL-2B Q4_K_M (1,10GB) e mmproj F16 (0,38GB)
- Runtime: Expo e llama.rn. Trocamos o llama.cpp por uma versão que suporta o LFM3 e corrigimos localmente um bug de restrição JSON no llama.rn
- Configurações de geração: temperature 0.1, top_k 50, repetition penalty 1.0. A recomendação oficial é 1.1, mas mudamos porque o JSON tendia a parar no meio
- Formato de saída: especificado com um JSON schema
- PC: RTX 2060 6GB, usando llama-server e Vulkan
Fontes
Verificadas em 2026-10-31. Todos os números de velocidade, calor e reconhecimento de texto são medições nossas.
- LiquidAI/LFM3-VL-2B (descrição oficial do modelo)
- LiquidAI/LFM3-VL-2B-GGUF (os arquivos que usamos)