تشغيل LFM3 على هاتف لمعرفة ما إذا كان يستطيع أن يحل محل ميزات الذكاء الاصطناعي في LangDict
اختبرنا ما إذا كان local LLM، أي نموذج LFM3 الصغير من Liquid AI الذي يعمل على الهاتف نفسه، يستطيع أن يحل محل ميزات الذكاء الاصطناعي في LangDict، وهو تطبيق لتعلّم اللغات أطوّره.
لقد عمل، لكنني قررت بعد الاختبار ألا أضعه في التطبيق.
ما الذي اختبرناه
LangDict تطبيق بطاقات تعليمية: تُدخل الكلمات التي تريد تعلمها فيولّد الذكاء الاصطناعي الترجمات وجملًا للأمثلة والنطق. يستخدم التطبيق Gemini API في ثلاث ميزات.
| الميزة | وظيفتها |
|---|---|
| الترجمة | تترجم النص المُدخل إلى لغة أخرى |
| إنشاء المجموعات | تأخذ موضوعًا مثل “Travel at the airport” وتنشئ دفعة من البطاقات تحوي كلمات وترجمات وقراءات |
| التعرف على النص | تحوّل النص الموجود في صورة إلى نص قابل للتحرير (OCR) |
اختبرنا ما إذا كان local LLM يستطيع الحلول محلها.
نظرنا في ثلاثة أمور:
- هل تعمل الميزات الثلاث على الهاتف
- أزمنة الانتظار والسرعة عند الاستخدام المتواصل
- جودة المخرجات
شروط الاختبار
| البند | التفاصيل |
|---|---|
| الهاتف | هاتف Android (7GB RAM) |
| النموذج | LFM3-VL-2B (نحو 1.5GB شاملًا mmproj) |
| الطريقة | تطبيق اختبار يستخدم نفس prompts الخاصة بـ LangDict، وتم القياس أثناء الشحن |
| عدد مرات التشغيل | تشغيل واحد لكل شرط (لم يُقَس التباين) |
تعاملوا مع الأرقام على أنها مؤشر تقريبي. البنود التي اختُبرت أيضًا على PC مُشار إليها بعبارة “على PC”.
المشكلة 1: الترجمة الأولى تتجمد نحو 20 ثانية
استغرقت الترجمة الأولى بعد فتح التطبيق 21.2 ثانية قبل أن يبدأ ظهور النص، وبدت الشاشة متجمدة. أما الثانية فبدأت خلال 0.9 ثانية.
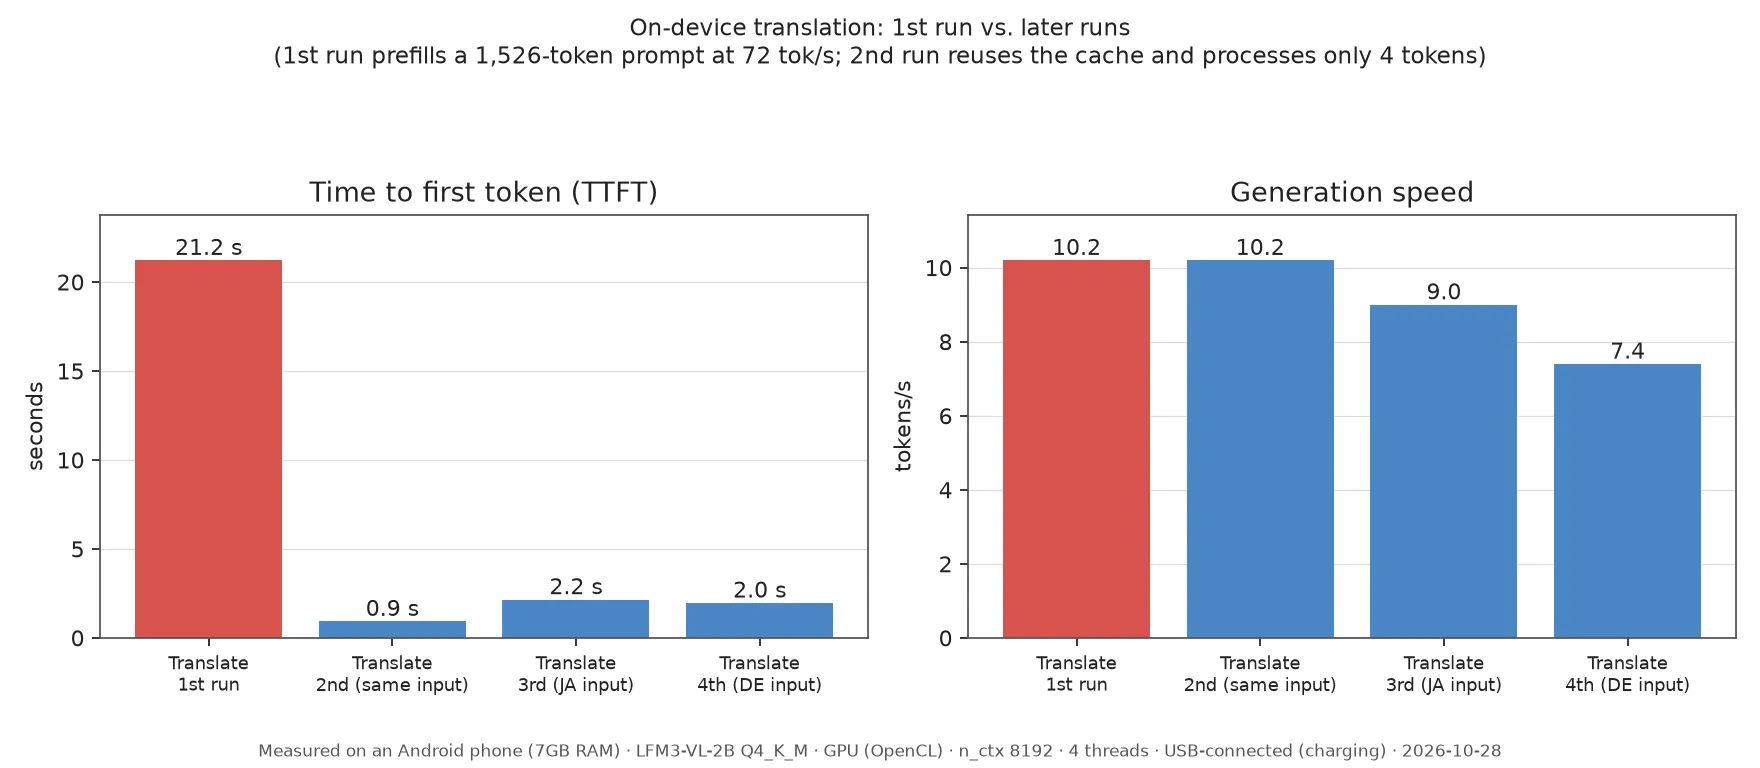
كان السبب طول الـ prompt. يبلغ طول prompt الترجمة 1,526 token، ويعالج الهاتف 72 tok/s، لذا فقراءته وحدها تستغرق نحو 20 ثانية. التشغيل الثاني أسرع لأن الـ cache يدخل في العمل.
الـ prompt ثابت تقريبًا، لذا فإجراء prefill له عند فتح الشاشة قد يقلل الانتظار. هذه مجرد فكرة؛ لم نجربها بعد.
المشكلة 2: يبطؤ مع الاستمرار في الاستخدام
بعد بضع دقائق من الاستخدام، تقلل الحرارة سرعة التوليد، فتنتظر المهام اللاحقة وقتًا أطول.
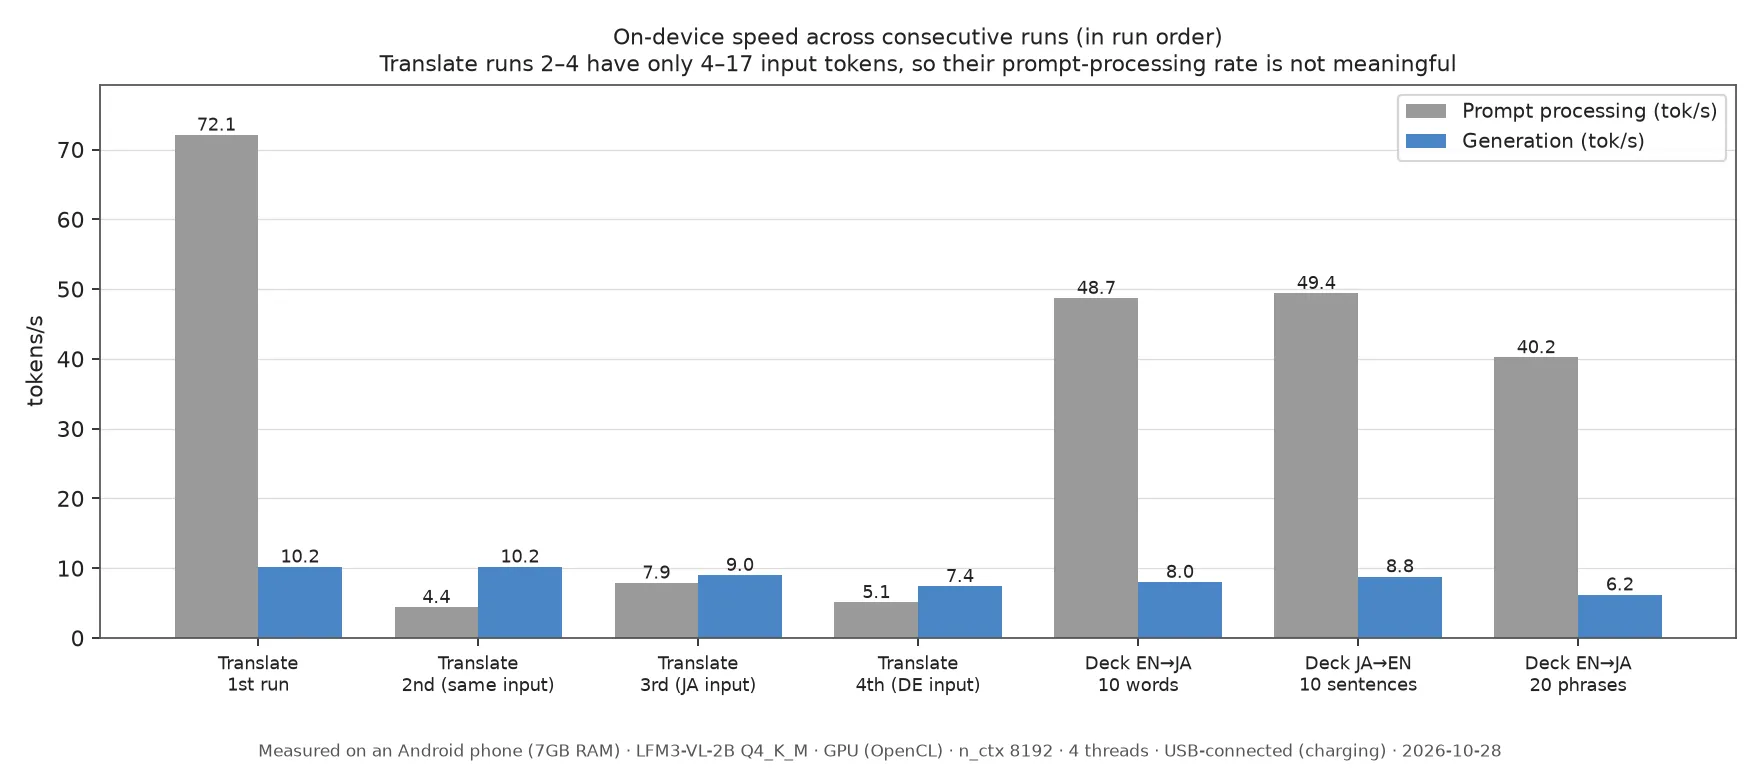
انخفضت سرعة التوليد من 10.2 tok/s إلى 6.2 tok/s. استغرقت مجموعة من 20 عبارة 156.3 ثانية، وحتى مجموعة من 10 كلمات استغرقت 66.6 ثانية.
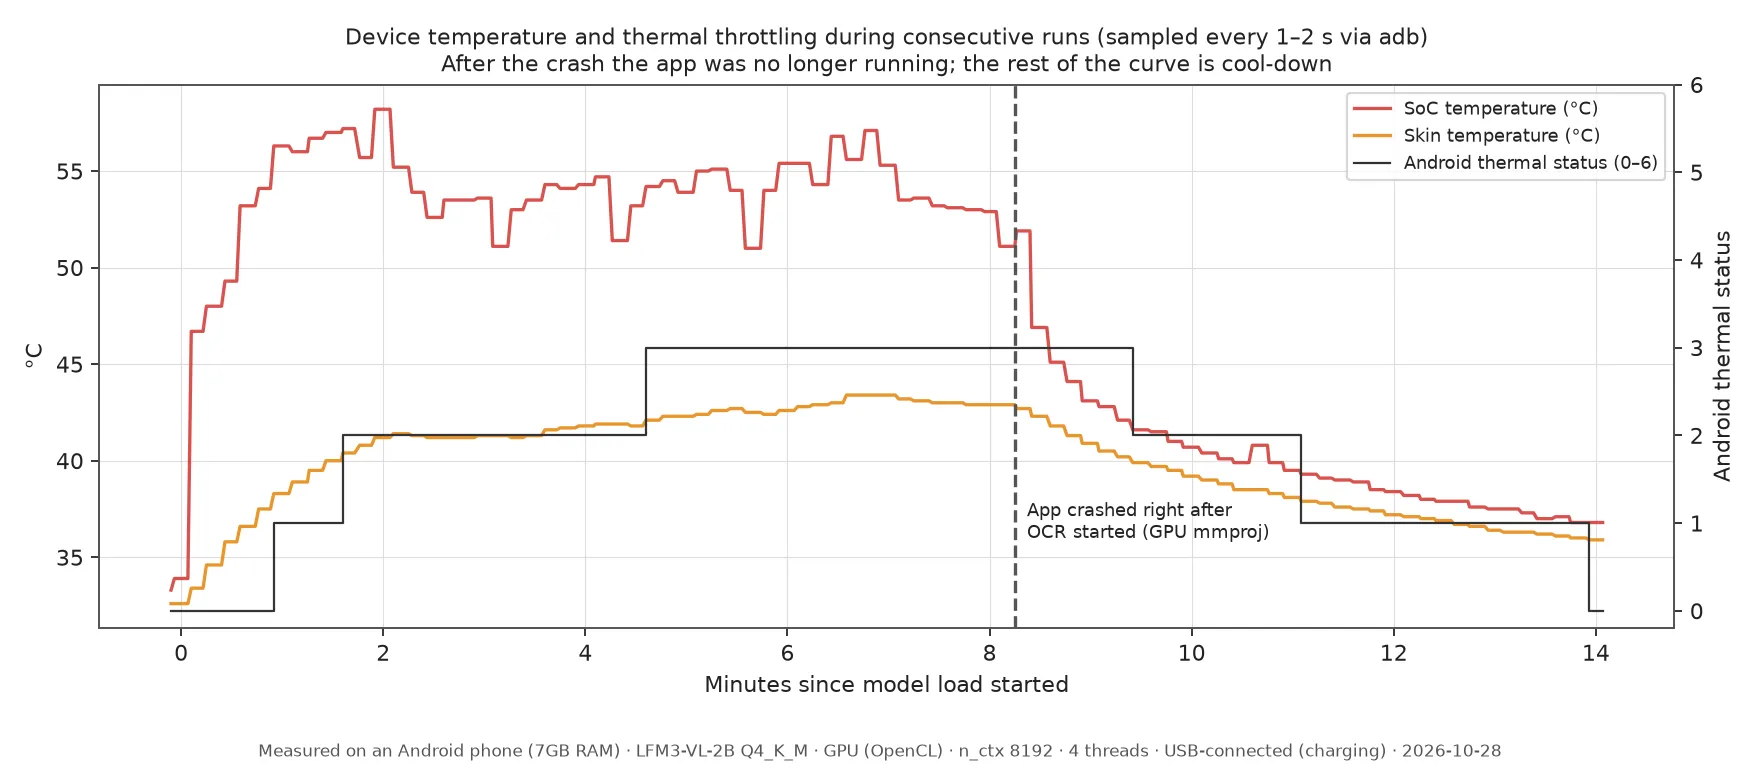
ارتفعت الحالة الحرارية في Android إلى 1 بعد نحو دقيقة، وإلى 2 بعد نحو 1.6 دقيقة، وإلى 3 بعد نحو 4.6 دقيقة. تنخفض الحرارة في النصف الثاني من الرسم البياني لأن التطبيق تعطل أثناء اختبار الصور الذي تلاه.
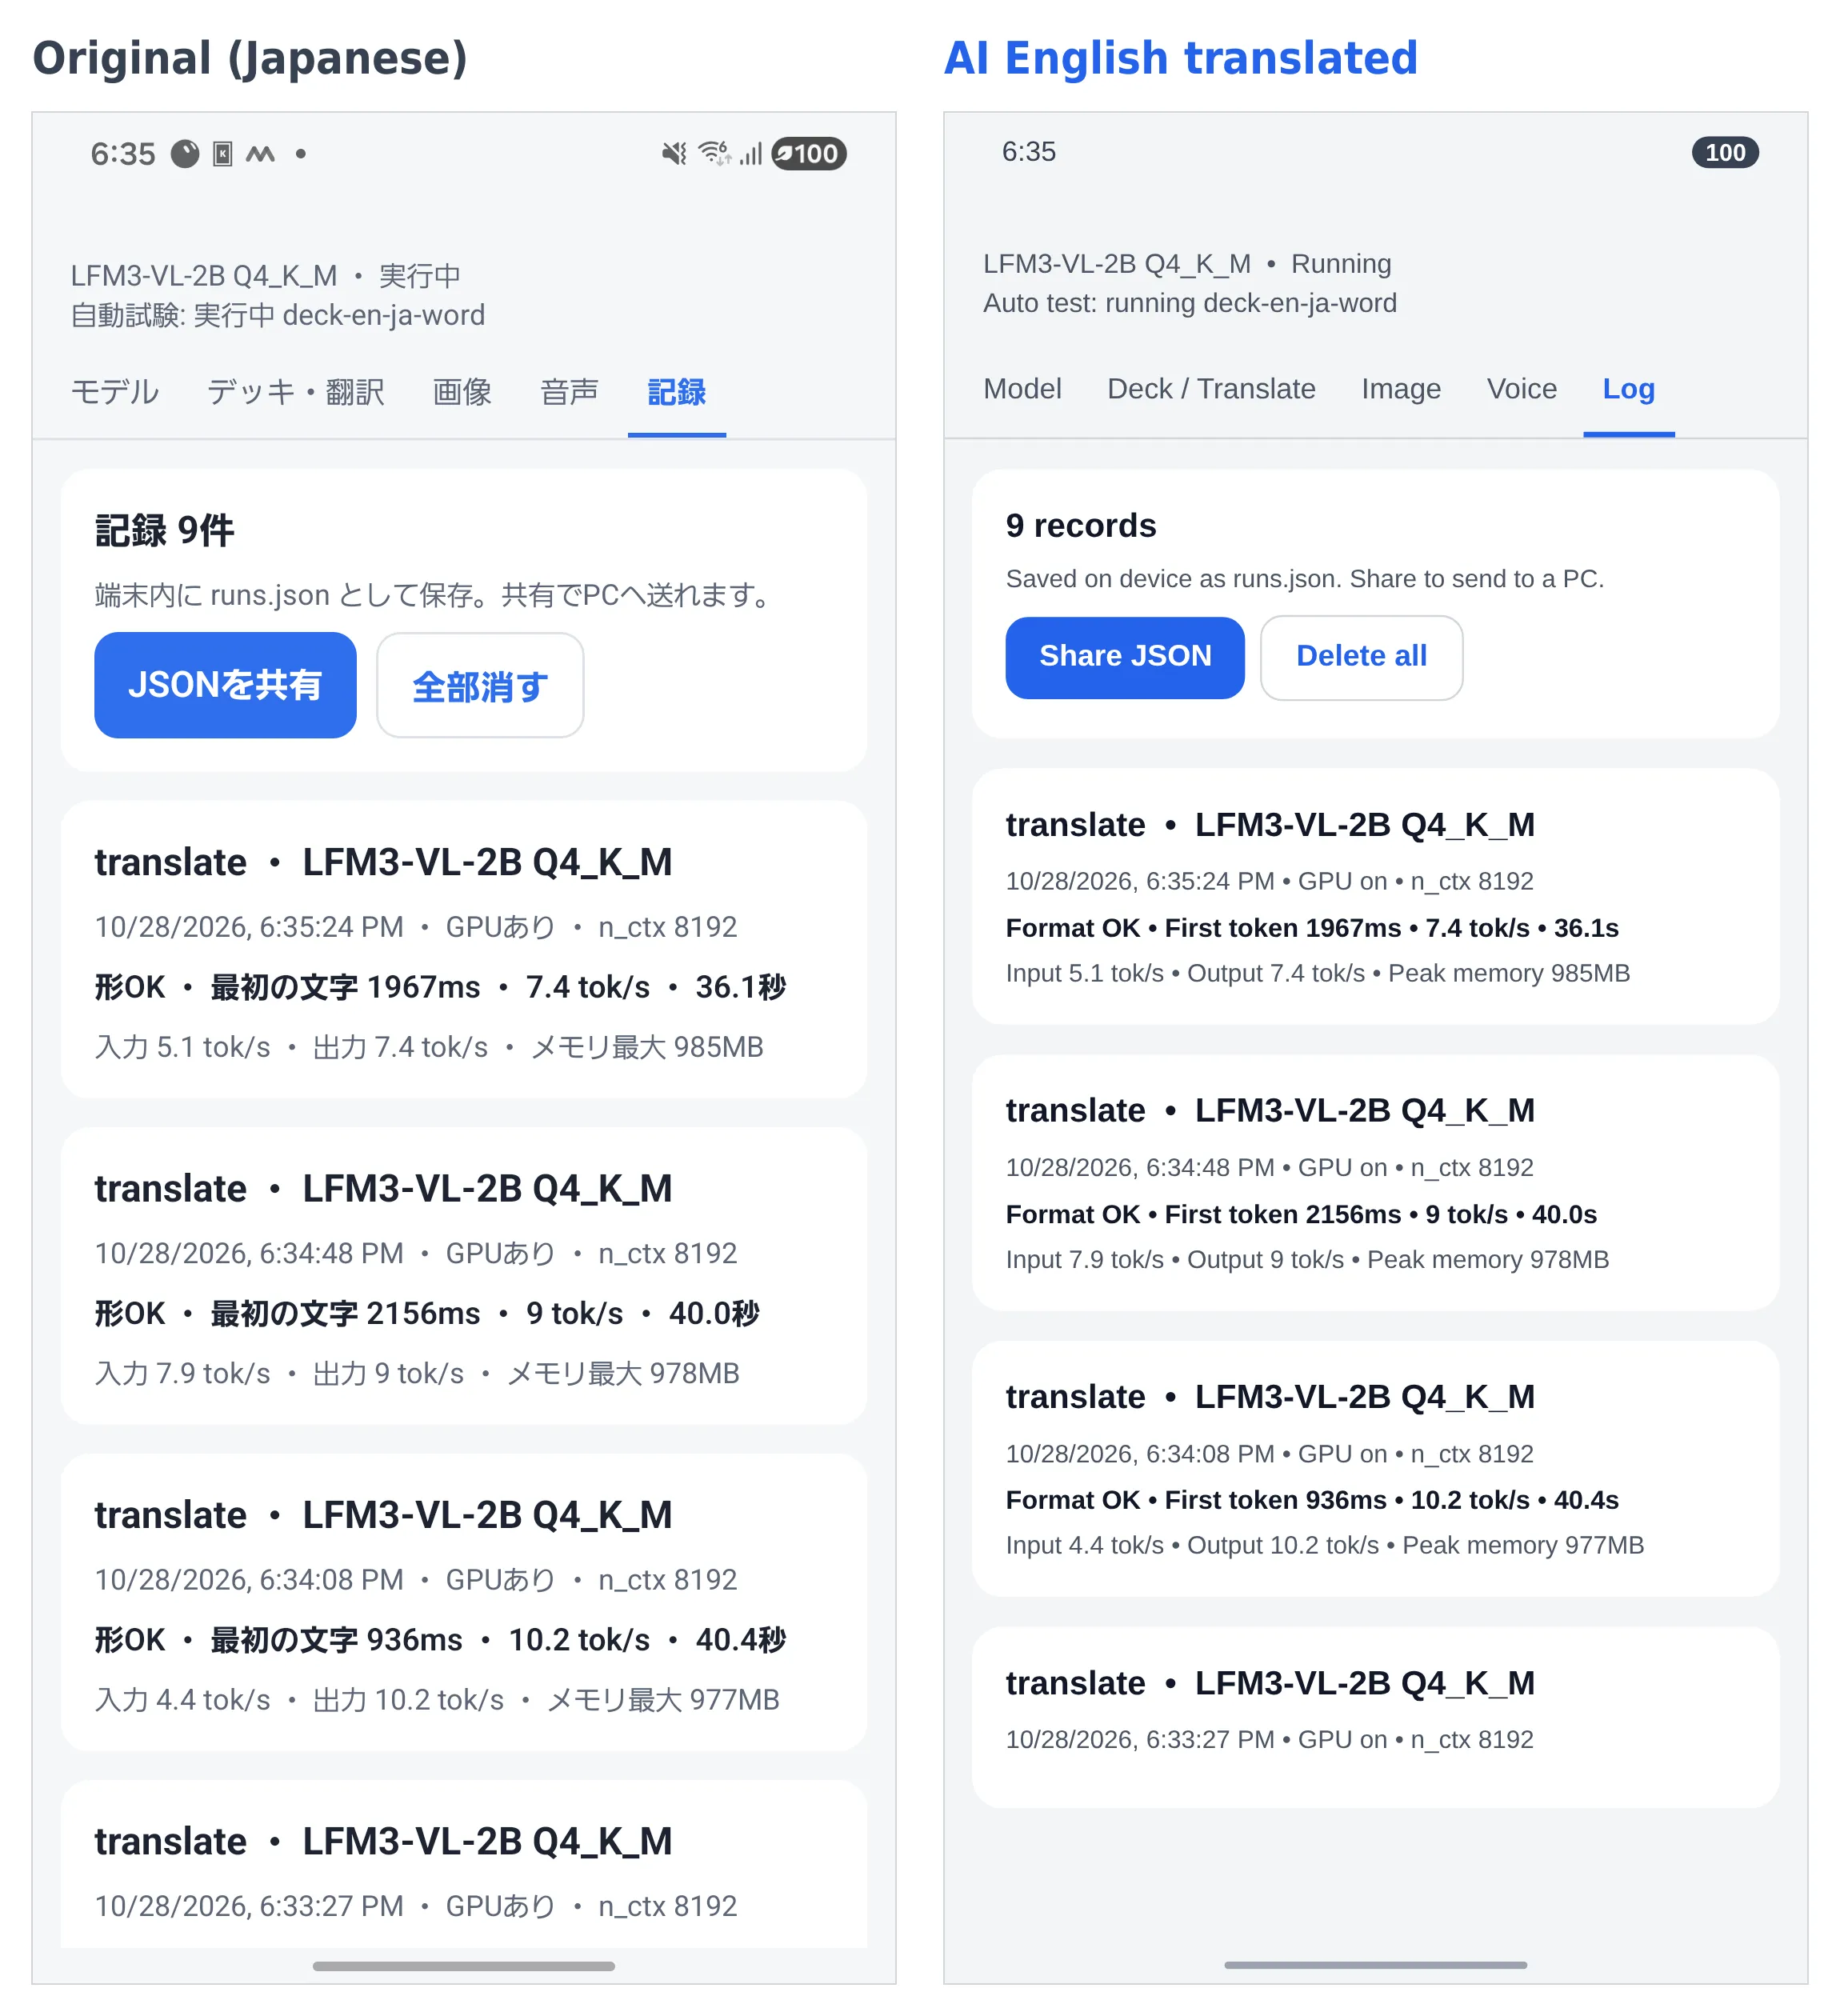
التشغيل على CPU فقط
الأرقام حتى الآن مصدرها التشغيل على GPU. عند استخدام CPU فقط أصبح إنشاء المجموعة أسرع، من 64.2 إلى 46.2 ثانية، لكن استهلاك الذاكرة ارتفع وسخن الهاتف أبكر.
| GPU | CPU فقط | |
|---|---|---|
| زمن إنشاء مجموعة من 10 كلمات | 64.2 s | 46.2 s |
| ذاكرة التطبيق (الذروة) | 1052MB | 1923MB |
| الزمن حتى الحالة الحرارية 3 | نحو 2 د 35 ث | نحو 1 د 35 ث |
| ذروة حرارة SoC | 57.4℃ | 60.4℃ |
الذاكرة هي الذاكرة المقيمة ولا تشمل الأوزان الموضوعة على GPU.
المشكلة 3: الترجمات والقراءات خاطئة
يلتزم النموذج بصيغة JSON، لكن المحتوى فيه أخطاء ملحوظة. وهذه مشكلة جدية في تطبيق البطاقات التعليمية، لأن المتعلمين يحفظون الأخطاء كما هي.
- القراءات اليابانية لم تكن صحيحة تقريبًا أبدًا. أصبحت 空港 (المطار)
kū kōkun، وأصبحت 荷物 (الأمتعة)nagō. - الترجمات من الإنجليزية إلى اليابانية بقيت أحيانًا بحروف لاتينية بدلًا من أن تصبح يابانية.
- حدّد الجملة الألمانية “Ich habe Hunger” على أنها إنجليزية.
- مجموعة من الكورية إلى اليابانية، اختُبرت على PC، أنتجت بطاقة واحدة فقط من 10، مع نص ياباني في الحقل الكوري.
- عند طلب 10 جمل أمثلة، توقف عند بطاقتين على GPU و8 على CPU فقط.
ظهرت الأخطاء نفسها على PC، لذا نرى أنها حد في النموذج. كما أن الاستخدامات المقصودة في بطاقة النموذج هي أمور مثل قراءة الصور والمستندات، فربما لا تكون الترجمة وإنشاء المجموعات من نقاط قوته أصلًا.
المقارنة مع نماذج أخرى
جربنا أيضًا Gemma 4 E2B وQwen3.5-2B على الهاتف.
| النموذج | النتيجة على الهاتف |
|---|---|
| Gemma 4 E2B (من Google، نحو 3.1GB) | أُغلق التطبيق أثناء التحميل في المرات الأربع |
| Qwen3.5-2B (نحو 1.3GB) | يعمل، لكن الترجمة استغرقت 577.4 s وأنتجت المجموعات من 1 إلى 2 بطاقة من 10 |
على PC كانت جودة Gemma 4 E2B أفضل بكثير، فمثلًا قرأ 飛行機 (الطائرة) بشكل صحيح hikōki. لكنه لم يُحمَّل على الهاتف بإعداد GPU. يسجل سجل المحاولة الأولى أن Android أغلق التطبيق بسبب نقص الذاكرة. لم نجرب إعداد CPU فقط.
وضع التفكير
جربنا أيضًا وضع التفكير بحد أقصى 1,024 token. أعاد إجابات، لكن المعالجة استغرقت من 3.5 إلى 7 أضعاف الوقت تقريبًا. ارتفعت مجموعة الـ 10 كلمات من 64.2 إلى 257.7 ثانية، وظلت القراءات خاطئة.
المشكلة 4: يستطيع قراءة النص، لكن كل صورة تستغرق من 20 إلى 80 ثانية
كان التعرف على النص أكثر الميزات الثلاث وعدًا. من بين 4 صور اختبار، قرأ كل سطر بشكل صحيح في صورتين. لكن كل صورة تستغرق من 20 إلى 80 ثانية.
| الصورة | الأسطر المقروءة بشكل صحيح | الزمن |
|---|---|---|
| قائمة طعام بالإنجليزية | 4 من 9 | 77.7 s |
| لافتة محطة باليابانية | 5 من 5 | 38.4 s |
| قائمة طعام بالكورية | 5 من 5 | 39.2 s |
| نص ياباني صغير وغير واضح | 3 من 4 | 18.6 s |
جميع الصور أُعدت لهذا الاختبار. في قائمة الطعام الإنجليزية أسقط السعر في 5 أسطر، وفي النص الياباني قرأ 天ぷら على أنها 天ぶら.
شغّلنا في البداية جزء معالجة الصور على GPU، وتعطل التطبيق بسبب نقص الذاكرة. وبعد نقله إلى CPU اكتملت الصور الأربع. لكن عندما كان الهاتف ساخنًا أصلًا من الترجمة وإنشاء المجموعات، استغرقت قائمة الطعام الإنجليزية نفسها 122.6 ثانية.
ما تعلمناه
- تشغيل النموذج على هاتف ممكن
- الترجمة وإنشاء المجموعات دون المطلوب من حيث زمن الانتظار والجودة معًا
- التعرف على النص واعد في الجودة، لكن الانتظار طويل
- النموذج الأكبر ذو الجودة الجيدة على PC قد لا يُحمَّل على هاتف بذاكرة RAM سعتها 7GB
الخلاصة: ليس لـ LangDict
قررت أن الاستمرار في استدعاء Gemini API يعطي تجربة مستخدم أفضل. مع local LLM كان الانتظار طويلًا وكانت في الترجمات والقراءات أخطاء كثيرة.
ومع ذلك شعرت أن إمكانية استخدامه فورًا في مكان لا توجد فيه شبكة، مثل الطائرة، ستكون فائدة حقيقية لتطبيق تعلّم اللغات.
التفاصيل التقنية
ملاحظات للقراء الذين يريدون التفاصيل التقنية.
- النموذج: LFM3-VL-2B Q4_K_M (1.10GB) وmmproj F16 (0.38GB)
- Runtime: Expo وllama.rn. استبدلنا llama.cpp بإصدار يدعم LFM3 وأصلحنا محليًا خطأ قيود JSON في llama.rn
- إعدادات التوليد: temperature 0.1 وtop_k 50 وrepetition penalty 1.0. التوصية الرسمية هي 1.1، لكننا غيّرناها لأن JSON كان يميل إلى التوقف في منتصفه
- صيغة المخرجات: محددة بـ JSON schema
- PC: RTX 2060 6GB، باستخدام llama-server وVulkan
المصادر
تم التحقق في 2026-10-31. جميع أرقام السرعة والحرارة والتعرف على النص هي قياساتنا الخاصة.
- LiquidAI/LFM3-VL-2B (الوصف الرسمي للنموذج)
- LiquidAI/LFM3-VL-2B-GGUF (الملفات التي استخدمناها)