스마트폰에서 LFM3를 돌려 LangDict의 AI 기능을 대체할 수 있는지 확인했다
스마트폰 안에서 직접 돌아가는 Liquid AI의 소형 모델 LFM3, 즉 local LLM이 제가 만들고 있는 언어 학습 앱 LangDict의 AI 기능을 대체할 수 있는지 시험했습니다.
실행은 됐지만, 시험해 본 뒤 앱에는 넣지 않기로 했습니다.
시험한 내용
LangDict는 플래시카드 앱입니다. 배우고 싶은 단어를 입력하면 AI가 번역, 예문, 발음을 생성합니다. 세 가지 기능에서 Gemini API를 사용합니다.
| 기능 | 하는 일 |
|---|---|
| 번역 | 입력한 텍스트를 다른 언어로 번역한다 |
| 덱 생성 | “Travel at the airport” 같은 주제를 받아 단어, 번역, 읽는 법이 담긴 카드를 한꺼번에 만든다 |
| 문자 인식 | 사진 속 글자를 편집 가능한 텍스트로 바꾼다(OCR) |
local LLM으로 이들을 대체할 수 있는지 시험했습니다.
세 가지를 살펴봤습니다.
- 세 기능이 모두 스마트폰에서 동작하는가
- 연속 사용 시의 대기 시간과 속도
- 출력 품질
시험 조건
| 항목 | 내용 |
|---|---|
| 스마트폰 | Android 스마트폰(RAM 7GB) |
| 모델 | LFM3-VL-2B(mmproj 포함 약 1.5GB) |
| 방법 | LangDict와 같은 프롬프트를 쓰는 시험용 앱, 충전 중에 측정 |
| 횟수 | 조건당 1회(편차는 측정하지 않음) |
수치는 참고용으로 봐 주세요. PC에서도 시험한 항목에는 “PC에서”라고 표시했습니다.
문제 1: 첫 번역이 약 20초 멈춘다
앱을 연 뒤 첫 번역은 글자가 나오기 시작하기까지 21.2초가 걸려, 화면이 멈춘 것처럼 보였습니다. 두 번째는 0.9초 만에 시작됐습니다.
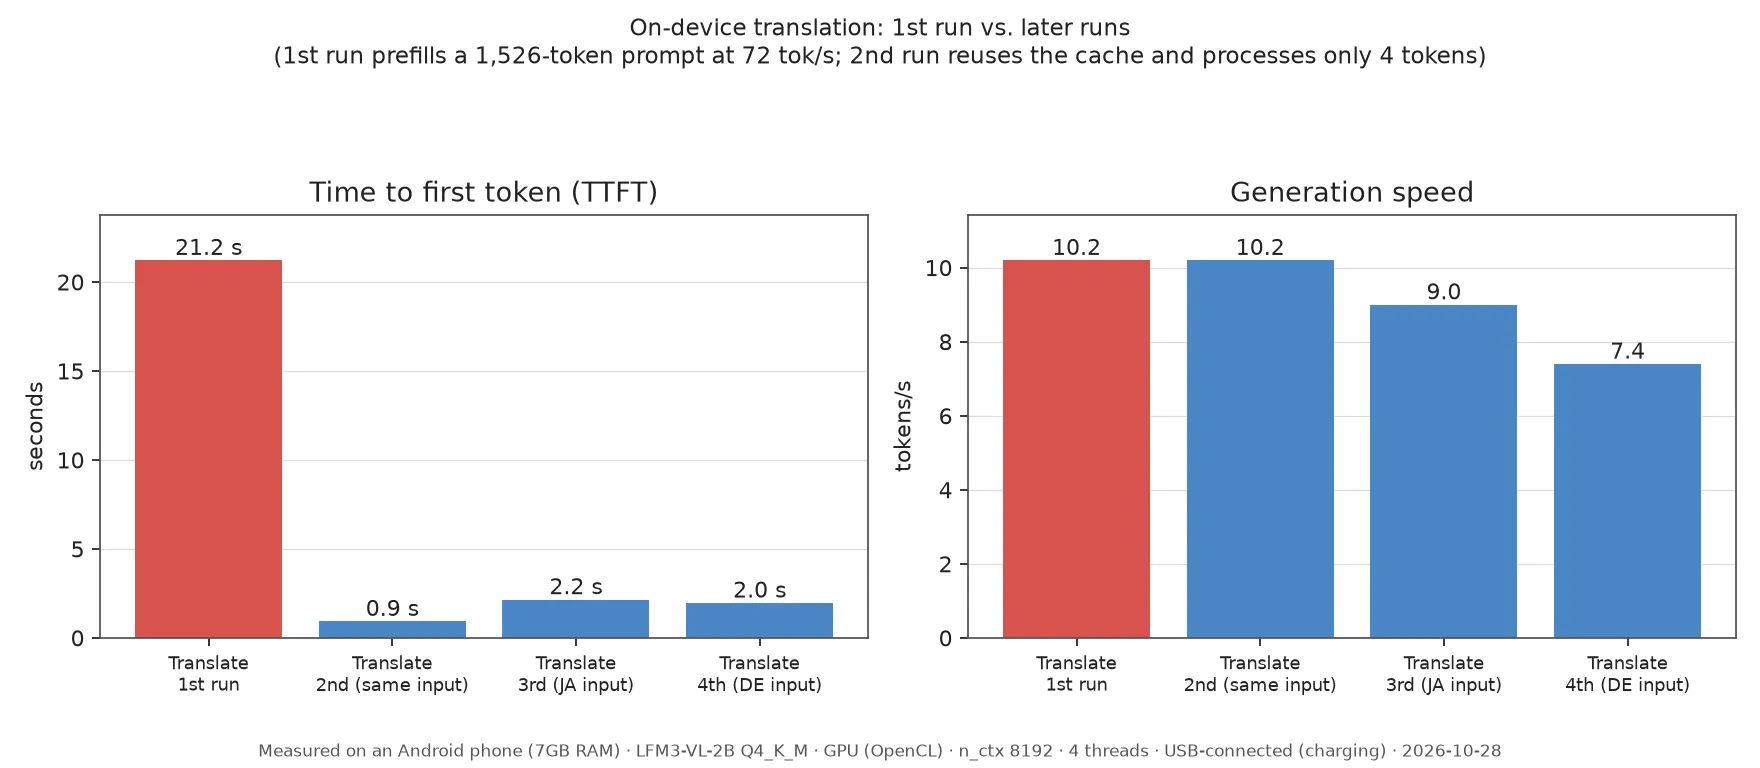
원인은 프롬프트의 길이입니다. 번역 프롬프트는 1,526 token이고 스마트폰의 처리 속도는 72 tok/s라서, 읽는 것만으로 약 20초가 걸립니다. 두 번째가 빠른 것은 캐시가 작동하기 때문입니다.
프롬프트는 거의 고정이므로 화면을 열 때 미리 처리해 두면 대기 시간을 줄일 수 있을지도 모릅니다. 어디까지나 아이디어이며 아직 시도하지 않았습니다.
문제 2: 계속 쓰면 느려진다
몇 분 사용하면 발열로 생성 속도가 떨어져서, 뒤쪽 작업일수록 오래 기다리게 됩니다.
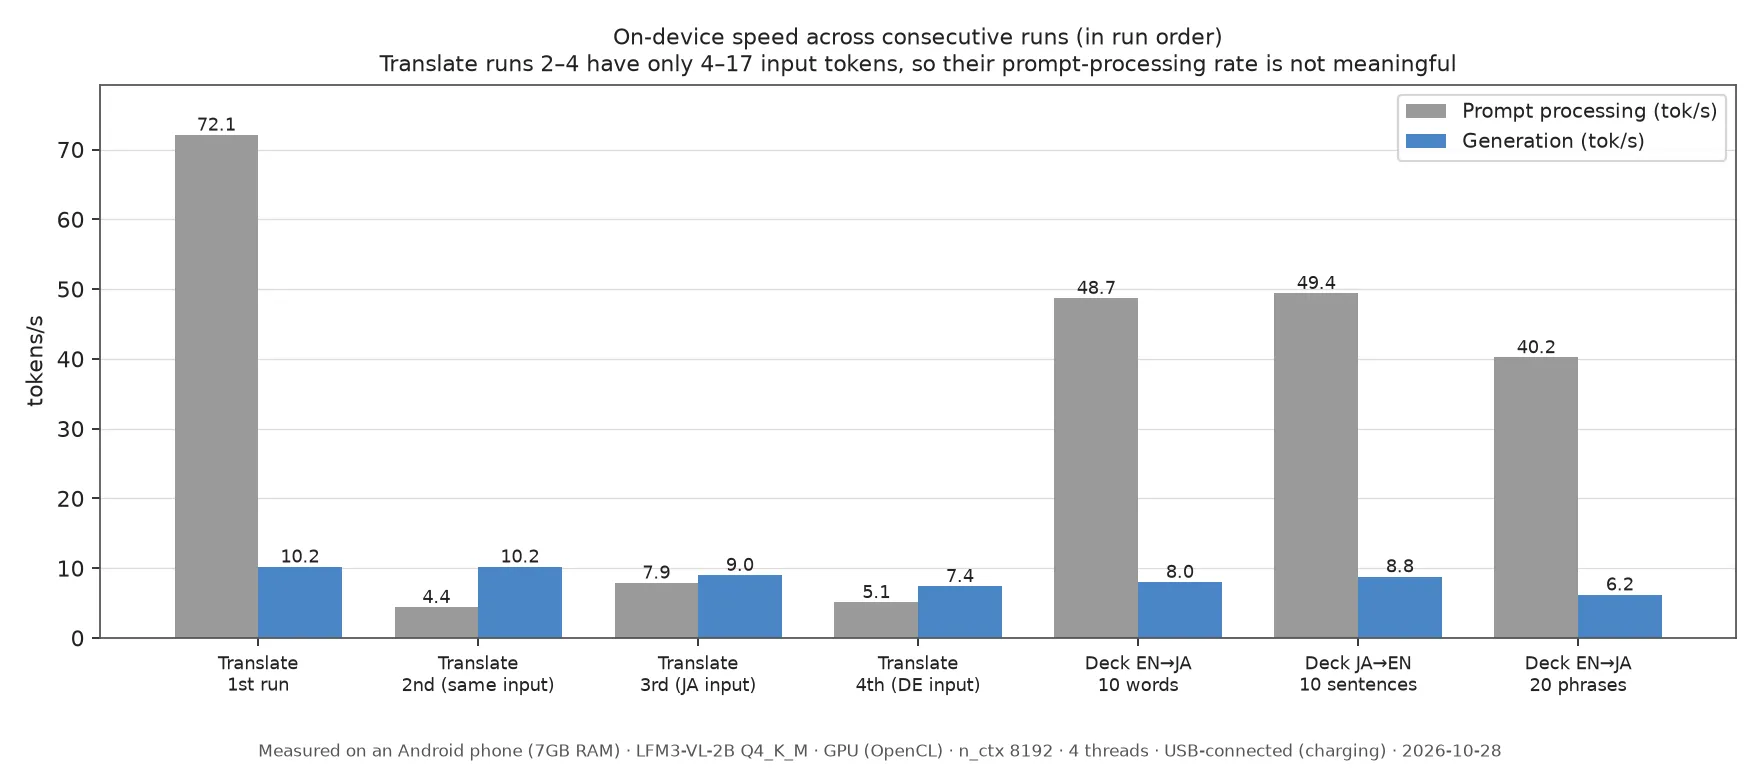
생성 속도는 10.2 tok/s에서 6.2 tok/s로 떨어졌습니다. 구문 20개짜리 덱은 156.3초가 걸렸고, 단어 10개짜리 덱도 66.6초가 걸렸습니다.
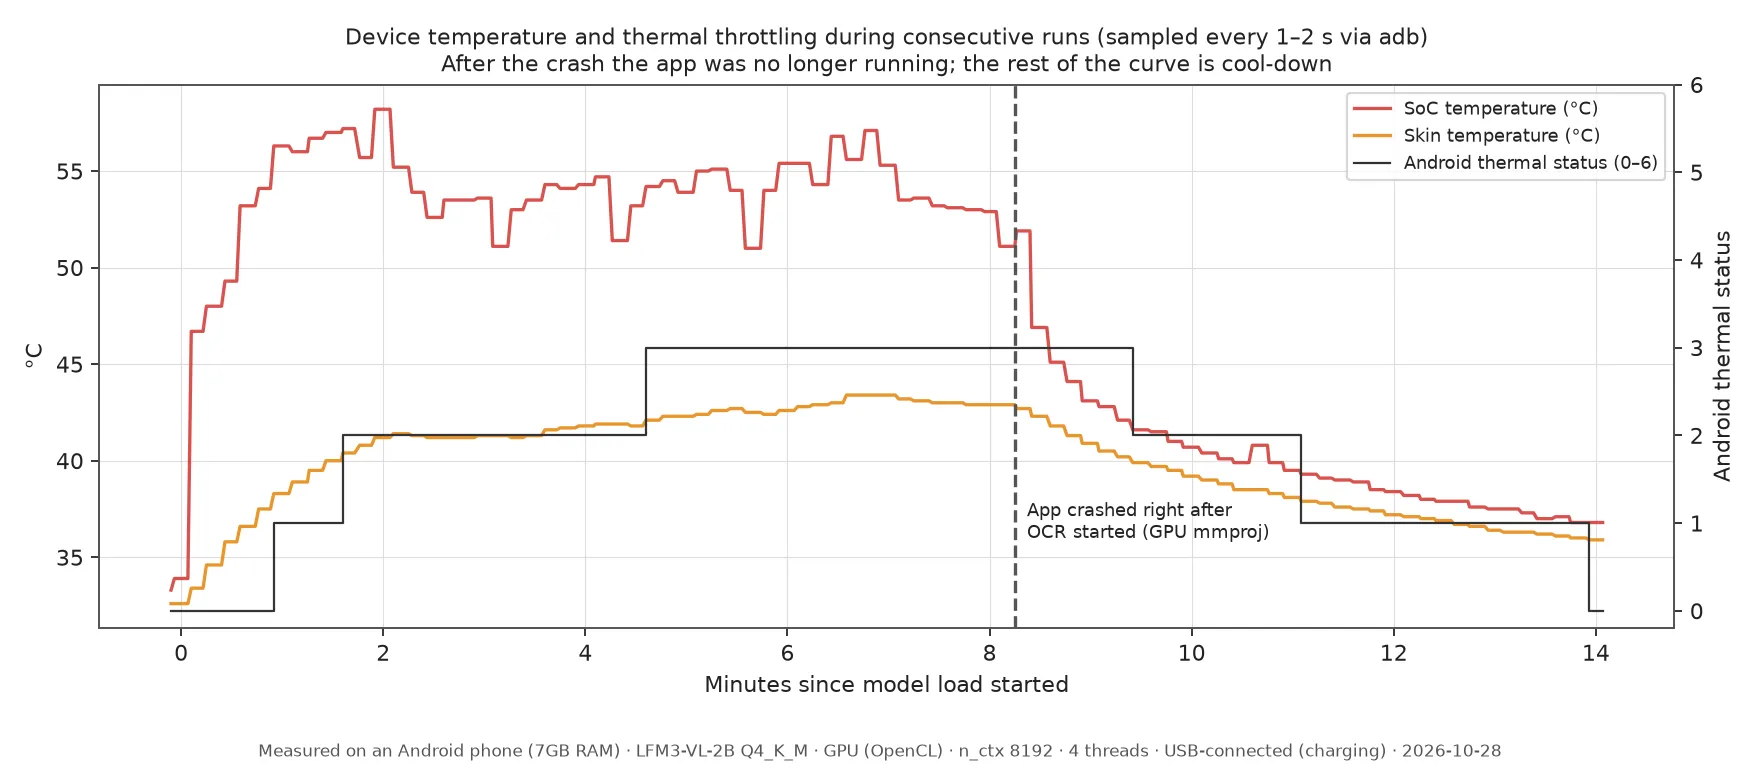
Android의 열 상태는 약 1분 뒤에 1, 약 1.6분 뒤에 2, 약 4.6분 뒤에 3으로 올랐습니다. 그래프 후반부에서 온도가 내려가는 것은 이어서 진행한 이미지 시험 중에 앱이 비정상 종료되었기 때문입니다.
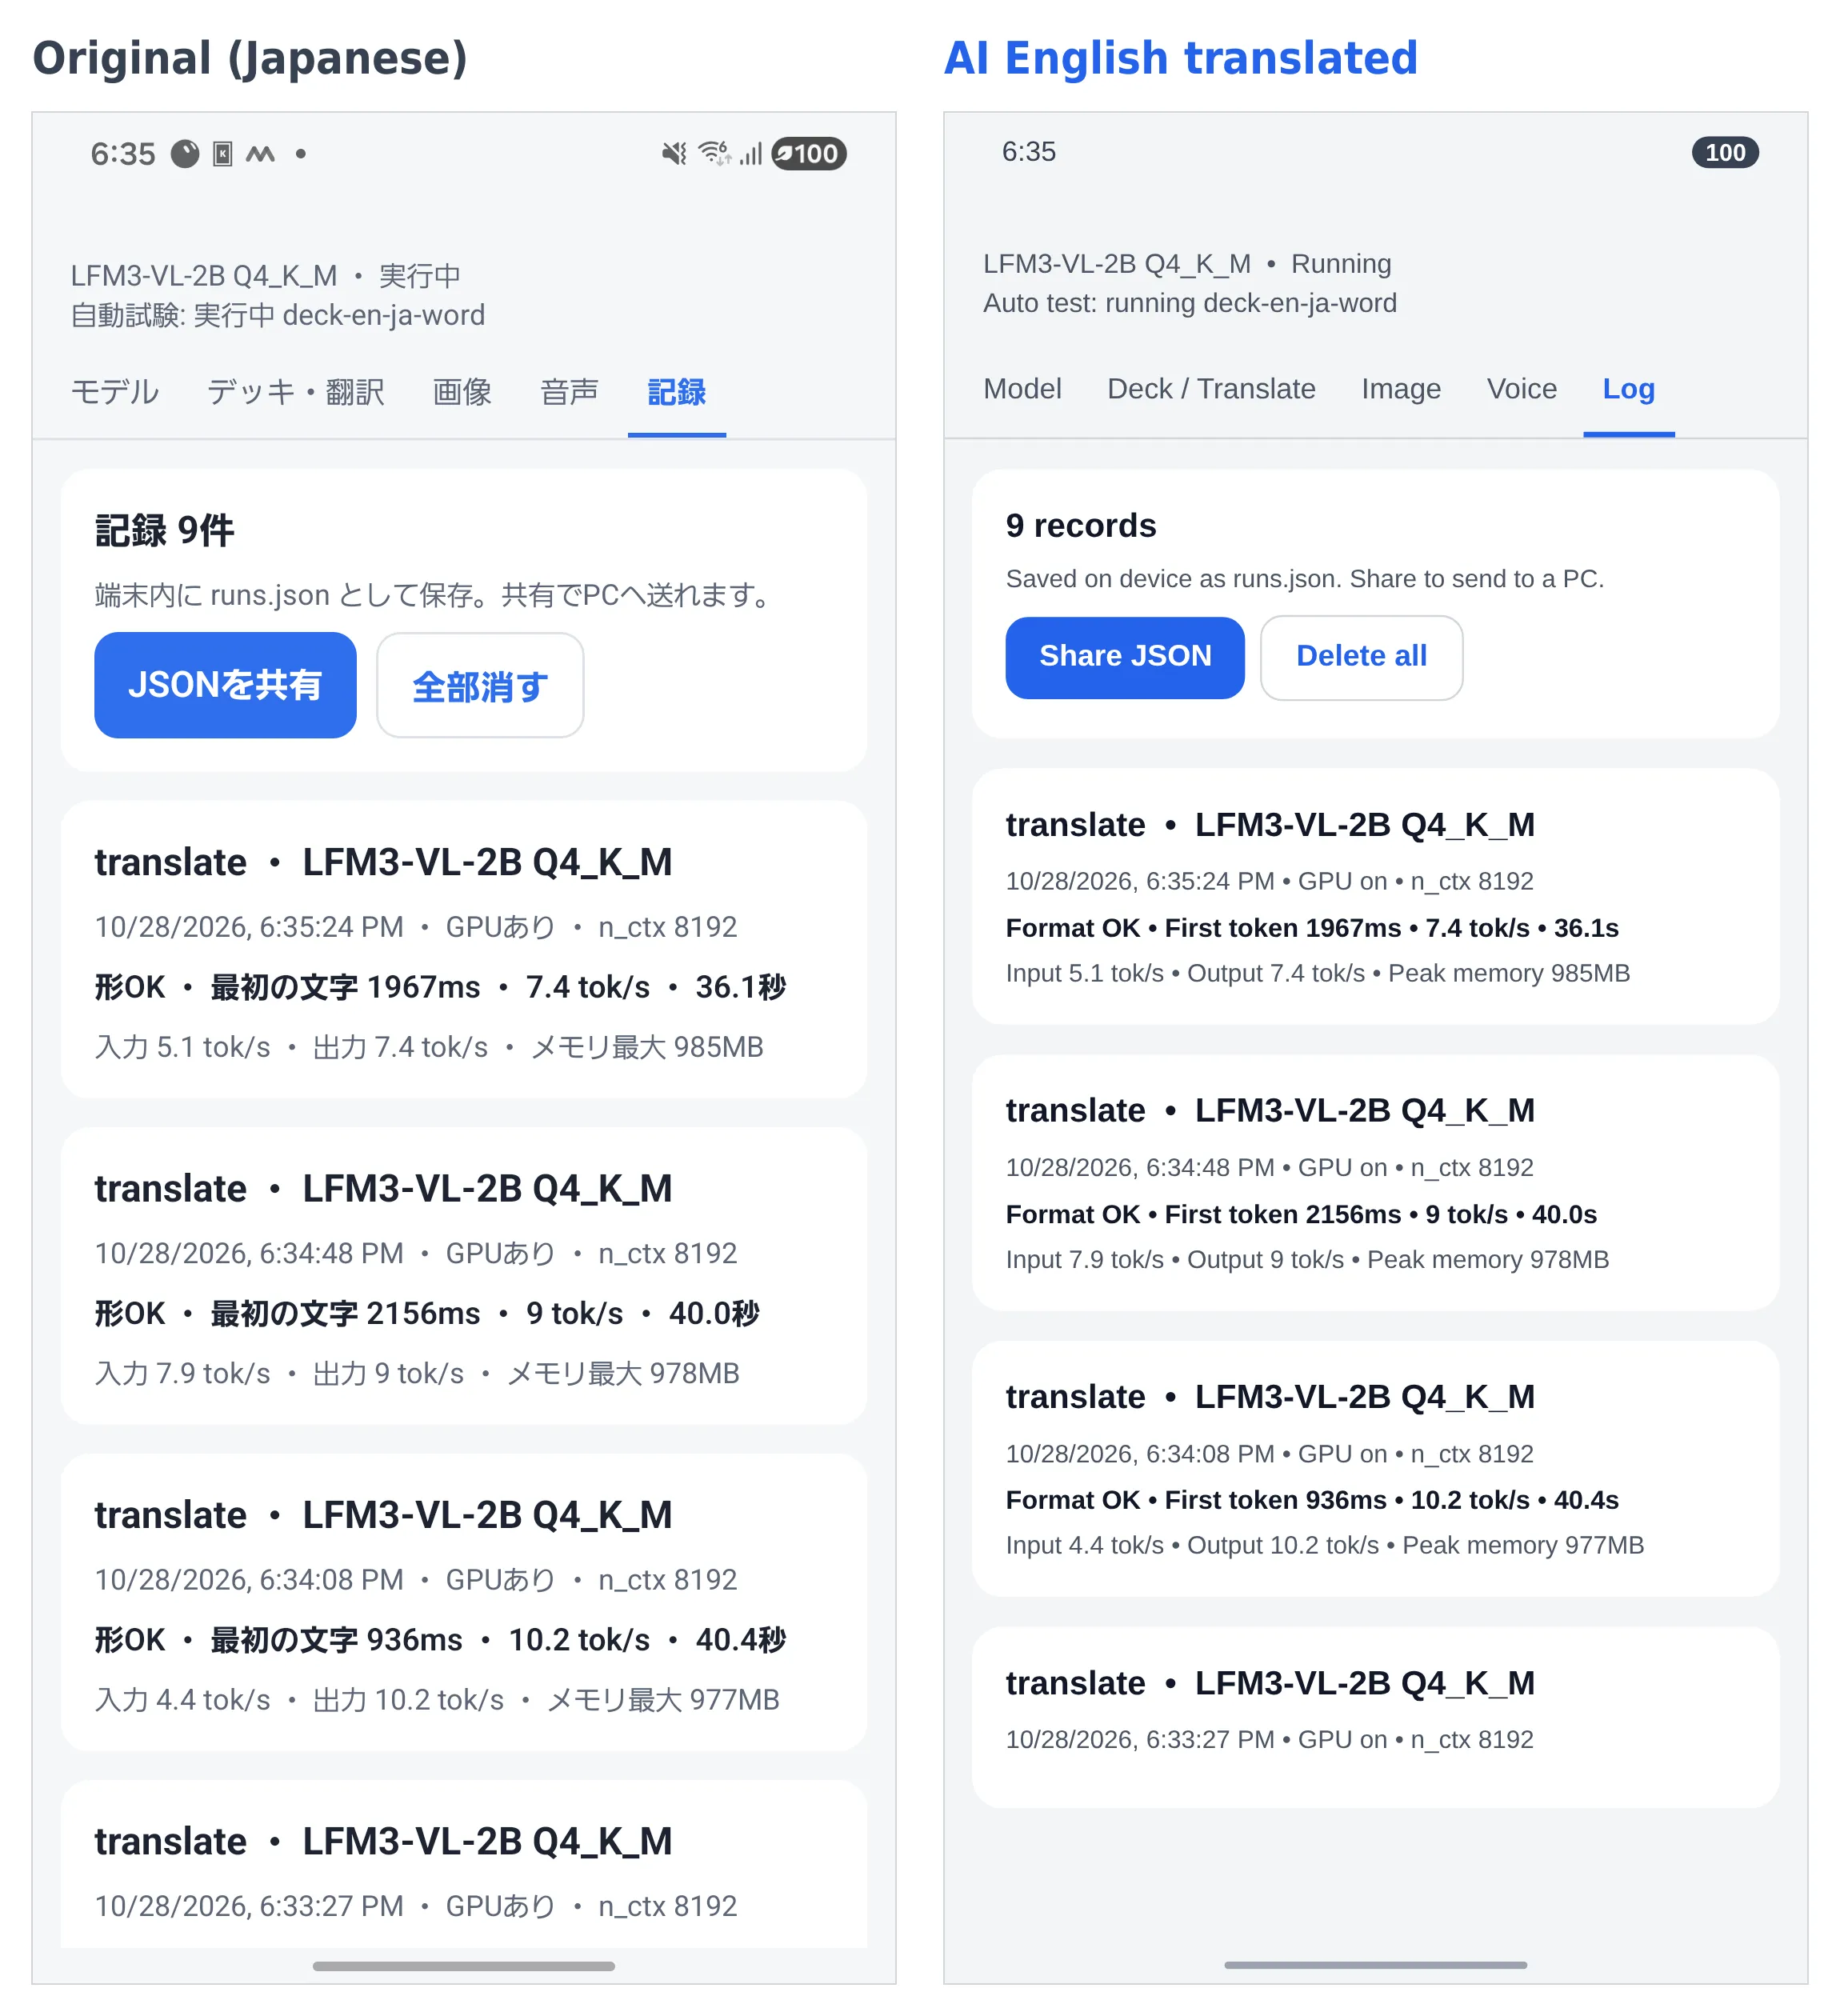
CPU만으로 실행
지금까지의 수치는 GPU로 실행한 결과입니다. CPU만 쓰면 덱 생성은 64.2초에서 46.2초로 빨라졌지만, 메모리 사용량이 늘고 스마트폰이 더 일찍 뜨거워졌습니다.
| GPU | CPU만 | |
|---|---|---|
| 단어 10개 덱 생성 시간 | 64.2 s | 46.2 s |
| 앱 메모리(최대) | 1052MB | 1923MB |
| 열 상태 3에 이르는 시간 | 약 2분 35초 | 약 1분 35초 |
| SoC 최고 온도 | 57.4℃ | 60.4℃ |
메모리는 상주 메모리이며 GPU에 올린 가중치는 포함하지 않습니다.
문제 3: 번역과 읽는 법이 틀린다
모델은 JSON 형식은 지키지만 내용에는 눈에 띄는 오류가 있습니다. 학습자가 틀린 내용을 그대로 외워 버리기 때문에 플래시카드 앱에서는 심각한 문제입니다.
- 일본어 읽는 법은 거의 맞지 않았습니다. 空港(공항)은
kū kōkun, 荷物(짐)는nagō가 되었습니다. - 영어에서 일본어로의 번역이 일본어가 되지 않고 로마자로 남는 경우가 있었습니다.
- 독일어 “Ich habe Hunger”를 영어로 판별했습니다.
- PC에서 시험한 한국어에서 일본어 덱은 10장 중 1장만 만들어졌고, 한국어 필드에 일본어가 들어갔습니다.
- 예문 10개를 요청하면 GPU에서는 2장, CPU만 쓸 때는 8장에서 멈췄습니다.
PC에서도 같은 오류가 나타났으므로 모델의 한계로 봅니다. 모델 카드가 밝힌 용도도 이미지나 문서 읽기 같은 것이어서, 번역과 덱 생성은 애초에 강점이 아닐 수 있습니다.
다른 모델과의 비교
Gemma 4 E2B와 Qwen3.5-2B도 스마트폰에서 시험했습니다.
| 모델 | 스마트폰에서의 결과 |
|---|---|
| Gemma 4 E2B(Google, 약 3.1GB) | 4번 모두 로딩 중에 앱이 종료됨 |
| Qwen3.5-2B(약 1.3GB) | 실행은 되지만 번역에 577.4초, 덱은 10장 중 1~2장만 생성 |
PC에서는 Gemma 4 E2B의 품질이 훨씬 좋았고, 예를 들어 飛行機(비행기)를 hikōki로 정확히 읽었습니다. 하지만 스마트폰에서는 GPU 설정으로 로드되지 않았습니다. 첫 시도의 로그에는 메모리 부족으로 Android가 앱을 종료한 기록이 남아 있습니다. CPU만 쓰는 설정은 시도하지 않았습니다.
사고 모드
1,024 token을 상한으로 사고 모드도 시험했습니다. 답은 돌려주었지만 처리에 약 3.5~7배의 시간이 걸렸습니다. 단어 10개 덱은 64.2초에서 257.7초가 되었고, 읽는 법은 여전히 틀렸습니다.
문제 4: 글자는 읽지만 이미지 한 장에 20~80초가 걸린다
문자 인식은 세 기능 중 가장 가능성이 있었습니다. 시험 이미지 4장 중 2장에서 모든 줄을 정확히 읽었습니다. 다만 이미지 한 장에 20~80초가 걸립니다.
| 이미지 | 정확히 읽은 줄 | 시간 |
|---|---|---|
| 영어 메뉴 | 9줄 중 4줄 | 77.7 s |
| 일본어 역 표지판 | 5줄 중 5줄 | 38.4 s |
| 한국어 메뉴 | 5줄 중 5줄 | 39.2 s |
| 작고 흐릿한 일본어 글자 | 4줄 중 3줄 | 18.6 s |
이미지는 모두 이번 시험을 위해 만든 것입니다. 영어 메뉴에서는 5줄의 가격이 빠졌고, 일본어 글자에서는 天ぷら를 天ぶら로 읽었습니다.
처음에는 이미지 처리 부분을 GPU에서 실행했는데 메모리 부족으로 앱이 비정상 종료되었습니다. CPU로 옮기자 4장 모두 끝까지 처리됐습니다. 그러나 번역과 덱 생성으로 이미 스마트폰이 뜨거워진 상태에서는 같은 영어 메뉴에 122.6초가 걸렸습니다.
알게 된 것
- 스마트폰에서 모델을 실행하는 것은 가능하다
- 번역과 덱 생성은 대기 시간과 품질 양쪽에서 부족하다
- 문자 인식은 품질 면에서 가능성이 있지만 대기 시간이 길다
- PC에서 품질이 좋은 더 큰 모델은 RAM 7GB 스마트폰에서는 로드되지 않을 수 있다
결론: LangDict에는 넣지 않는다
Gemini API를 계속 호출하는 편이 사용자 경험이 더 좋다고 판단했습니다. local LLM은 대기 시간이 길고 번역과 읽는 법에 오류가 많았습니다.
다만 비행기 안처럼 네트워크가 없는 곳에서 그 자리에서 쓸 수 있다는 점은 언어 학습 앱에 분명한 이점이 될 거라고 느꼈습니다.
기술 세부 사항
기술적인 내용을 알고 싶은 독자를 위한 메모입니다.
- 모델: LFM3-VL-2B Q4_K_M(1.10GB)과 mmproj F16(0.38GB)
- 런타임: Expo와 llama.rn. llama.cpp를 LFM3를 지원하는 버전으로 교체하고, llama.rn의 JSON 제약 버그는 로컬에서 수정했다
- 생성 설정: temperature 0.1, top_k 50, repetition penalty 1.0. 공식 권장값은 1.1이지만 JSON이 중간에 끊기는 경향이 있어 바꿨다
- 출력 형식: JSON schema로 지정
- PC: RTX 2060 6GB, llama-server와 Vulkan 사용
출처
2026-10-31에 확인했습니다. 속도, 발열, 문자 인식 수치는 모두 직접 측정한 값입니다.
- LiquidAI/LFM3-VL-2B(공식 모델 설명)
- LiquidAI/LFM3-VL-2B-GGUF(사용한 파일)