Menjalankan LFM3 di ponsel untuk melihat apakah ia bisa menggantikan fitur AI LangDict
Kami menguji apakah local LLM, yaitu model kecil LFM3 dari Liquid AI yang berjalan langsung di ponsel, dapat menggantikan fitur AI di LangDict, aplikasi belajar bahasa yang saya kembangkan.
Modelnya berjalan, tetapi setelah pengujian saya memutuskan untuk tidak memasukkannya ke aplikasi.
Apa yang kami uji
LangDict adalah aplikasi kartu hafalan: Anda memasukkan kata yang ingin dipelajari, lalu AI membuat terjemahan, contoh kalimat, dan cara pengucapan. Aplikasi ini memakai Gemini API untuk tiga fitur.
| Fitur | Fungsinya |
|---|---|
| Terjemahan | Menerjemahkan teks yang dimasukkan ke bahasa lain |
| Pembuatan dek | Menerima tema seperti “Travel at the airport” dan membuat sekumpulan kartu berisi kata, terjemahan, dan cara baca |
| Pengenalan teks | Mengubah teks dalam foto menjadi teks yang dapat diedit (OCR) |
Kami menguji apakah local LLM dapat menggantikan ketiganya.
Kami melihat tiga hal:
- Apakah ketiga fitur berjalan di ponsel
- Waktu tunggu dan kecepatan saat dipakai terus-menerus
- Kualitas keluaran
Kondisi pengujian
| Item | Rincian |
|---|---|
| Ponsel | Ponsel Android (RAM 7GB) |
| Model | LFM3-VL-2B (sekitar 1,5GB termasuk mmproj) |
| Metode | Aplikasi uji dengan prompt yang sama seperti LangDict, diukur saat mengisi daya |
| Jumlah uji | Satu kali per kondisi (varians tidak diukur) |
Anggap angka-angka ini sebagai panduan. Item yang juga diuji di PC ditandai “di PC”.
Masalah 1: terjemahan pertama membeku sekitar 20 detik
Terjemahan pertama setelah aplikasi dibuka butuh 21,2 detik sebelum mulai mengeluarkan teks, dan layar tampak membeku. Terjemahan kedua mulai dalam 0,9 detik.
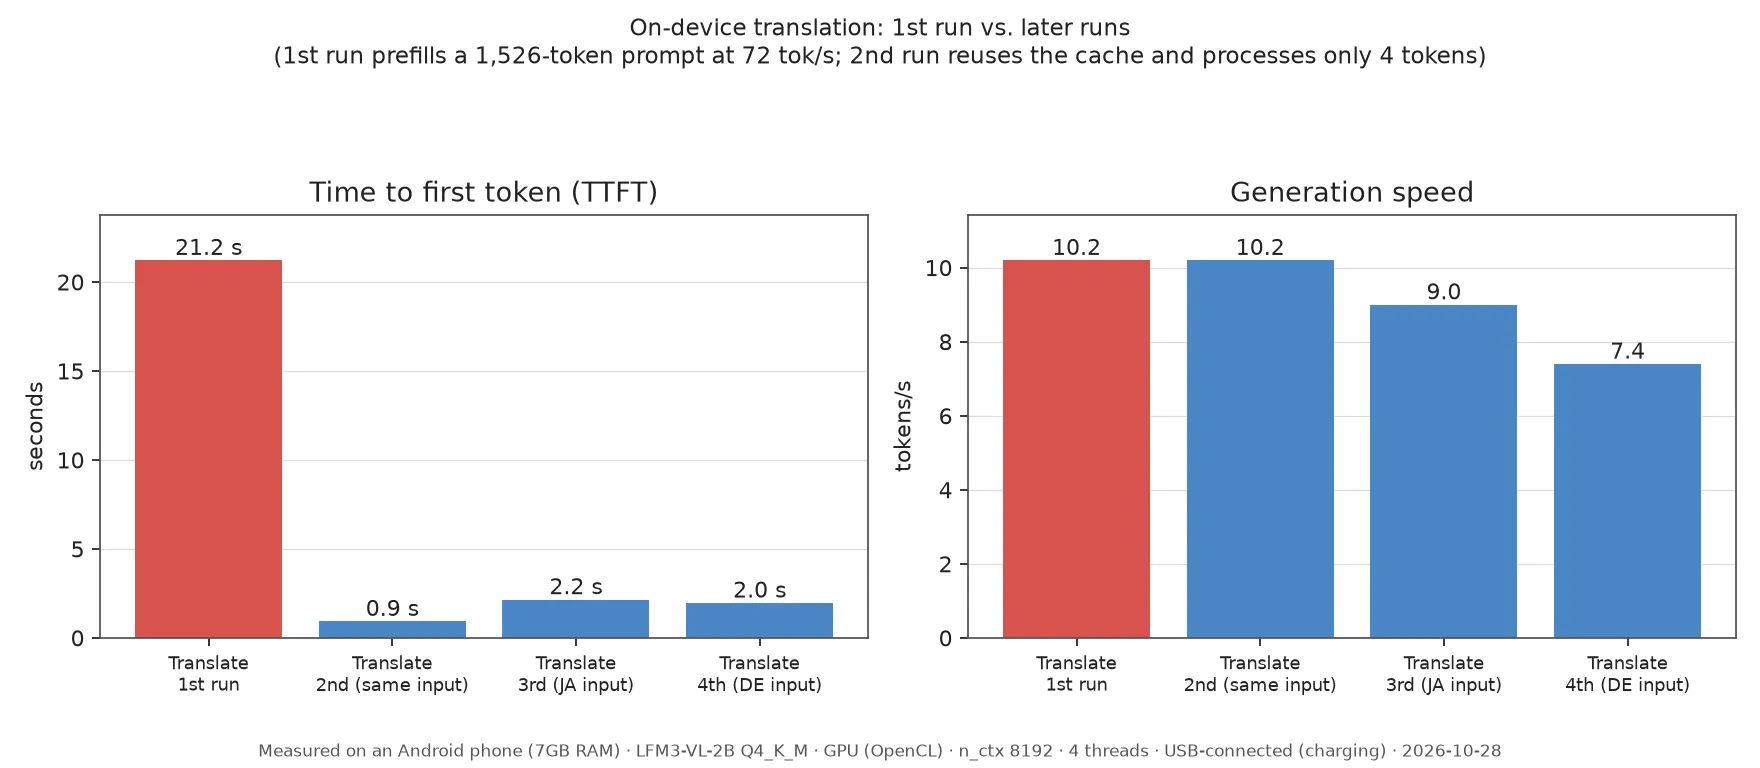
Penyebabnya adalah panjang prompt. Prompt terjemahan berukuran 1.526 token, dan ponsel memproses 72 tok/s, sehingga membacanya saja butuh sekitar 20 detik. Proses kedua lebih cepat karena cache bekerja.
Prompt-nya hampir tetap, jadi melakukan prefill saat layar dibuka mungkin dapat memperpendek waktu tunggu. Ini baru ide; belum kami coba.
Masalah 2: melambat saat terus dipakai
Setelah beberapa menit pemakaian, panas menurunkan kecepatan generasi, sehingga tugas berikutnya menunggu lebih lama.
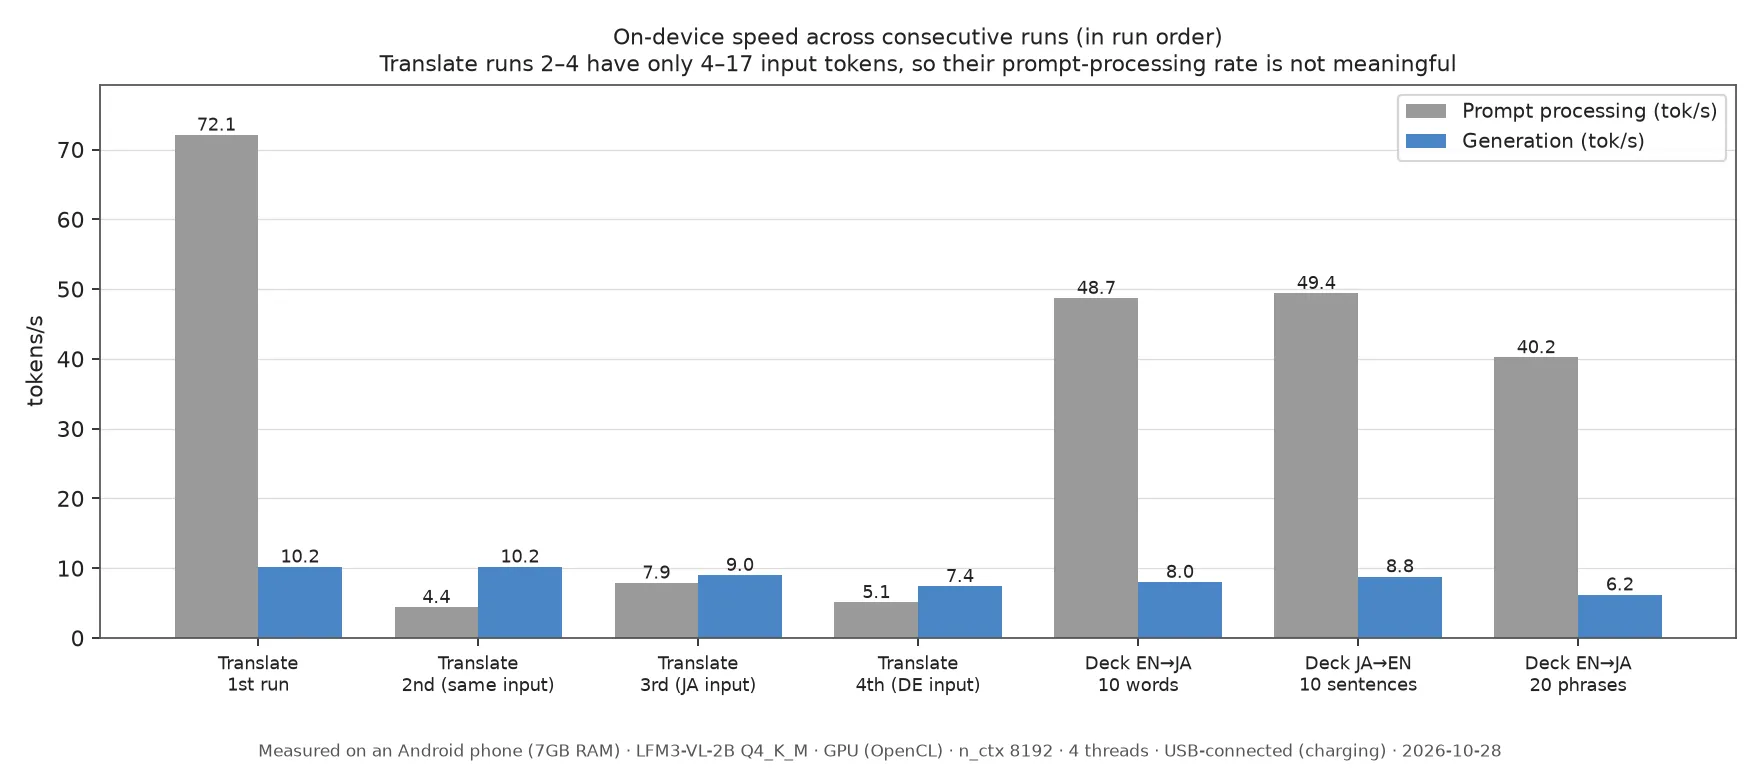
Kecepatan generasi turun dari 10,2 tok/s menjadi 6,2 tok/s. Dek berisi 20 frasa butuh 156,3 detik, dan bahkan dek berisi 10 kata butuh 66,6 detik.
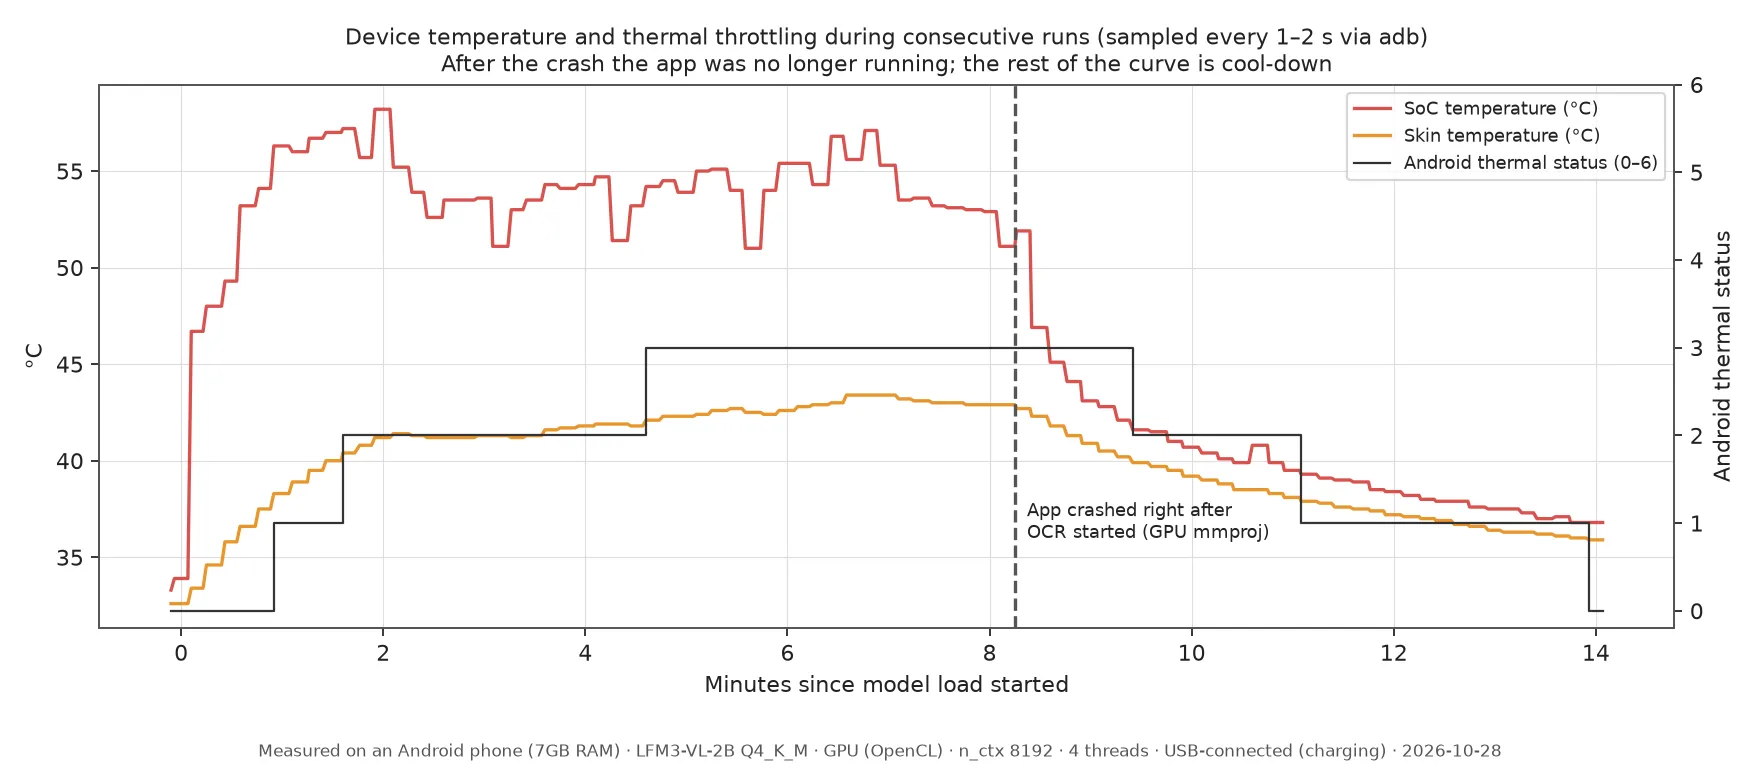
Status termal Android naik ke 1 setelah sekitar 1 menit, ke 2 setelah sekitar 1,6 menit, dan ke 3 setelah sekitar 4,6 menit. Suhu turun di paruh kedua grafik karena aplikasi crash saat pengujian gambar berikutnya.
Berjalan hanya dengan CPU
Angka-angka sejauh ini berasal dari proses di GPU. Dengan CPU saja, pembuatan dek menjadi lebih cepat, dari 64,2 menjadi 46,2 detik, tetapi pemakaian memori naik dan ponsel lebih cepat panas.
| GPU | Hanya CPU | |
|---|---|---|
| Waktu membuat dek 10 kata | 64,2 s | 46,2 s |
| Memori aplikasi (puncak) | 1052MB | 1923MB |
| Waktu hingga status termal 3 | Sekitar 2 mnt 35 dtk | Sekitar 1 mnt 35 dtk |
| Suhu SoC puncak | 57,4℃ | 60,4℃ |
Memori yang dimaksud adalah memori resident dan tidak termasuk bobot yang ditempatkan di GPU.
Masalah 3: terjemahan dan cara baca salah
Model ini mengikuti format JSON, tetapi isinya memiliki kesalahan yang mencolok. Ini masalah serius di aplikasi kartu hafalan, karena pelajar menghafal kesalahan itu apa adanya.
- Cara baca bahasa Jepang hampir tidak pernah benar. 空港 (bandara) menjadi
kū kōkun, dan 荷物 (bagasi) menjadinagō. - Terjemahan dari Inggris ke Jepang kadang tetap berupa teks romanisasi dan tidak menjadi bahasa Jepang.
- Model ini mengenali kalimat Jerman “Ich habe Hunger” sebagai bahasa Inggris.
- Dek Korea ke Jepang, yang diuji di PC, hanya menghasilkan 1 kartu dari 10, dengan bahasa Jepang di kolom Korea.
- Saat diminta membuat 10 contoh kalimat, model berhenti di 2 kartu pada GPU dan 8 kartu pada CPU saja.
Kesalahan yang sama muncul di PC, jadi kami menganggapnya sebagai batas model. Kegunaan yang dimaksud dalam model card juga hal-hal seperti membaca gambar dan dokumen, jadi terjemahan dan pembuatan dek mungkin memang bukan keunggulannya.
Perbandingan dengan model lain
Kami juga mencoba Gemma 4 E2B dan Qwen3.5-2B di ponsel.
| Model | Hasil di ponsel |
|---|---|
| Gemma 4 E2B (Google, sekitar 3,1GB) | Aplikasi dihentikan saat memuat, 4 dari 4 kali |
| Qwen3.5-2B (sekitar 1,3GB) | Berjalan, tetapi terjemahan butuh 577,4 s dan dek menghasilkan 1 sampai 2 kartu dari 10 |
Di PC, kualitas Gemma 4 E2B jauh lebih baik, misalnya membaca 飛行機 (pesawat) dengan benar sebagai hikōki. Namun di ponsel, model ini tidak mau dimuat dengan pengaturan GPU. Log percobaan pertama mencatat Android menghentikan aplikasi karena kehabisan memori. Kami tidak mencoba pengaturan CPU saja.
Mode berpikir
Kami juga mencoba mode berpikir dengan batas 1.024 token. Modelnya memberi jawaban, tetapi pemrosesan memakan waktu sekitar 3,5 sampai 7 kali lebih lama. Dek 10 kata naik dari 64,2 menjadi 257,7 detik, dan cara bacanya masih salah.
Masalah 4: bisa membaca teks, tetapi tiap gambar butuh 20 sampai 80 detik
Pengenalan teks adalah yang paling menjanjikan dari ketiga fitur. Dari 4 gambar uji, 2 gambar terbaca benar di setiap barisnya. Namun, tiap gambar butuh 20 sampai 80 detik.
| Gambar | Baris terbaca benar | Waktu |
|---|---|---|
| Menu berbahasa Inggris | 4 dari 9 | 77,7 s |
| Papan stasiun berbahasa Jepang | 5 dari 5 | 38,4 s |
| Menu berbahasa Korea | 5 dari 5 | 39,2 s |
| Teks Jepang kecil dan buram | 3 dari 4 | 18,6 s |
Semua gambar dibuat untuk pengujian ini. Pada menu berbahasa Inggris, harga di 5 baris terlewat, dan pada teks Jepang, 天ぷら terbaca sebagai 天ぶら.
Awalnya kami menjalankan bagian pemrosesan gambar di GPU, dan aplikasi crash karena kehabisan memori. Setelah dipindahkan ke CPU, keempat gambar berjalan sampai selesai. Namun saat ponsel sudah panas akibat terjemahan dan pembuatan dek, menu berbahasa Inggris yang sama butuh 122,6 detik.
Yang kami pelajari
- Menjalankan model di ponsel itu mungkin
- Terjemahan dan pembuatan dek kurang memadai, baik dari sisi waktu tunggu maupun kualitas
- Pengenalan teks menjanjikan dari sisi kualitas, tetapi waktu tunggunya lama
- Model yang lebih besar dengan kualitas bagus di PC mungkin tidak bisa dimuat di ponsel dengan RAM 7GB
Kesimpulan: bukan untuk LangDict
Saya memutuskan bahwa tetap memanggil Gemini API memberikan pengalaman pengguna yang lebih baik. Dengan local LLM, waktu tunggunya lama dan terjemahan serta cara bacanya banyak yang salah.
Meski begitu, saya merasa bisa memakainya langsung di tempat tanpa jaringan, seperti di pesawat, akan menjadi manfaat nyata bagi aplikasi belajar bahasa.
Detail teknis
Catatan untuk pembaca yang ingin mengetahui detail teknisnya.
- Model: LFM3-VL-2B Q4_K_M (1,10GB) dan mmproj F16 (0,38GB)
- Runtime: Expo dan llama.rn. Kami mengganti llama.cpp dengan versi yang mendukung LFM3 dan memperbaiki bug batasan JSON di llama.rn secara lokal
- Pengaturan generasi: temperature 0.1, top_k 50, repetition penalty 1.0. Rekomendasi resminya 1.1, tetapi kami mengubahnya karena JSON cenderung berhenti di tengah jalan
- Format keluaran: ditentukan dengan JSON schema
- PC: RTX 2060 6GB, memakai llama-server dan Vulkan
Sumber
Diperiksa pada 2026-10-31. Semua angka kecepatan, panas, dan pengenalan teks adalah hasil pengukuran kami sendiri.
- LiquidAI/LFM3-VL-2B (deskripsi resmi model)
- LiquidAI/LFM3-VL-2B-GGUF (berkas yang kami pakai)