Eseguire LFM3 su uno smartphone per vedere se può sostituire le funzioni di IA di LangDict
Abbiamo verificato se un local LLM, il piccolo modello LFM3 di Liquid AI eseguito direttamente sullo smartphone, potesse sostituire le funzioni di IA di LangDict, un’app per l’apprendimento delle lingue che sviluppo.
Funzionava, ma dopo i test ho deciso di non inserirlo nell’app.
Cosa abbiamo testato
LangDict è un’app di flashcard: si inseriscono le parole che si vogliono imparare e l’IA genera traduzioni, frasi di esempio e pronunce. Usa la Gemini API per tre funzioni.
| Funzione | Cosa fa |
|---|---|
| Traduzione | Traduce il testo inserito in un’altra lingua |
| Generazione di mazzi | Prende un tema come “Travel at the airport” e crea un gruppo di carte con parole, traduzioni e letture |
| Riconoscimento del testo | Trasforma il testo di una foto in testo modificabile (OCR) |
Abbiamo verificato se un local LLM potesse sostituirle.
Abbiamo esaminato tre aspetti:
- Se tutte e tre le funzioni girano sullo smartphone
- Tempi di attesa e velocità con uso continuo
- Qualità dell’output
Condizioni del test
| Voce | Dettagli |
|---|---|
| Smartphone | Smartphone Android (7GB di RAM) |
| Modello | LFM3-VL-2B (circa 1,5GB compreso mmproj) |
| Metodo | Un’app di test con gli stessi prompt di LangDict, misurata in carica |
| Esecuzioni | Una esecuzione per condizione (varianza non misurata) |
Considerate i numeri come indicativi. Le voci testate anche su PC sono contrassegnate come “su PC”.
Problema 1: la prima traduzione si blocca per circa 20 secondi
La prima traduzione dopo l’apertura dell’app ha impiegato 21,2 secondi per iniziare a produrre testo, e lo schermo sembrava bloccato. La seconda è partita in 0,9 secondi.
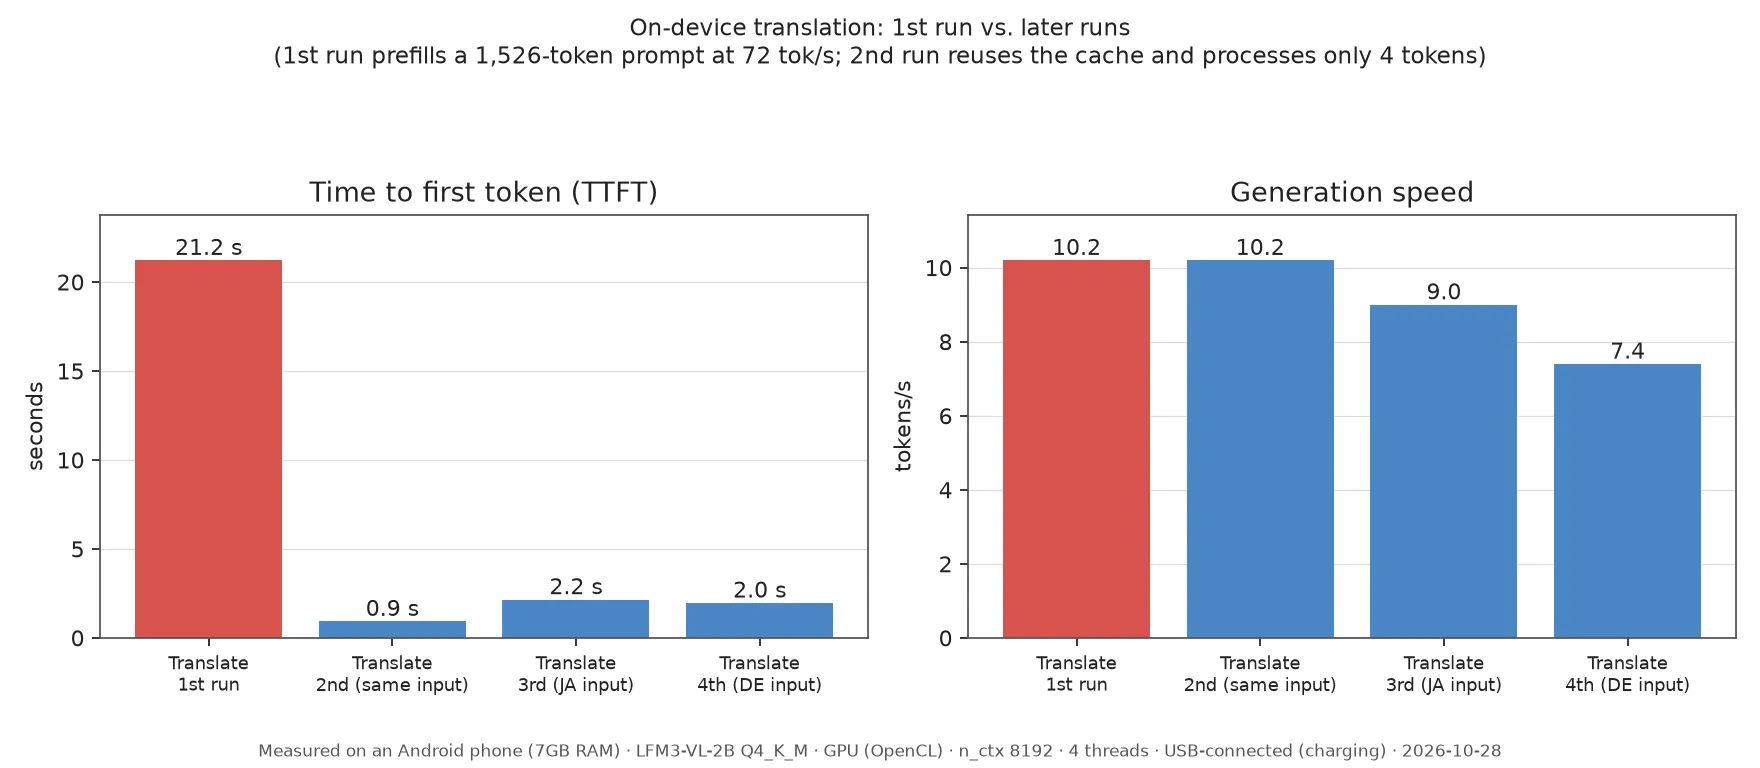
La causa era la lunghezza del prompt. Il prompt di traduzione è di 1.526 token e lo smartphone elabora 72 tok/s, quindi la sola lettura richiede circa 20 secondi. La seconda esecuzione è più veloce perché interviene la cache.
Il prompt è quasi fisso, quindi eseguirne il prefill all’apertura della schermata potrebbe ridurre l’attesa. È solo un’idea; non l’abbiamo ancora provata.
Problema 2: rallenta con l’uso continuato
Dopo alcuni minuti di utilizzo, il calore riduce la velocità di generazione, e i compiti successivi attendono di più.
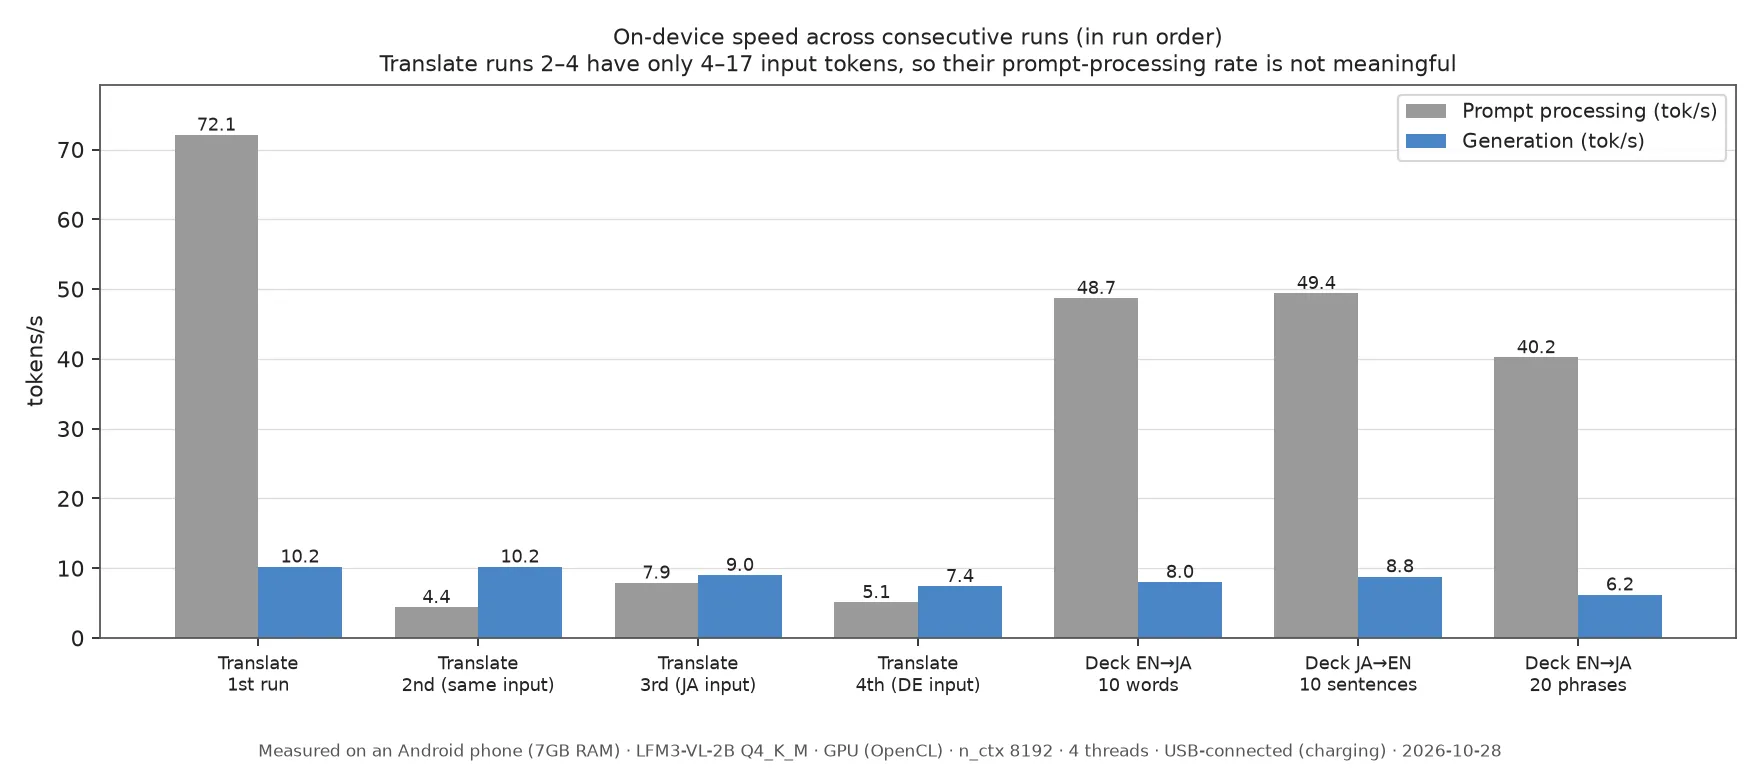
La velocità di generazione è scesa da 10,2 tok/s a 6,2 tok/s. Un mazzo di 20 frasi ha richiesto 156,3 secondi, e anche un mazzo di 10 parole ne ha richiesti 66,6.
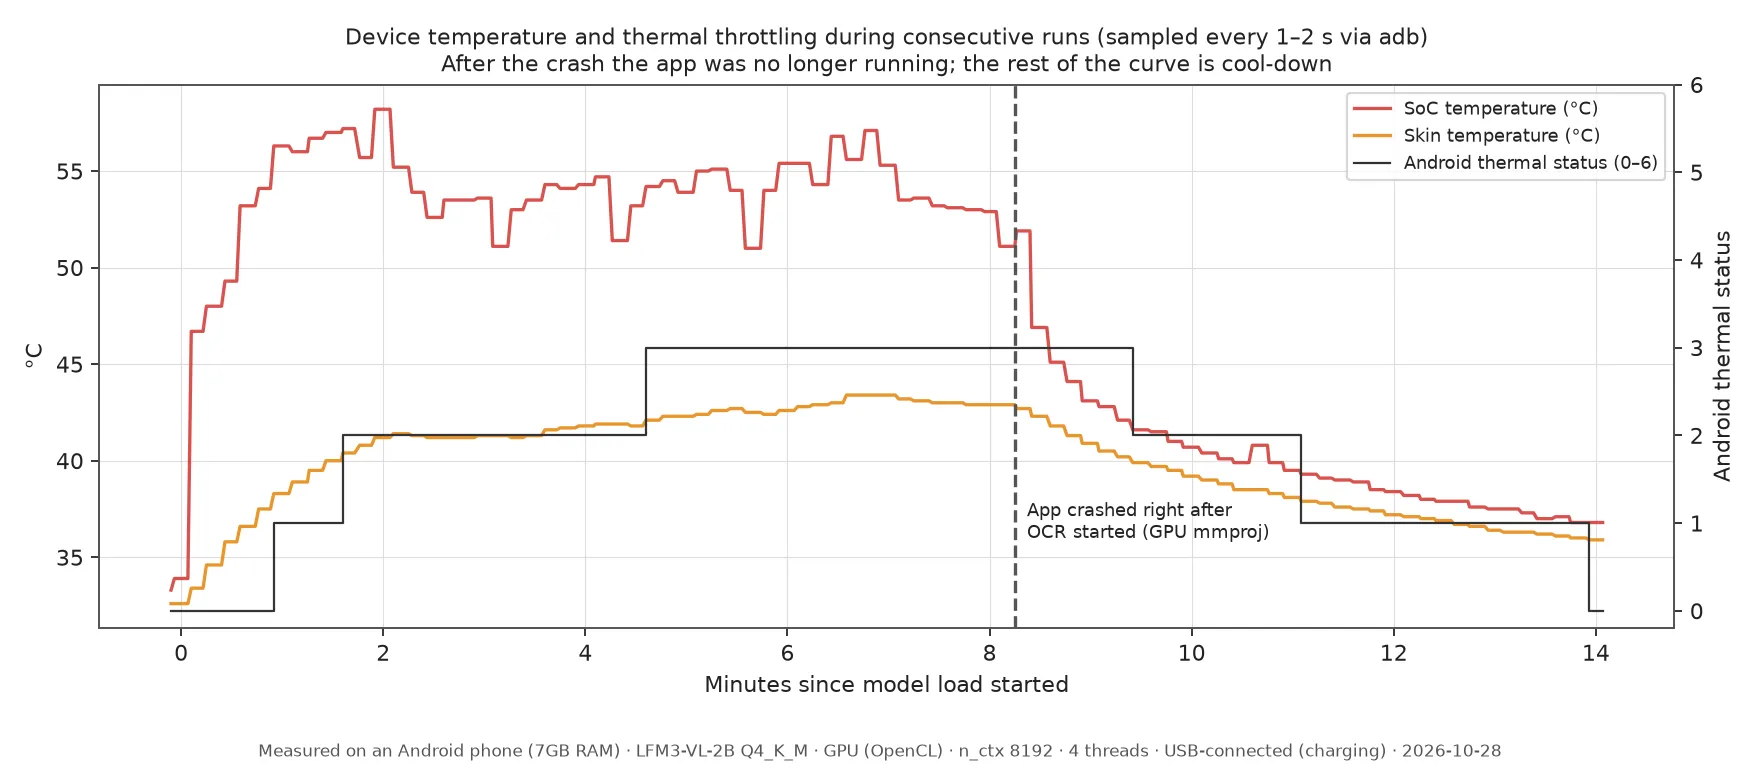
Lo stato termico di Android è salito a 1 dopo circa 1 minuto, a 2 dopo circa 1,6 minuti e a 3 dopo circa 4,6 minuti. La temperatura scende nella seconda metà del grafico perché l’app è andata in crash durante il test sulle immagini successivo.
Esecuzione solo su CPU
I numeri finora vengono dall’esecuzione su GPU. Solo su CPU, la generazione di un mazzo è diventata più veloce, da 64,2 a 46,2 secondi, ma l’uso di memoria è aumentato e lo smartphone si è scaldato prima.
| GPU | Solo CPU | |
|---|---|---|
| Tempo per generare un mazzo di 10 parole | 64,2 s | 46,2 s |
| Memoria dell’app (picco) | 1052MB | 1923MB |
| Tempo allo stato termico 3 | Circa 2 min 35 s | Circa 1 min 35 s |
| Temperatura massima del SoC | 57,4℃ | 60,4℃ |
La memoria è quella residente e non include i pesi collocati sulla GPU.
Problema 3: traduzioni e letture sono sbagliate
Il modello rispetta il formato JSON, ma il contenuto presenta errori evidenti. In un’app di flashcard è un problema serio, perché chi studia memorizza gli errori così come sono.
- Le letture del giapponese non erano quasi mai corrette. 空港 (aeroporto) è diventato
kū kōkun, e 荷物 (bagaglio) è diventatonagō. - Le traduzioni dall’inglese al giapponese a volte restavano in testo romanizzato invece di diventare giapponese.
- Ha identificato come inglese il tedesco “Ich habe Hunger”.
- Un mazzo da coreano a giapponese, testato su PC, ha prodotto solo 1 carta su 10, con giapponese nel campo coreano.
- Quando gli sono state chieste 10 frasi di esempio, si è fermato a 2 carte su GPU e a 8 solo su CPU.
Gli stessi errori sono comparsi su PC, quindi li consideriamo un limite del modello. Anche gli usi previsti nella scheda del modello sono cose come la lettura di immagini e documenti, perciò traduzione e generazione di mazzi potrebbero semplicemente non essere il suo punto di forza.
Confronto con altri modelli
Abbiamo provato sullo smartphone anche Gemma 4 E2B e Qwen3.5-2B.
| Modello | Risultato sullo smartphone |
|---|---|
| Gemma 4 E2B (Google, circa 3,1GB) | L’app è stata terminata durante il caricamento tutte e 4 le volte |
| Qwen3.5-2B (circa 1,3GB) | Funziona, ma la traduzione ha richiesto 577,4 s e i mazzi hanno prodotto da 1 a 2 carte su 10 |
Su PC, Gemma 4 E2B aveva una qualità molto migliore, per esempio leggeva correttamente 飛行機 (aeroplano) come hikōki. Sullo smartphone, però, non si caricava con l’impostazione GPU. Il log del primo tentativo registra Android che termina l’app per mancanza di memoria. Non abbiamo provato l’impostazione solo CPU.
Modalità di ragionamento
Abbiamo provato anche la modalità di ragionamento con un limite di 1.024 token. Restituiva risposte, ma l’elaborazione richiedeva circa da 3,5 a 7 volte più tempo. Un mazzo da 10 parole è passato da 64,2 a 257,7 secondi, e le letture erano ancora sbagliate.
Problema 4: sa leggere il testo, ma ogni immagine richiede da 20 a 80 secondi
Il riconoscimento del testo era la più promettente delle tre funzioni. Delle 4 immagini di prova, in 2 ha letto correttamente tutte le righe. Tuttavia, ogni immagine richiede da 20 a 80 secondi.
| Immagine | Righe lette correttamente | Tempo |
|---|---|---|
| Menu in inglese | 4 su 9 | 77,7 s |
| Cartello di stazione in giapponese | 5 su 5 | 38,4 s |
| Menu in coreano | 5 su 5 | 39,2 s |
| Testo giapponese piccolo e sfocato | 3 su 4 | 18,6 s |
Tutte le immagini sono state create per questo test. Nel menu in inglese ha omesso il prezzo in 5 righe, e nel testo giapponese ha letto 天ぷら come 天ぶら.
All’inizio abbiamo eseguito la parte di elaborazione delle immagini sulla GPU, e l’app è andata in crash per mancanza di memoria. Dopo averla spostata sulla CPU, tutte e 4 le immagini sono state elaborate fino in fondo. Ma quando lo smartphone era già caldo per traduzione e generazione di mazzi, lo stesso menu in inglese ha richiesto 122,6 secondi.
Cosa abbiamo imparato
- Eseguire il modello su uno smartphone è possibile
- Traduzione e generazione di mazzi non sono all’altezza né per i tempi di attesa né per la qualità
- Il riconoscimento del testo è promettente per la qualità, ma l’attesa è lunga
- Un modello più grande che ha una buona qualità su PC potrebbe non caricarsi su uno smartphone con 7GB di RAM
Conclusione: non per LangDict
Ho deciso che continuare a chiamare la Gemini API offre un’esperienza utente migliore. Con il local LLM le attese erano lunghe e traduzioni e letture contenevano molti errori.
Detto questo, ho sentito che poterlo usare sul momento dove non c’è rete, per esempio su un aereo, sarebbe un vantaggio reale per un’app di apprendimento delle lingue.
Dettagli tecnici
Note per i lettori che vogliono i dettagli tecnici.
- Modello: LFM3-VL-2B Q4_K_M (1,10GB) e mmproj F16 (0,38GB)
- Runtime: Expo e llama.rn. Abbiamo sostituito llama.cpp con una versione che supporta LFM3 e corretto localmente un bug dei vincoli JSON in llama.rn
- Impostazioni di generazione: temperature 0.1, top_k 50, repetition penalty 1.0. La raccomandazione ufficiale è 1.1, ma l’abbiamo cambiata perché il JSON tendeva a interrompersi a metà
- Formato di output: specificato con un JSON schema
- PC: RTX 2060 6GB, con llama-server e Vulkan
Fonti
Verificate il 2026-10-31. Tutti i numeri di velocità, calore e riconoscimento del testo sono nostre misurazioni.
- LiquidAI/LFM3-VL-2B (descrizione ufficiale del modello)
- LiquidAI/LFM3-VL-2B-GGUF (i file che abbiamo usato)