LFM3 をスマホで動かして、LangDict の AI 機能を置き換えられるか試した
公開日:
Liquid AI の小型モデル LFM3 をスマホ上で動かすローカル LLM で、自作の語学アプリ LangDict の AI 機能を置き換えられるか検証しました。
動作はしましたが、検証の結果、私はアプリへの組み込みを見送りました。
何を確かめたか
LangDict は、覚えたい言葉を入れると AI が訳や例文、発音を作ってくれる単語帳アプリです。次の3つの機能で Gemini API を使っています。
| 機能 | 何をするか |
|---|---|
| 翻訳 | 入力した文を別の言語に訳す |
| 単語帳づくり | 「空港での旅行」のようなテーマを入れると、単語と訳と読み方のカードをまとめて作る |
| 文字の読み取り | 写真に写った文字をテキストにする(OCR) |
これらをローカル LLM に置き換えられるかを検証しました。
確かめたのは次の3点です。
- 3つの機能がスマホ上で動くか
- 待ち時間と、連続使用時の速度
- 出力の質
前提条件
| 項目 | 内容 |
|---|---|
| 使ったスマホ | Android 端末(RAM 7GB) |
| モデル | LFM3-VL-2B(mmproj 込みで約1.5GB) |
| 測り方 | LangDict と同じプロンプトを使う検証用アプリで、充電しながら計測 |
| 回数 | 各条件1回(ばらつきは未計測) |
数字は目安です。PC でも試した項目は「PC では」と書きます。
問題1:初回の翻訳だけ約20秒固まる
アプリを開いて最初に翻訳すると、訳が出始めるまで21.2秒かかり、画面が固まったように見えました。2回目は0.9秒で出始めます。
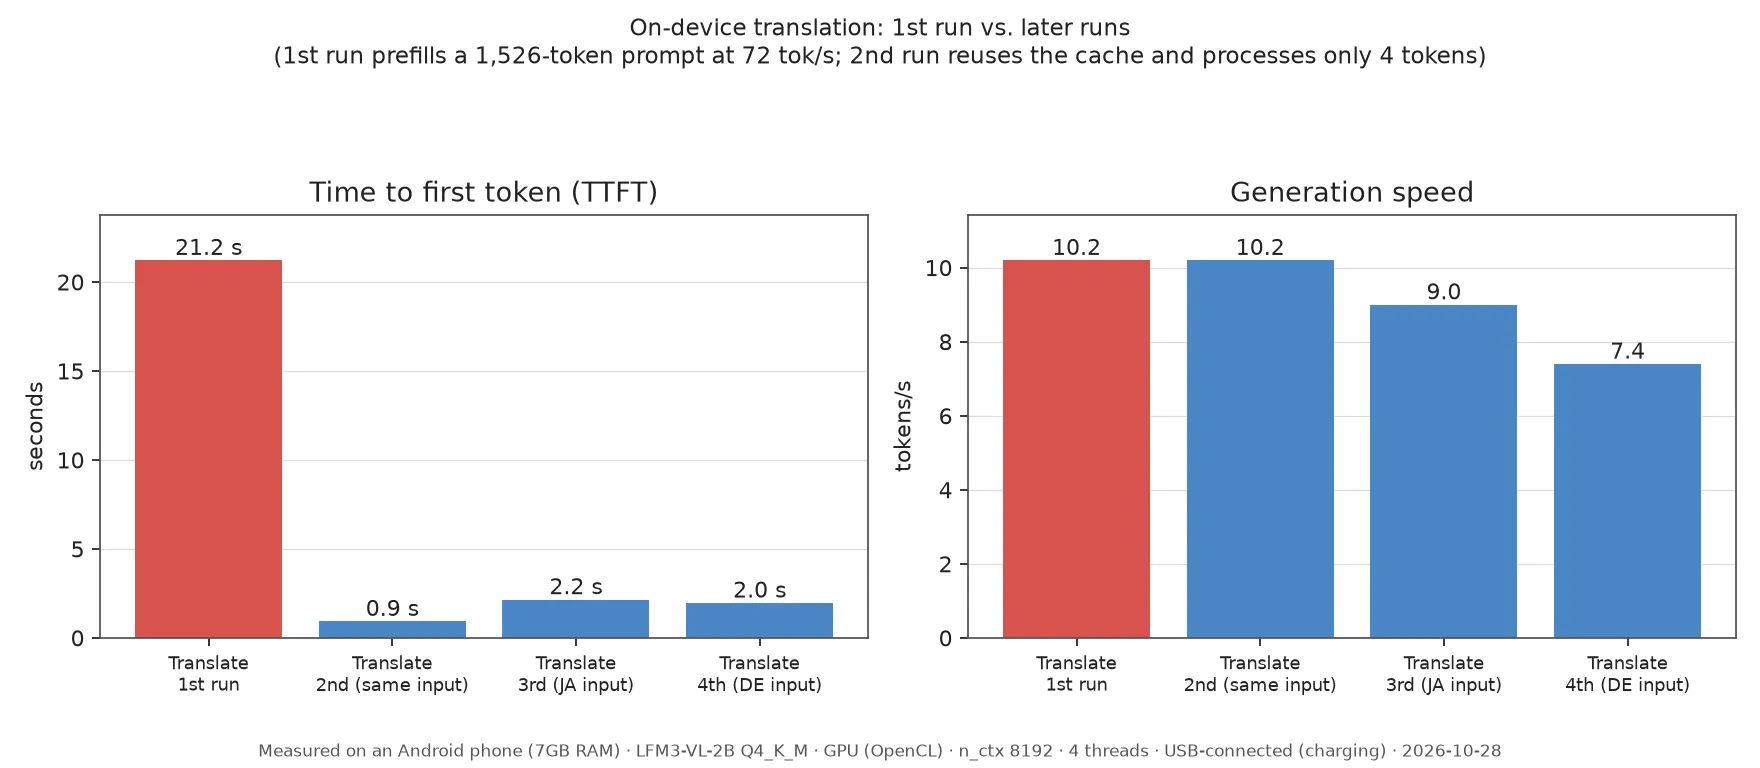
原因はプロンプトの長さでした。翻訳のプロンプトは1526トークンあり、スマホの処理速度は 72 tok/s なので、読み込むだけで約20秒かかります。2回目はキャッシュが効くので速くなります。
プロンプトはほぼ固定なので、画面を開いたときに先読みすれば短縮できるかもしれません。これは案で、まだ試していません。
問題2:続けて使うと遅くなる
数分続けて使うと発熱で生成速度が落ち、後の処理ほど待たされます。
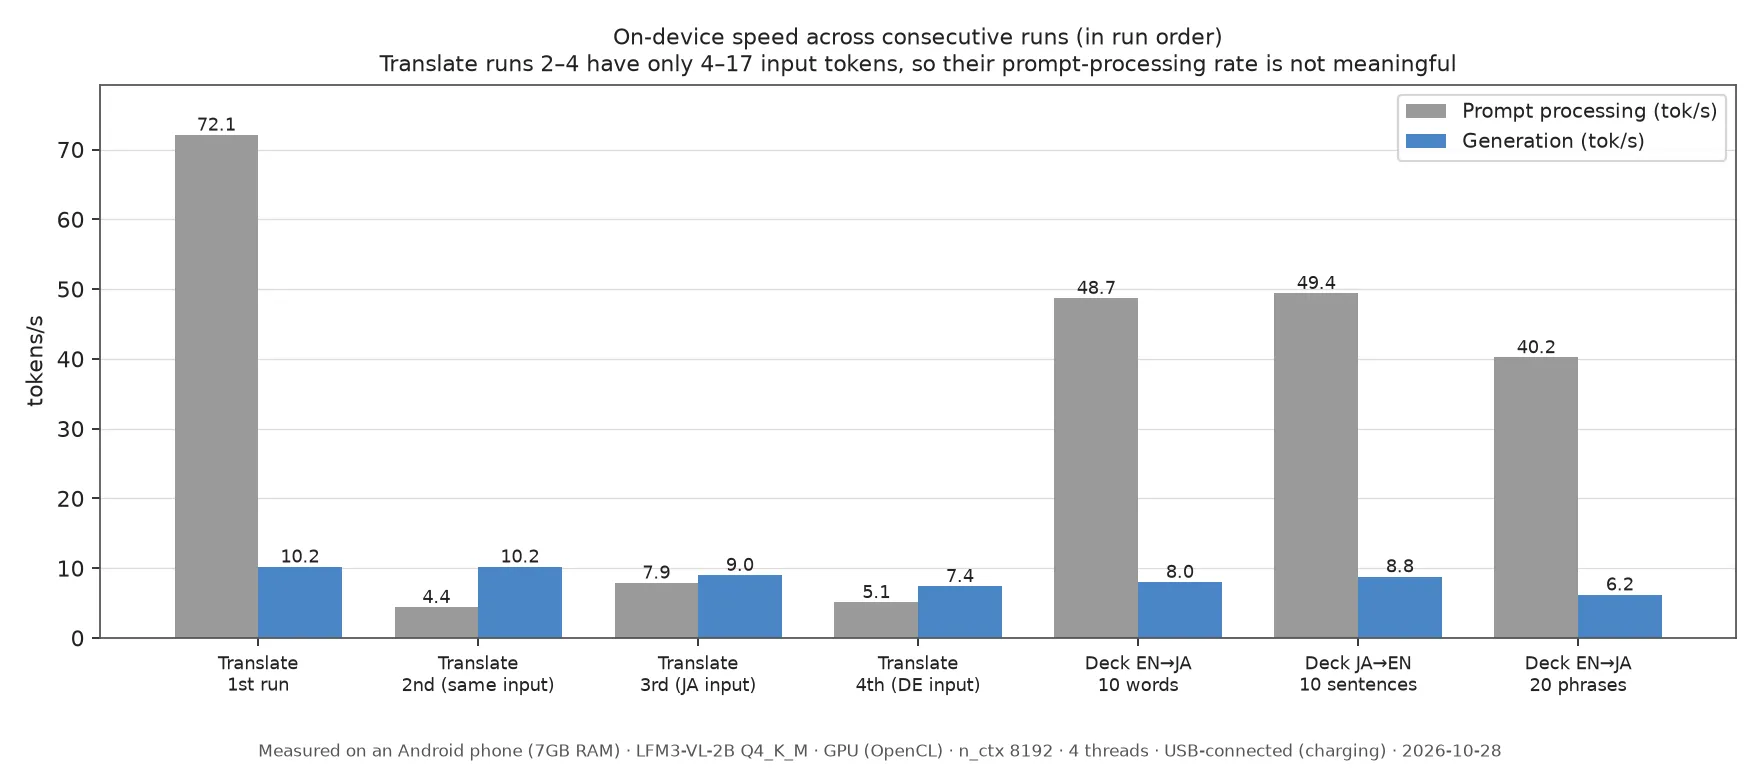
生成速度は 10.2 tok/s から 6.2 tok/s まで落ちました。フレーズ20枚の単語帳を作るのに156.3秒かかっています。単語10枚の単語帳でも66.6秒です。
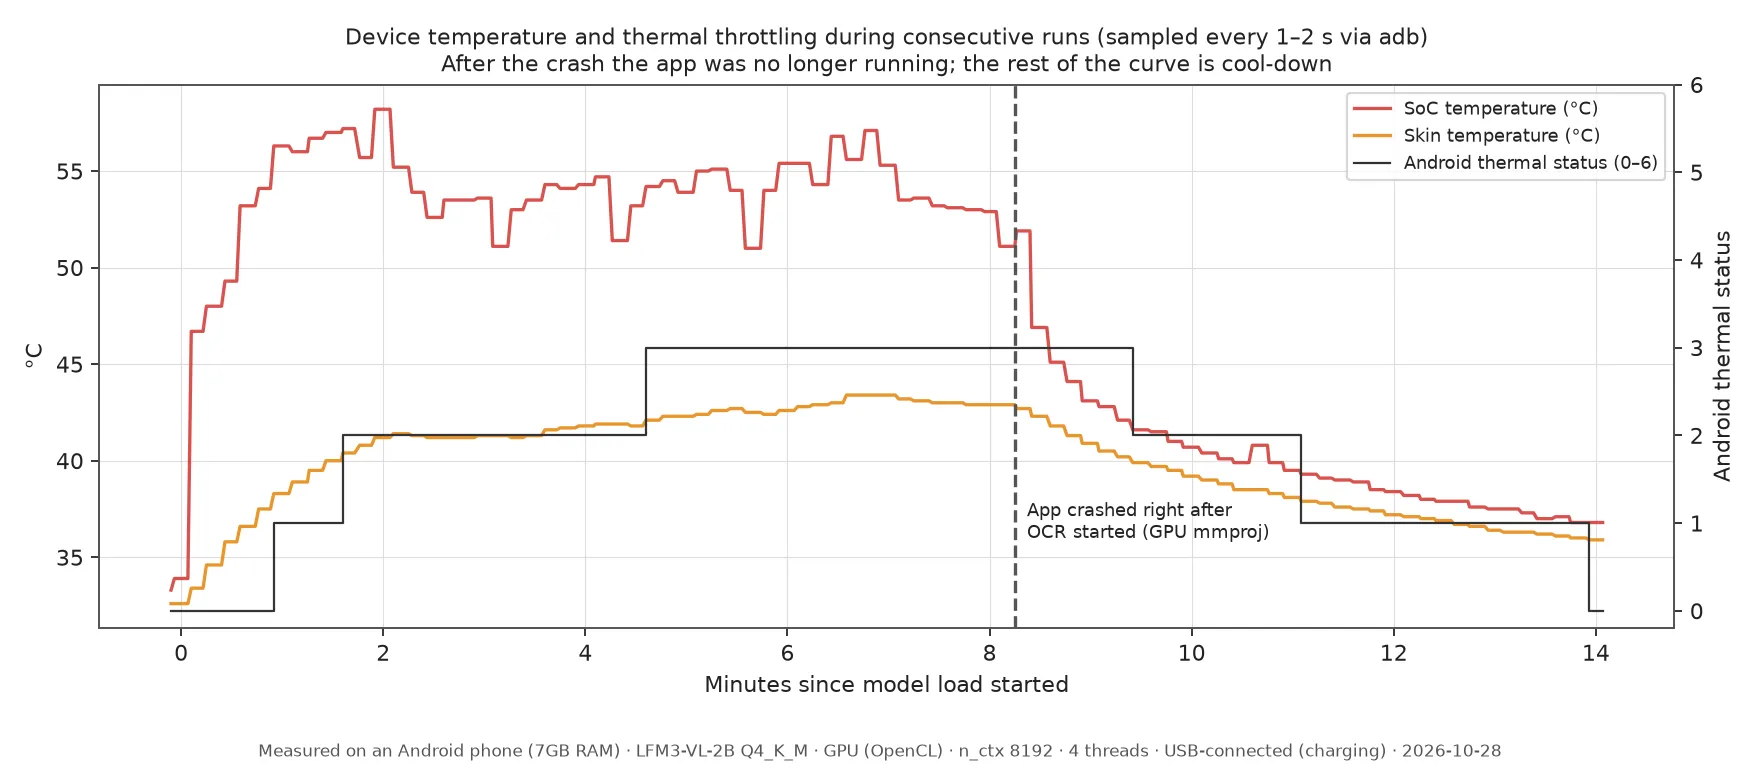
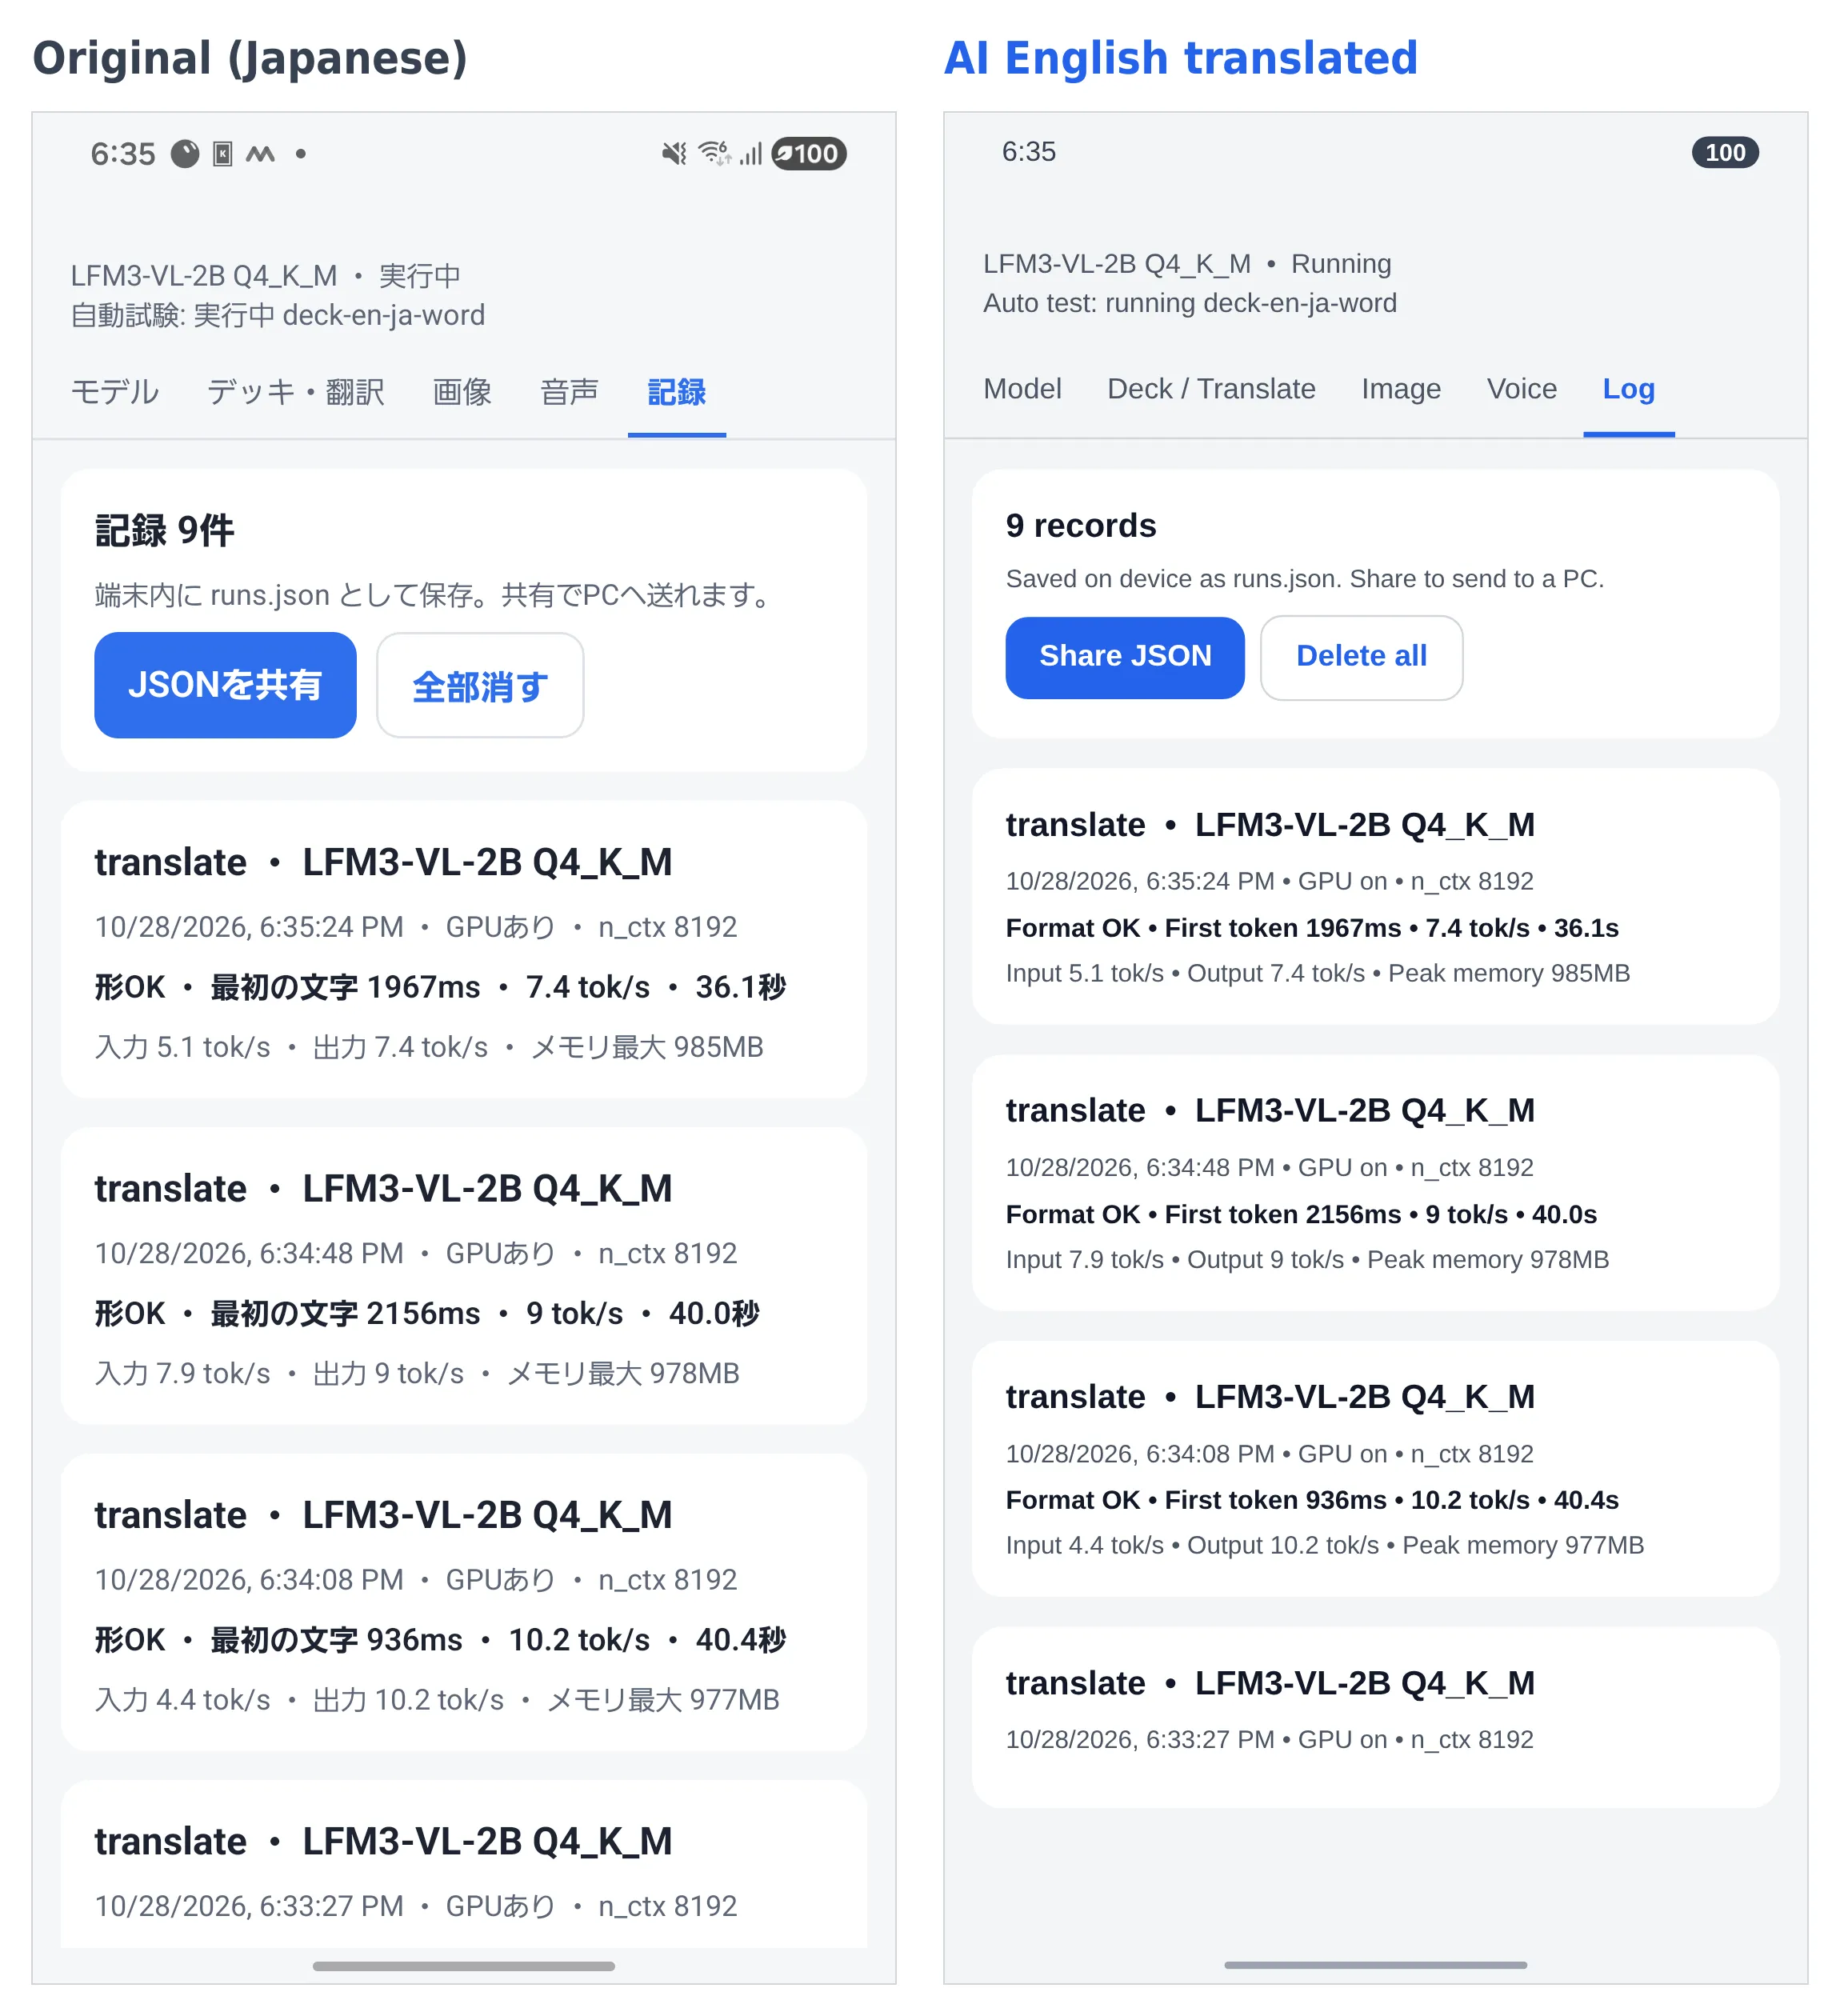
Android の発熱段階は、開始から約1分で1、約1.6分で2、約4.6分で3まで上がりました。グラフの後半で温度が下がっているのは、次の画像の試験でアプリが落ちたためです。
CPU のみで動かした場合
ここまでの数字は GPU で動かしたものです。CPU のみにすると単語帳づくりは64.2秒から46.2秒に速くなりましたが、メモリ使用量が増え、発熱も早まりました。
| GPU を使う | CPU だけ | |
|---|---|---|
| 単語10枚の単語帳にかかった時間 | 64.2秒 | 46.2秒 |
| アプリが使ったメモリ(最大) | 1052MB | 1923MB |
| 発熱段階3まで | 約2分35秒 | 約1分35秒 |
| SoC の最高温度 | 57.4℃ | 60.4℃ |
メモリは常駐分で、GPU に置いた重みは含みません。
問題3:訳や読み仮名が間違う
JSON の形式は守れますが、中身に誤りが目立ちました。単語帳アプリでは間違いをそのまま覚えてしまうので大きな問題です。
- 日本語の読み仮名がほとんど正しく出ませんでした。「空港」が
kū kōkun、「荷物」がnagōになりました。 - 英語から日本語への訳が日本語にならずローマ字のままになることがありました。
- ドイツ語の「Ich habe Hunger」を英語と判定しました。
- 韓国語から日本語への単語帳は PC で試すと10枚のうち1枚しかできず、韓国語の欄に日本語が入りました。
- 例文を10枚頼むと、GPU のときは2枚、CPU だけのときは8枚で終わりました。
同じ間違いは PC でも出たので、モデルの力の問題と見ています。モデルカードの想定用途も画像や文書の読み取りなどで、翻訳や単語帳づくりは得意ではないのかもしれません。
ほかのモデルとの比較
Gemma 4 E2B と Qwen3.5-2B もスマホで試しました。
| モデル | スマホでの結果 |
|---|---|
| Gemma 4 E2B(Google、約3.1GB) | 4回とも読み込みの途中でアプリが終了した |
| Qwen3.5-2B(約1.3GB) | 動くが、翻訳に577.4秒かかり、単語帳は10枚のうち1〜2枚 |
Gemma 4 E2B は PC では「飛行機」を hikōki と正しく読むなど、質はかなり良いものでした。ただ、スマホでは GPU を使う設定で読み込めませんでした。1回目のログには、Android がメモリ不足でアプリを終了させた記録があります。CPU だけの設定は試していません。
思考モード
思考モードも上限1024トークンで試しました。答えは返りますが、処理時間は約3.5〜7倍に延びます。単語10枚の単語帳は64.2秒から257.7秒になり、読み仮名は崩れたままでした。
問題4:文字は読めるが、1枚に20〜80秒かかる
文字の読み取りは、3つの機能の中で一番見込みがありました。4枚の試験画像のうち、2枚はすべての行を正しく読めています。ただ、1枚読むのに20〜80秒かかります。
| 画像 | 正しく読めた行 | かかった時間 |
|---|---|---|
| 英語のメニュー | 9行のうち4行 | 77.7秒 |
| 日本語の駅の案内 | 5行のうち5行 | 38.4秒 |
| 韓国語のメニュー | 5行のうち5行 | 39.2秒 |
| 小さくぼかした日本語 | 4行のうち3行 | 18.6秒 |
画像はすべて試験用に作ったものです。英語のメニューは5行とも値段を読み落とし、日本語は「天ぷら」を「天ぶら」と読みました。
最初は画像を処理する部分を GPU で動かしていて、メモリが足りずアプリが落ちました。CPU に移すと、4枚とも最後まで動きました。ただ、翻訳や単語帳づくりのあとで熱くなっていると、同じ英語のメニューに122.6秒かかります。
わかったこと
- スマホ上でモデルを動かすこと自体はできる
- 翻訳と単語帳づくりは、待ち時間と質の両方が足りない
- 文字の読み取りは、質には見込みがあるが、待ち時間が長い
- PC で質の良い大きなモデルは、RAM 7GB のスマホでは読み込めないことがある
結論:LangDict では使わない
今までどおり Gemini API を呼ぶほうが、ユーザー体験が良いと判断しました。ローカル LLM では待ち時間が長く、訳や読み仮名の間違いも多かったためです。
ただ、飛行機の中のようにネットワークがない場所でもとっさに使えるのは、語学アプリにとってメリットになると感じました。
細かい条件
技術的な詳細を知りたい人向けの補足です。
- モデル: LFM3-VL-2B Q4_K_M(1.10GB)と mmproj F16(0.38GB)
- 実行環境: Expo と llama.rn。llama.cpp を LFM3 に対応したものに差し替え、llama.rn の JSON 制約の不具合を手元で修正した
- 生成の設定: 温度0.1、top_k 50、繰り返し抑制1.0。公式の推奨は1.1だが、JSON が途中で止まりやすかったため変えた
- 出力の形式: JSON スキーマで指定した
- PC: RTX 2060 6GB。llama-server と Vulkan を使った
出典
確認日は2026-10-31です。速さ、発熱、読み取りの数字はすべて自分で測った値です。
- LiquidAI/LFM3-VL-2B(モデルの公式説明)
- LiquidAI/LFM3-VL-2B-GGUF(使ったデータ)