在手機上執行 LFM3,看它能否取代 LangDict 的 AI 功能
我們測試了 local LLM,也就是在手機本機上執行的 Liquid AI 小型模型 LFM3,能否取代 LangDict 的 AI 功能。LangDict 是我開發的一款語言學習應用程式。
它可以執行,但經過測試,我決定不把它放進應用程式。
測試內容
LangDict 是一款字卡應用程式:輸入想學的單字,AI 會產生翻譯、例句與讀音。它在三個功能中使用 Gemini API。
| 功能 | 作用 |
|---|---|
| 翻譯 | 將輸入的文字翻譯成另一種語言 |
| 牌組生成 | 根據「Travel at the airport」這類主題,批次建立包含單字、翻譯與讀音的卡片 |
| 文字辨識 | 將照片中的文字轉換為可編輯的文字(OCR) |
我們測試了 local LLM 能否取代這些功能。
我們檢視了三件事:
- 三個功能能否都在手機上執行
- 連續使用時的等待時間與速度
- 輸出品質
測試條件
| 項目 | 詳情 |
|---|---|
| 手機 | Android 手機(7GB RAM) |
| 模型 | LFM3-VL-2B(含 mmproj 約 1.5GB) |
| 方法 | 使用與 LangDict 相同提示詞的測試應用程式,在充電狀態下量測 |
| 次數 | 每種條件執行一次(未量測變異) |
數值僅供參考。同時在 PC 上測試過的項目標示為「PC 上」。
問題 1:第一次翻譯會卡住約 20 秒
開啟應用程式後的第一次翻譯,過了 21.2 秒才開始輸出文字,畫面看起來像是當機了。第二次只花 0.9 秒就開始輸出。
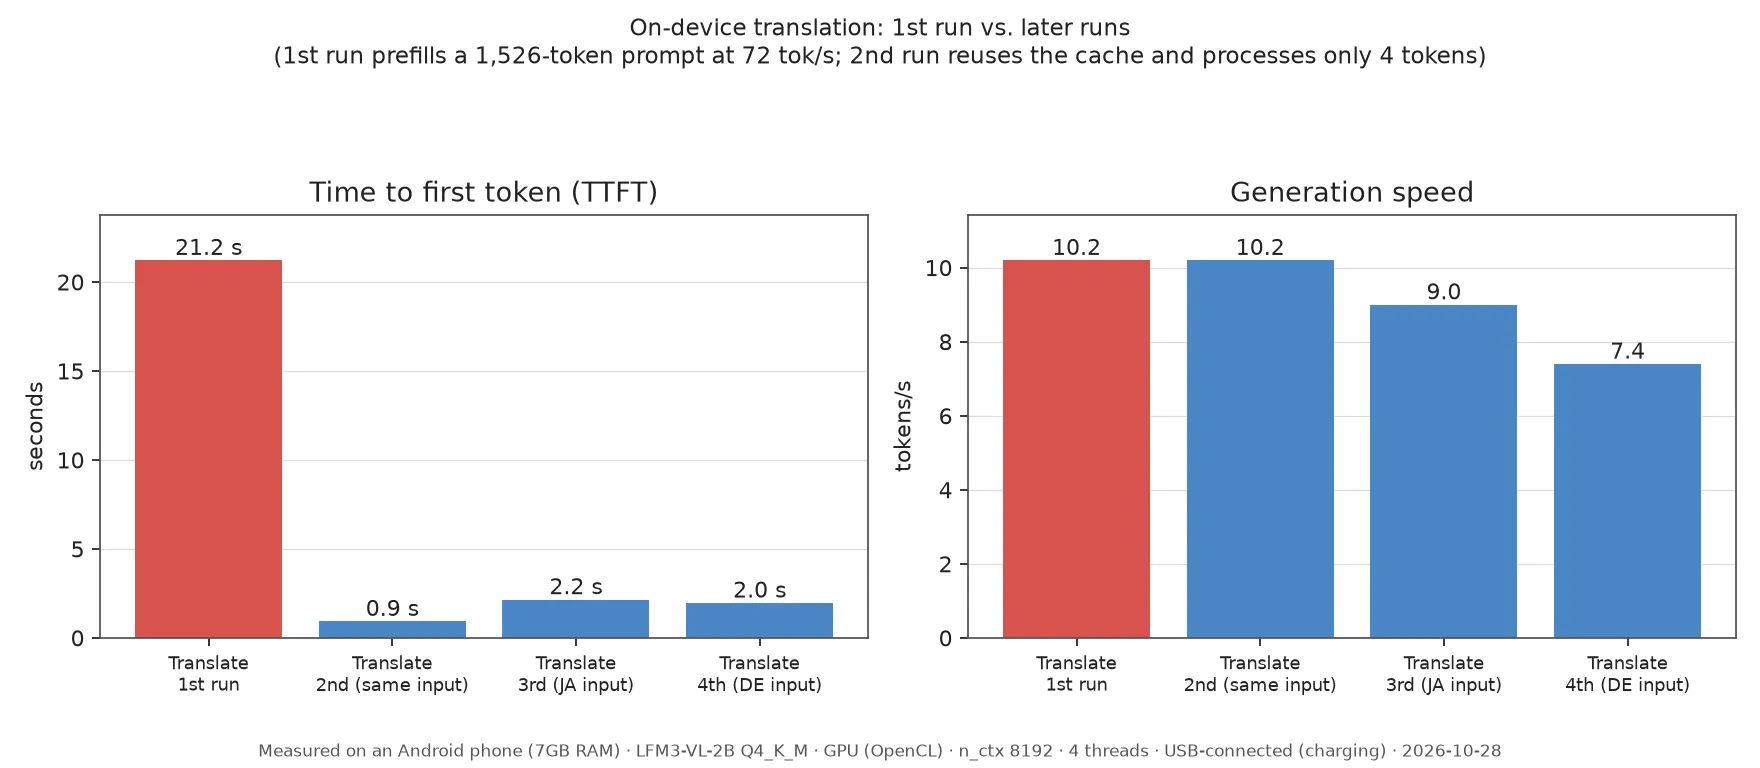
原因在於提示詞的長度。翻譯提示詞有 1,526 個 token,而手機的處理速度是 72 tok/s,光讀取它就要約 20 秒。第二次比較快,是因為快取生效了。
提示詞幾乎是固定的,所以在開啟畫面時預先處理它,也許能縮短等待。這只是一個想法,我們還沒有試過。
問題 2:持續使用會變慢
使用幾分鐘後,發熱會降低生成速度,後面的任務等待時間更長。
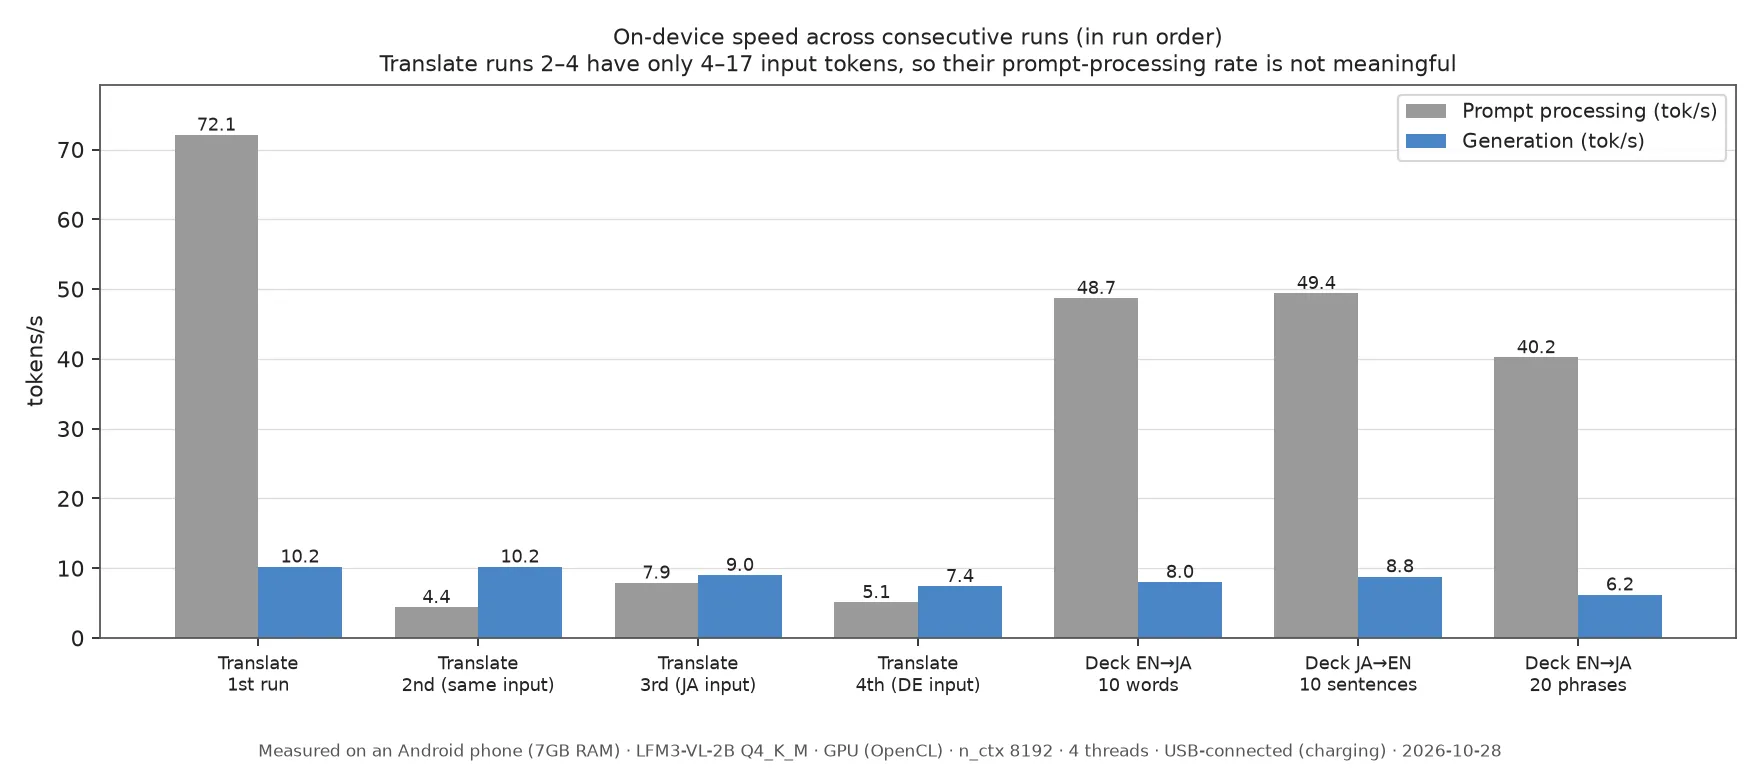
生成速度從 10.2 tok/s 降到 6.2 tok/s。生成 20 個片語的牌組花了 156.3 秒,即使是 10 個單字的牌組也花了 66.6 秒。
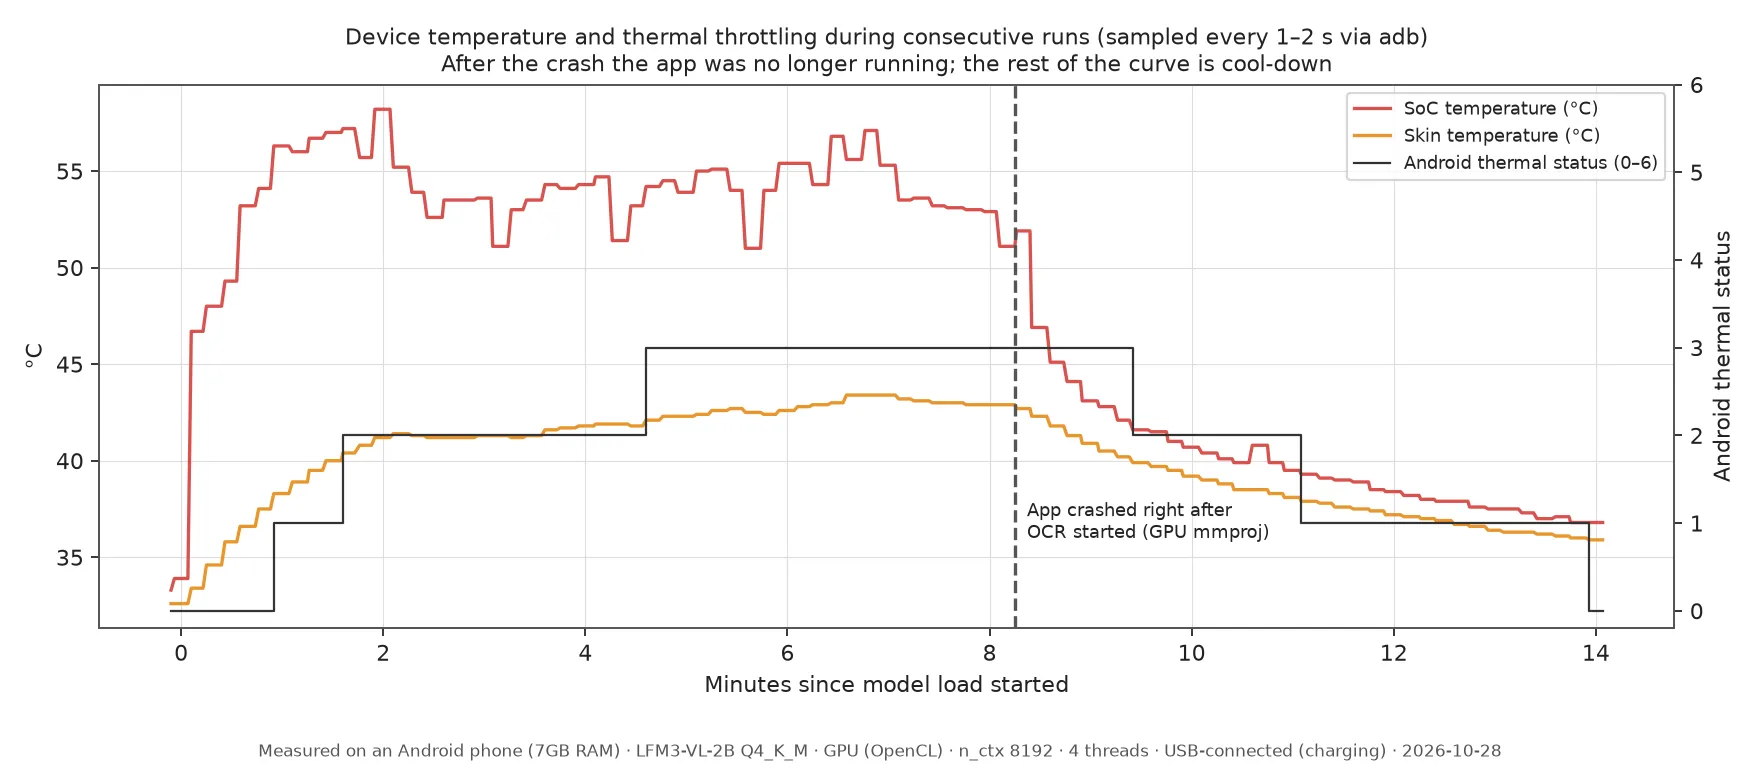
Android 的熱狀態約 1 分鐘後升到 1,約 1.6 分鐘後升到 2,約 4.6 分鐘後升到 3。圖的後半段溫度下降,是因為應用程式在接下來的圖像測試中當掉了。
僅使用 CPU 執行
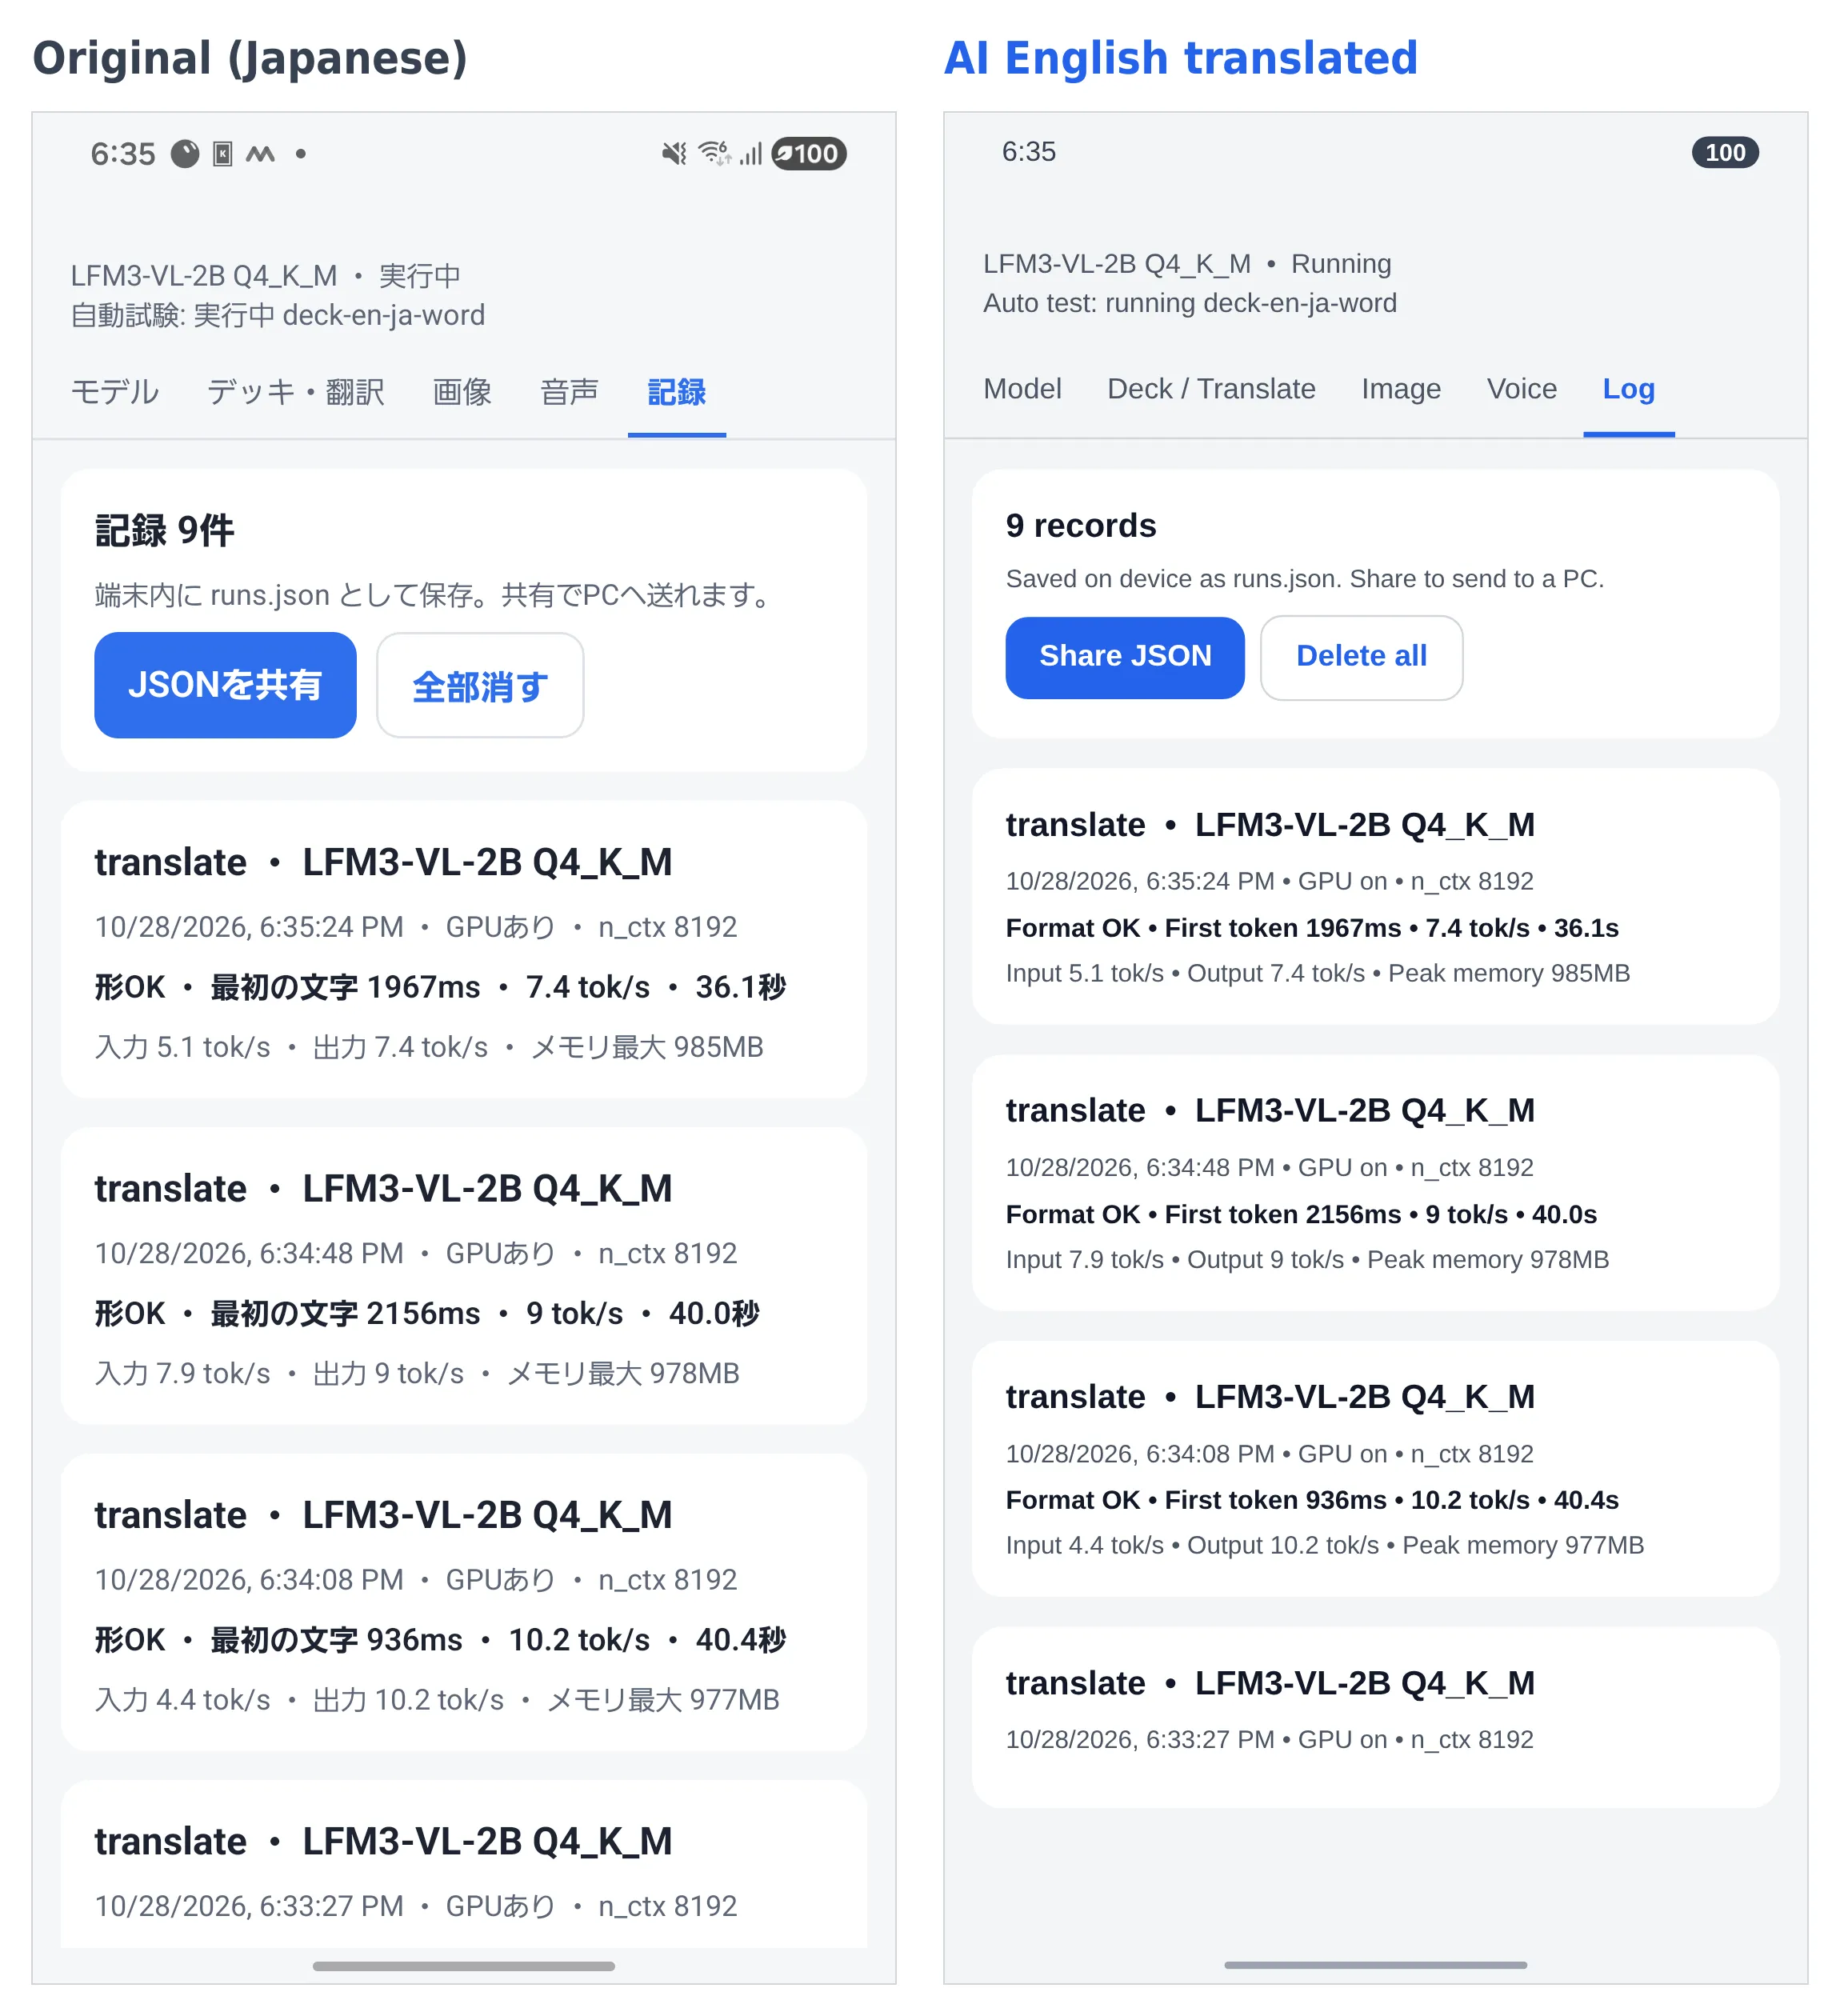
到目前為止的數值都是在 GPU 上執行得到的。僅用 CPU 時,牌組生成變快了,從 64.2 秒縮短到 46.2 秒,但記憶體用量增加,手機也更早發熱。
| GPU | 僅 CPU | |
|---|---|---|
| 生成 10 個單字牌組的時間 | 64.2 s | 46.2 s |
| 應用程式記憶體(峰值) | 1052MB | 1923MB |
| 達到熱狀態 3 的時間 | 約 2 分 35 秒 | 約 1 分 35 秒 |
| SoC 峰值溫度 | 57.4℃ | 60.4℃ |
記憶體為常駐記憶體,不包含放在 GPU 上的權重。
問題 3:翻譯與讀音有錯誤
模型能維持 JSON 格式,但內容有明顯錯誤。這在字卡應用程式中是嚴重的問題,因為學習者會把錯誤原封不動地記起來。
- 日語讀音幾乎沒有正確的。空港(機場)變成了
kū kōkun,荷物(行李)變成了nagō。 - 英語到日語的翻譯有時停留在羅馬字,沒有變成日語。
- 它把德語的 “Ich habe Hunger” 辨識成了英語。
- 在 PC 上測試的韓語到日語牌組,10 張只生成了 1 張,且韓語欄位裡是日語。
- 要求產生 10 個例句時,GPU 上停在 2 張,僅 CPU 時停在 8 張。
PC 上也出現了同樣的錯誤,所以我們認為這是模型本身的限制。模型卡中的預期用途也是讀取圖像與文件之類,翻譯與牌組生成可能本來就不是它的強項。
與其他模型的比較
我們也在手機上試了 Gemma 4 E2B 與 Qwen3.5-2B。
| 模型 | 在手機上的結果 |
|---|---|
| Gemma 4 E2B(Google,約 3.1GB) | 4 次載入過程中應用程式都被終止 |
| Qwen3.5-2B(約 1.3GB) | 能執行,但翻譯花了 577.4 秒,牌組 10 張只生成 1 到 2 張 |
在 PC 上,Gemma 4 E2B 的品質好得多,例如能正確讀出飛行機(飛機)的讀音 hikōki。但在手機上,使用 GPU 設定時它無法載入。第一次嘗試的日誌記錄了 Android 因記憶體不足而終止應用程式。我們沒有試僅用 CPU 的設定。
思考模式
我們也以 1,024 token 為上限試了思考模式。它能給出答案,但處理時間約為 3.5 到 7 倍。10 個單字的牌組從 64.2 秒變成 257.7 秒,讀音仍然是錯的。
問題 4:能讀取文字,但每張圖片要 20 到 80 秒
文字辨識是三個功能中最有希望的。4 張測試圖片中,有 2 張每一行都讀對了。但是每張圖片需要 20 到 80 秒。
| 圖片 | 讀對的行數 | 時間 |
|---|---|---|
| 英文菜單 | 9 行中的 4 行 | 77.7 s |
| 日語車站標示 | 5 行中的 5 行 | 38.4 s |
| 韓語菜單 | 5 行中的 5 行 | 39.2 s |
| 小而模糊的日語文字 | 4 行中的 3 行 | 18.6 s |
所有圖片都是為本次測試製作的。在英文菜單上,它漏掉了 5 行的價格;在日語文字中,它把天ぷら讀成了天ぶら。
起初我們讓圖像處理部分在 GPU 上執行,應用程式因記憶體不足而當掉。改到 CPU 後,4 張圖片都跑完了。但當手機已經因翻譯與牌組生成而發熱時,同一張英文菜單花了 122.6 秒。
我們學到了什麼
- 在手機上執行模型是可行的
- 翻譯與牌組生成在等待時間與品質上都不達標
- 文字辨識在品質上有希望,但等待時間長
- 在 PC 上品質不錯的較大模型,可能無法在 7GB RAM 的手機上載入
結論:不用於 LangDict
我認為繼續呼叫 Gemini API 能帶來更好的使用者體驗。使用 local LLM 時,等待時間長,翻譯與讀音錯誤很多。
不過我覺得,在沒有網路的地方也能立即使用,例如在飛機上,對語言學習應用程式來說會是實實在在的好處。
技術細節
寫給想了解技術細節的讀者。
- 模型:LFM3-VL-2B Q4_K_M(1.10GB)與 mmproj F16(0.38GB)
- 執行環境:Expo 與 llama.rn。我們將 llama.cpp 換成支援 LFM3 的版本,並在本機修正了 llama.rn 中的 JSON 約束 bug
- 生成設定:temperature 0.1、top_k 50、repetition penalty 1.0。官方建議值是 1.1,但由於 JSON 容易中途停止,我們做了更動
- 輸出格式:以 JSON schema 指定
- PC:RTX 2060 6GB,使用 llama-server 與 Vulkan
來源
2026-10-31 確認。所有速度、發熱與文字辨識的數值均為我們自己的量測結果。
- LiquidAI/LFM3-VL-2B(官方模型說明)
- LiquidAI/LFM3-VL-2B-GGUF(我們使用的檔案)