Запуск LFM3 на телефоне: сможет ли он заменить ИИ-функции LangDict
Мы проверили, сможет ли local LLM, небольшая модель LFM3 от Liquid AI, работающая прямо на телефоне, заменить ИИ-функции LangDict, приложения для изучения языков, которое я разрабатываю.
Модель заработала, но после тестов я решил не добавлять её в приложение.
Что мы тестировали
LangDict — приложение с карточками: вводишь слова, которые хочешь выучить, и ИИ генерирует переводы, примеры предложений и произношение. Для трёх функций оно использует Gemini API.
| Функция | Что делает |
|---|---|
| Перевод | Переводит введённый текст на другой язык |
| Создание колод | Берёт тему, например “Travel at the airport”, и создаёт набор карточек со словами, переводами и чтениями |
| Распознавание текста | Превращает текст на фото в редактируемый текст (OCR) |
Мы проверили, сможет ли local LLM заменить их.
Мы смотрели на три вещи:
- Работают ли все три функции на телефоне
- Время ожидания и скорость при непрерывном использовании
- Качество вывода
Условия теста
| Параметр | Подробности |
|---|---|
| Телефон | Android-телефон (7GB RAM) |
| Модель | LFM3-VL-2B (около 1,5GB вместе с mmproj) |
| Метод | Тестовое приложение с теми же промптами, что и в LangDict, замеры во время зарядки |
| Прогоны | По одному прогону на условие (разброс не измерялся) |
Относитесь к числам как к ориентиру. Пункты, которые также тестировались на ПК, помечены «на ПК».
Проблема 1: первый перевод зависает примерно на 20 секунд
Первому переводу после открытия приложения потребовалось 21,2 секунды, чтобы начать выдавать текст, и экран выглядел зависшим. Второй начался за 0,9 секунды.
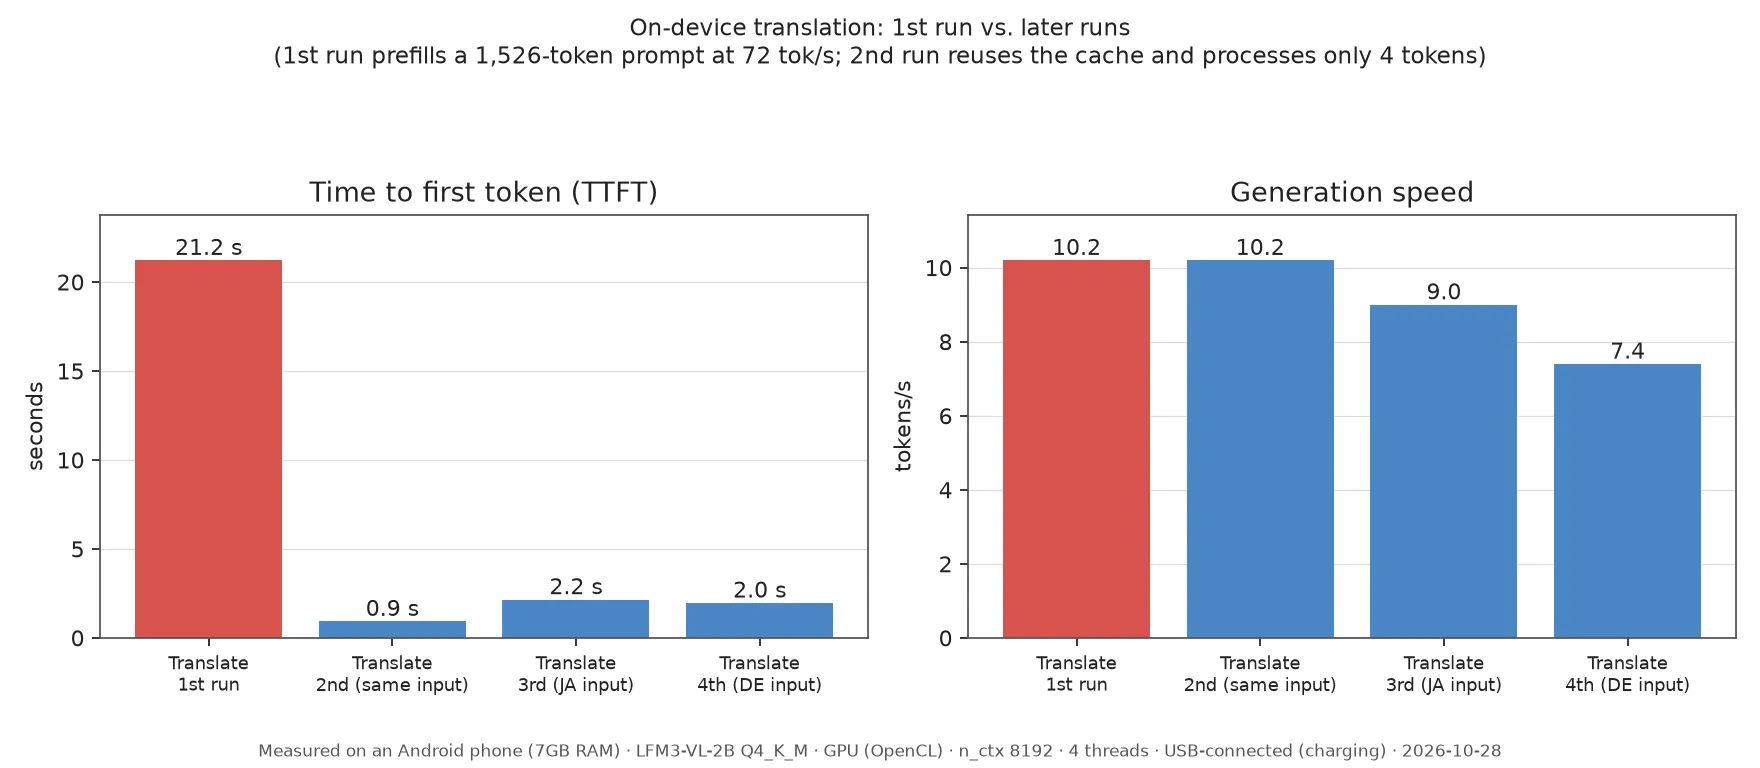
Причина — длина промпта. Промпт перевода занимает 1 526 токенов, а телефон обрабатывает 72 tok/s, поэтому на одно его чтение уходит около 20 секунд. Второй прогон быстрее, потому что срабатывает кэш.
Промпт почти постоянный, поэтому предварительная обработка (prefill) при открытии экрана могла бы сократить ожидание. Это лишь идея, мы её пока не пробовали.
Проблема 2: при продолжительном использовании работа замедляется
Через несколько минут использования нагрев снижает скорость генерации, и последующие задачи ждут дольше.
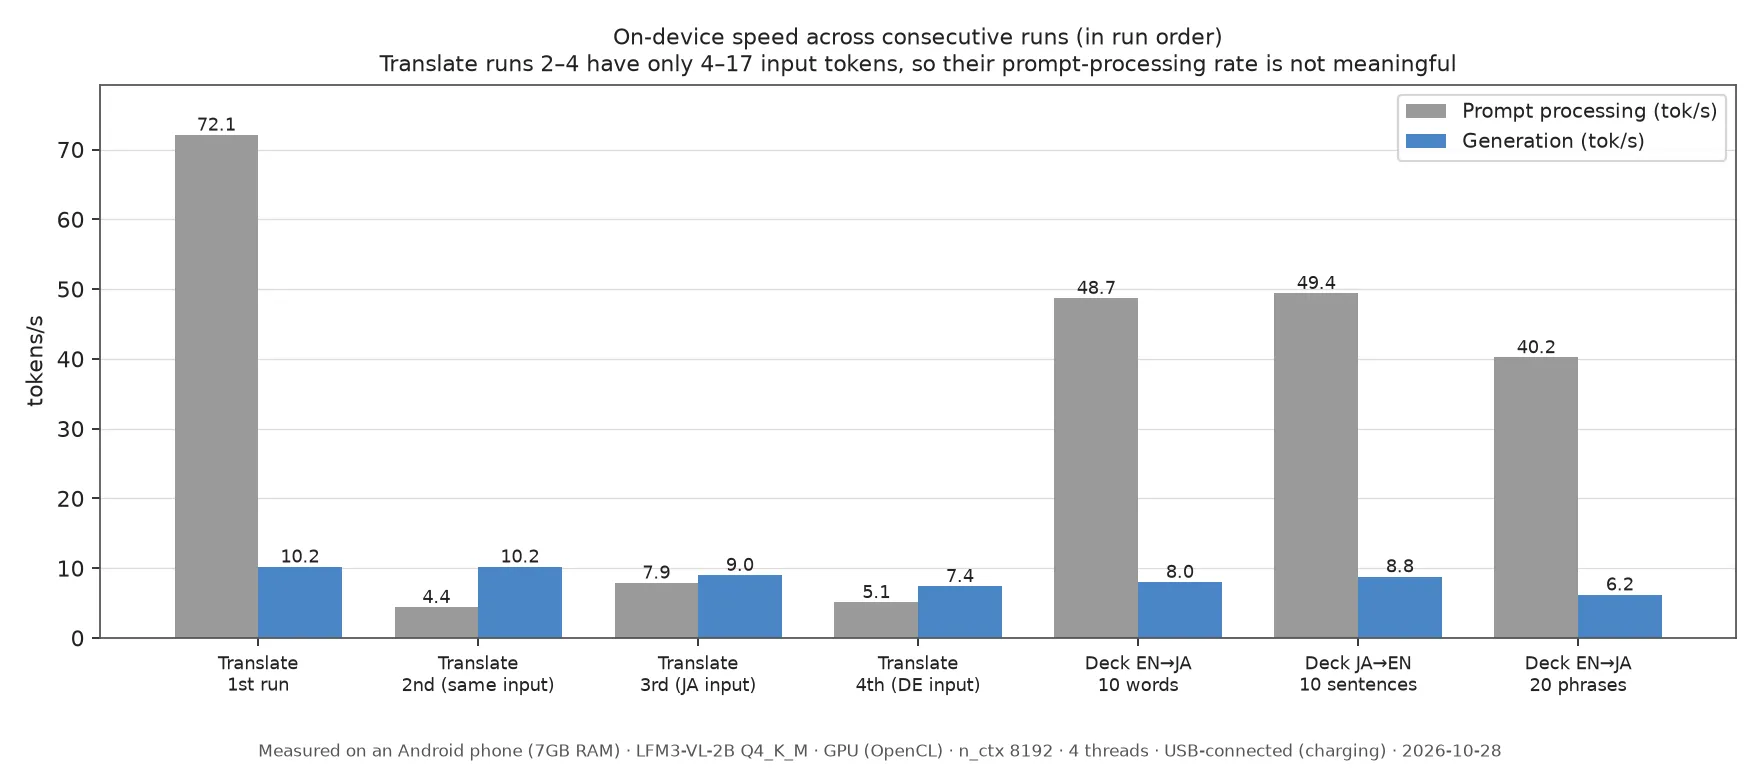
Скорость генерации упала с 10,2 tok/s до 6,2 tok/s. Колода из 20 фраз заняла 156,3 секунды, а колода из 10 слов — 66,6 секунды.
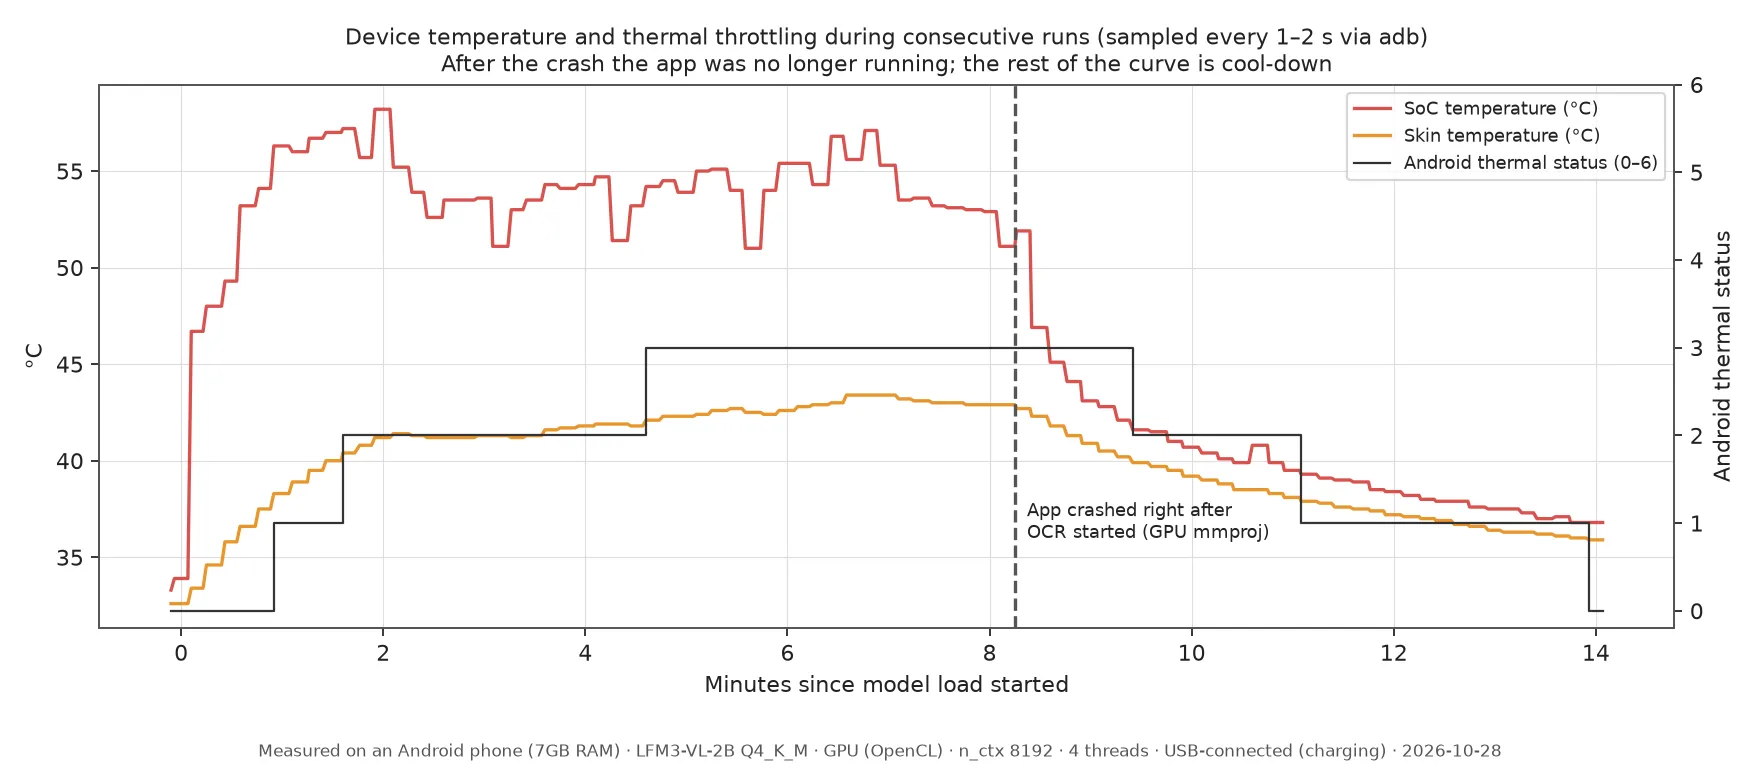
Термический статус Android поднялся до 1 примерно через 1 минуту, до 2 примерно через 1,6 минуты и до 3 примерно через 4,6 минуты. Во второй половине графика температура падает, потому что приложение аварийно завершилось во время следующего теста с изображениями.
Запуск только на CPU
Приведённые выше числа получены при работе на GPU. На одном CPU создание колоды ускорилось с 64,2 до 46,2 секунды, но выросло потребление памяти, а телефон нагрелся раньше.
| GPU | Только CPU | |
|---|---|---|
| Время создания колоды из 10 слов | 64,2 s | 46,2 s |
| Память приложения (пик) | 1052MB | 1923MB |
| Время до термического статуса 3 | Около 2 мин 35 с | Около 1 мин 35 с |
| Пиковая температура SoC | 57,4℃ | 60,4℃ |
Память указана как резидентная и не включает веса, размещённые на GPU.
Проблема 3: переводы и чтения неверны
Модель соблюдает формат JSON, но в содержании есть заметные ошибки. Для приложения с карточками это серьёзная проблема, потому что учащиеся запоминают ошибки как есть.
- Японские чтения почти никогда не были верными. 空港 (аэропорт) превратилось в
kū kōkun, а 荷物 (багаж) — вnagō. - Переводы с английского на японский иногда оставались в романизированном тексте и не становились японскими.
- Немецкую фразу “Ich habe Hunger” модель определила как английскую.
- Колода «корейский — японский», проверенная на ПК, дала только 1 карточку из 10, причём с японским текстом в корейском поле.
- Когда её просили сделать 10 примеров предложений, она останавливалась на 2 карточках на GPU и на 8 на одном CPU.
Те же ошибки были и на ПК, поэтому мы считаем это ограничением модели. Назначение модели в её карточке — тоже в основном чтение изображений и документов, так что перевод и создание колод, возможно, просто не её сильная сторона.
Сравнение с другими моделями
Мы также попробовали Gemma 4 E2B и Qwen3.5-2B на телефоне.
| Модель | Результат на телефоне |
|---|---|
| Gemma 4 E2B (Google, около 3,1GB) | Приложение завершалось во время загрузки все 4 раза |
| Qwen3.5-2B (около 1,3GB) | Работает, но перевод занял 577,4 с, а колоды дали от 1 до 2 карточек из 10 |
На ПК у Gemma 4 E2B было гораздо лучшее качество, например она правильно читала 飛行機 (самолёт) как hikōki. Но на телефоне она не загружалась с настройкой GPU. В журнале первой попытки записано, что Android завершил приложение из-за нехватки памяти. Настройку только на CPU мы не пробовали.
Режим рассуждения
Мы также попробовали режим рассуждения с ограничением в 1 024 токена. Он возвращал ответы, но обработка занимала примерно в 3,5–7 раз больше времени. Колода из 10 слов выросла с 64,2 до 257,7 секунды, а чтения по-прежнему были неверными.
Проблема 4: текст читается, но каждое изображение занимает от 20 до 80 секунд
Распознавание текста оказалось самым перспективным из трёх функций. Из 4 тестовых изображений на 2 модель правильно прочитала каждую строку. Однако на каждое изображение уходит от 20 до 80 секунд.
| Изображение | Правильно прочитанные строки | Время |
|---|---|---|
| Меню на английском | 4 из 9 | 77,7 s |
| Японская станционная табличка | 5 из 5 | 38,4 s |
| Меню на корейском | 5 из 5 | 39,2 s |
| Мелкий размытый японский текст | 3 из 4 | 18,6 s |
Все изображения были сделаны для этого теста. В английском меню модель пропустила цену в 5 строках, а в японском тексте прочитала 天ぷら как 天ぶら.
Сначала мы запускали часть обработки изображений на GPU, и приложение аварийно завершалось из-за нехватки памяти. После переноса на CPU все 4 изображения были обработаны до конца. Но когда телефон уже нагрелся от перевода и создания колод, то же английское меню заняло 122,6 секунды.
Что мы узнали
- Запустить модель на телефоне возможно
- Перевод и создание колод не дотягивают ни по времени ожидания, ни по качеству
- Распознавание текста перспективно по качеству, но ожидание долгое
- Более крупная модель с хорошим качеством на ПК может не загрузиться на телефоне с 7GB RAM
Вывод: не для LangDict
Я решил, что продолжать обращаться к Gemini API даёт лучший пользовательский опыт. С local LLM ожидание было долгим, а в переводах и чтениях было много ошибок.
Тем не менее я почувствовал, что возможность пользоваться этим на месте, где нет сети, например в самолёте, стала бы реальным преимуществом для приложения для изучения языков.
Технические подробности
Заметки для читателей, которым нужны технические подробности.
- Модель: LFM3-VL-2B Q4_K_M (1,10GB) и mmproj F16 (0,38GB)
- Runtime: Expo и llama.rn. Мы заменили llama.cpp на версию с поддержкой LFM3 и локально исправили баг ограничений JSON в llama.rn
- Настройки генерации: temperature 0.1, top_k 50, repetition penalty 1.0. Официальная рекомендация — 1.1, но мы изменили её, потому что JSON часто обрывался на полпути
- Формат вывода: задан через JSON schema
- ПК: RTX 2060 6GB, llama-server и Vulkan
Источники
Проверено 2026-10-31. Все числа по скорости, нагреву и распознаванию текста — наши собственные измерения.
- LiquidAI/LFM3-VL-2B (официальное описание модели)
- LiquidAI/LFM3-VL-2B-GGUF (файлы, которые мы использовали)