รัน LFM3 บนโทรศัพท์เพื่อดูว่าจะแทนฟีเจอร์ AI ของ LangDict ได้หรือไม่
เราทดสอบว่า local LLM ซึ่งเป็นโมเดลขนาดเล็ก LFM3 ของ Liquid AI ที่รันบนตัวโทรศัพท์เอง จะแทนฟีเจอร์ AI ใน LangDict ซึ่งเป็นแอปเรียนภาษาที่ผมพัฒนาได้หรือไม่
มันรันได้ แต่หลังจากทดสอบแล้ว ผมตัดสินใจไม่ใส่ไว้ในแอป
สิ่งที่เราทดสอบ
LangDict เป็นแอปแฟลชการ์ด: ใส่คำที่อยากเรียน แล้ว AI จะสร้างคำแปล ประโยคตัวอย่าง และการออกเสียง แอปใช้ Gemini API กับสามฟีเจอร์
| ฟีเจอร์ | หน้าที่ |
|---|---|
| การแปล | แปลข้อความที่ป้อนเป็นอีกภาษาหนึ่ง |
| การสร้างเด็ค | รับธีมอย่าง “Travel at the airport” แล้วสร้างการ์ดชุดหนึ่งที่มีคำ คำแปล และคำอ่าน |
| การรู้จำข้อความ | แปลงข้อความในรูปถ่ายเป็นข้อความที่แก้ไขได้ (OCR) |
เราทดสอบว่า local LLM จะแทนสิ่งเหล่านี้ได้หรือไม่
เราดูสามเรื่อง:
- ทั้งสามฟีเจอร์รันบนโทรศัพท์ได้หรือไม่
- เวลารอและความเร็วเมื่อใช้งานต่อเนื่อง
- คุณภาพของเอาต์พุต
เงื่อนไขการทดสอบ
| รายการ | รายละเอียด |
|---|---|
| โทรศัพท์ | โทรศัพท์ Android (RAM 7GB) |
| โมเดล | LFM3-VL-2B (ประมาณ 1.5GB รวม mmproj) |
| วิธีการ | แอปทดสอบที่ใช้ prompt เดียวกับ LangDict วัดขณะชาร์จ |
| จำนวนครั้ง | รันหนึ่งครั้งต่อหนึ่งเงื่อนไข (ไม่ได้วัดความแปรปรวน) |
โปรดถือว่าตัวเลขเป็นเพียงแนวทาง รายการที่ทดสอบบน PC ด้วยจะระบุว่า “บน PC”
ปัญหาที่ 1: การแปลครั้งแรกค้างประมาณ 20 วินาที
การแปลครั้งแรกหลังเปิดแอปใช้เวลา 21.2 วินาทีกว่าจะเริ่มแสดงข้อความ และหน้าจอดูเหมือนค้าง ครั้งที่สองเริ่มภายใน 0.9 วินาที
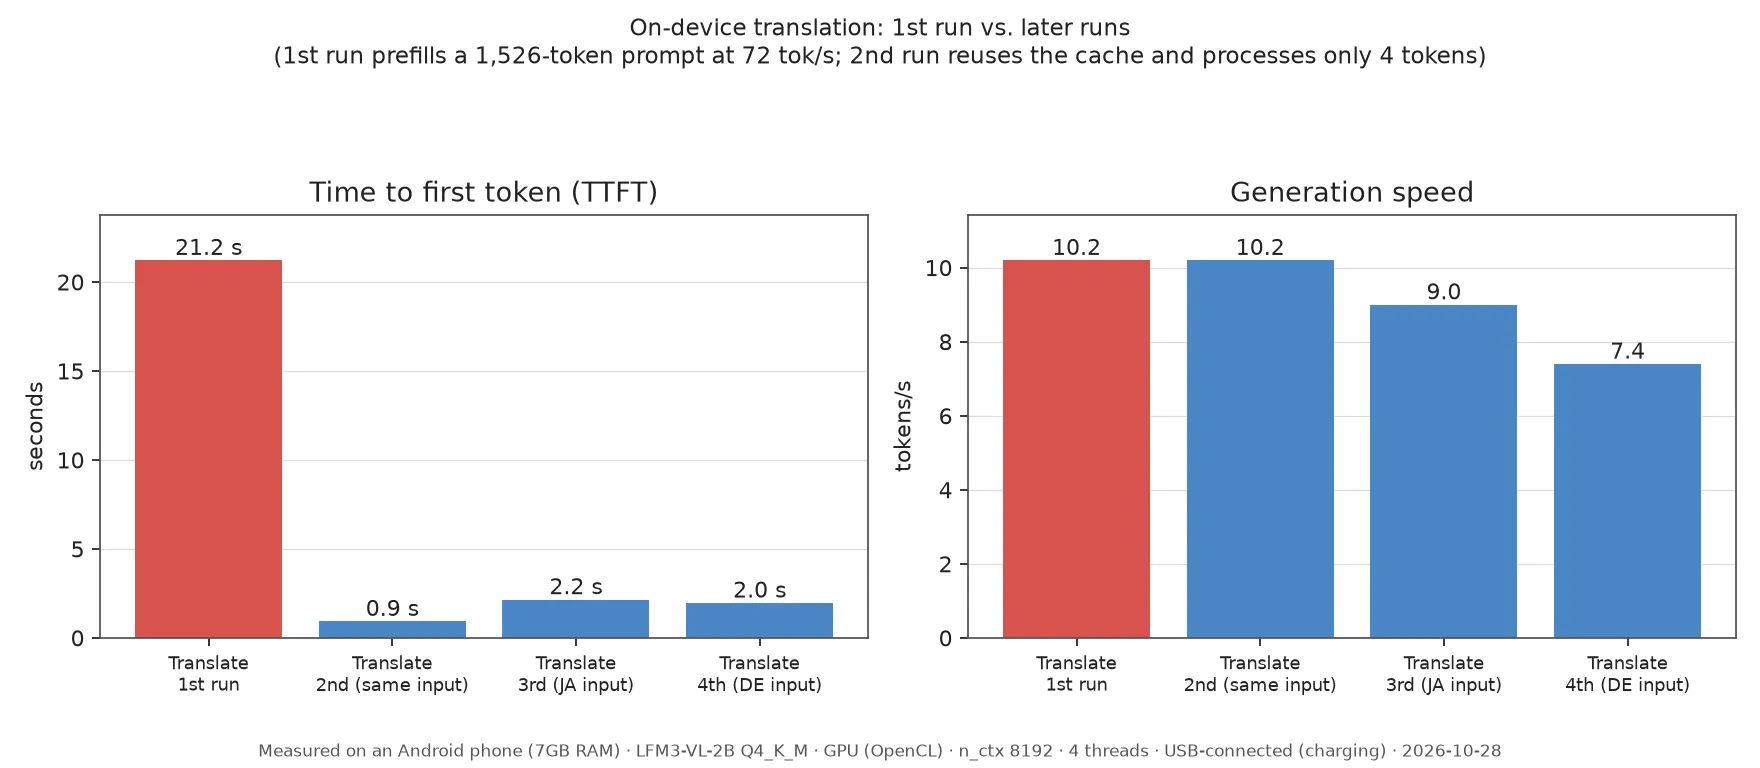
สาเหตุคือความยาวของ prompt prompt สำหรับการแปลมี 1,526 token และโทรศัพท์ประมวลผลได้ 72 tok/s แค่อ่าน prompt ก็ใช้เวลาราว 20 วินาที การรันครั้งที่สองเร็วกว่าเพราะแคชทำงาน
prompt แทบไม่เปลี่ยน ดังนั้นการทำ prefill ไว้ล่วงหน้าตอนเปิดหน้าจออาจช่วยลดเวลารอได้ นี่เป็นเพียงแนวคิด เรายังไม่ได้ลอง
ปัญหาที่ 2: ช้าลงเมื่อใช้งานต่อเนื่อง
หลังใช้งานไปไม่กี่นาที ความร้อนทำให้ความเร็วในการสร้างลดลง งานถัด ๆ ไปจึงรอนานขึ้น
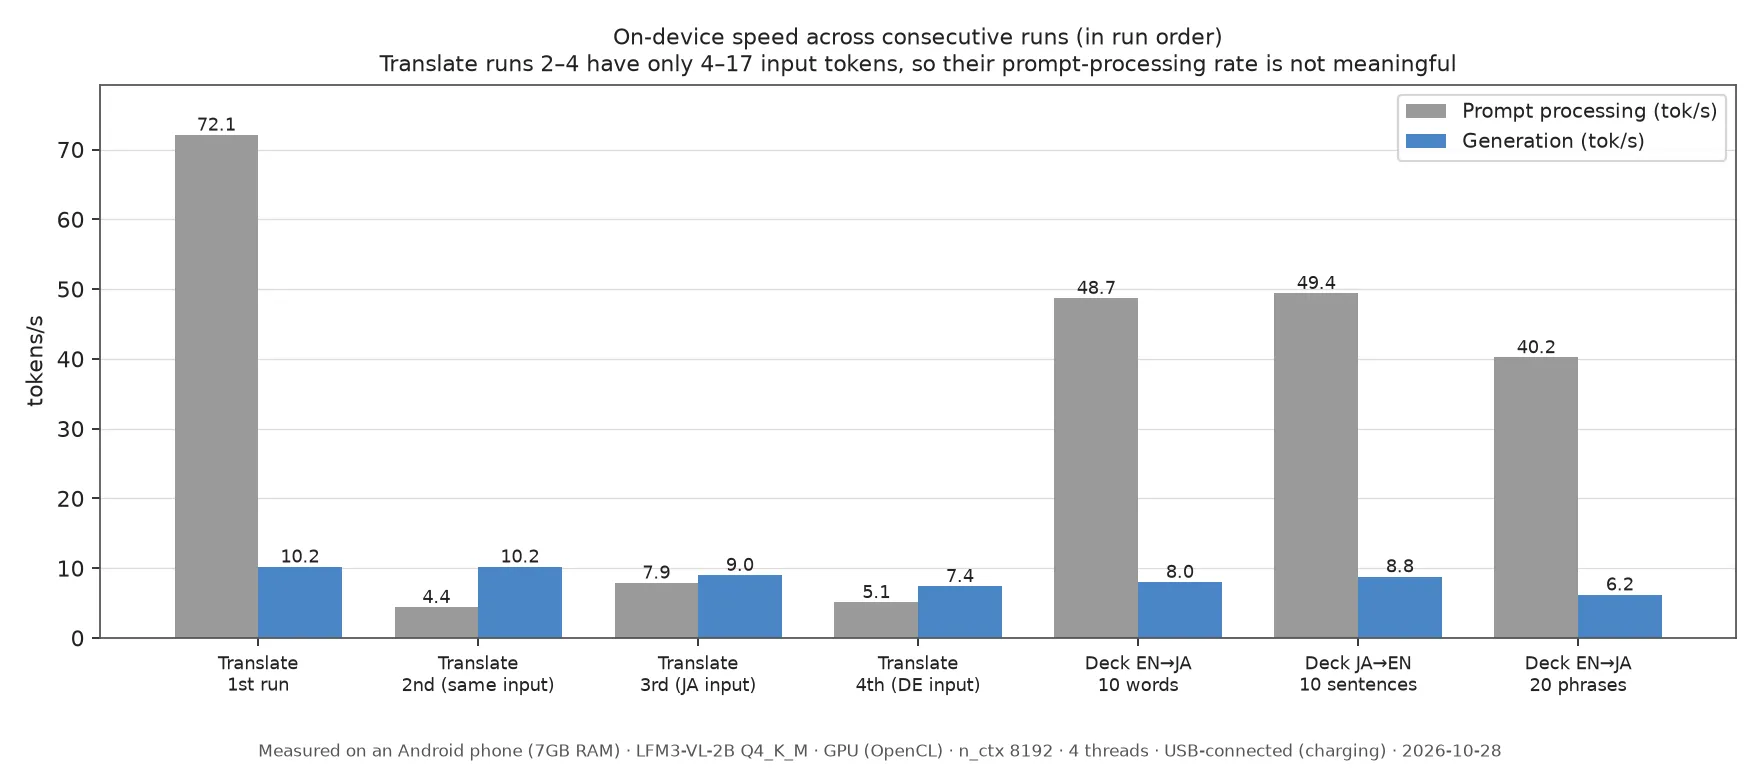
ความเร็วในการสร้างลดจาก 10.2 tok/s เหลือ 6.2 tok/s เด็คที่มี 20 วลีใช้เวลา 156.3 วินาที และแม้แต่เด็ค 10 คำก็ใช้เวลา 66.6 วินาที
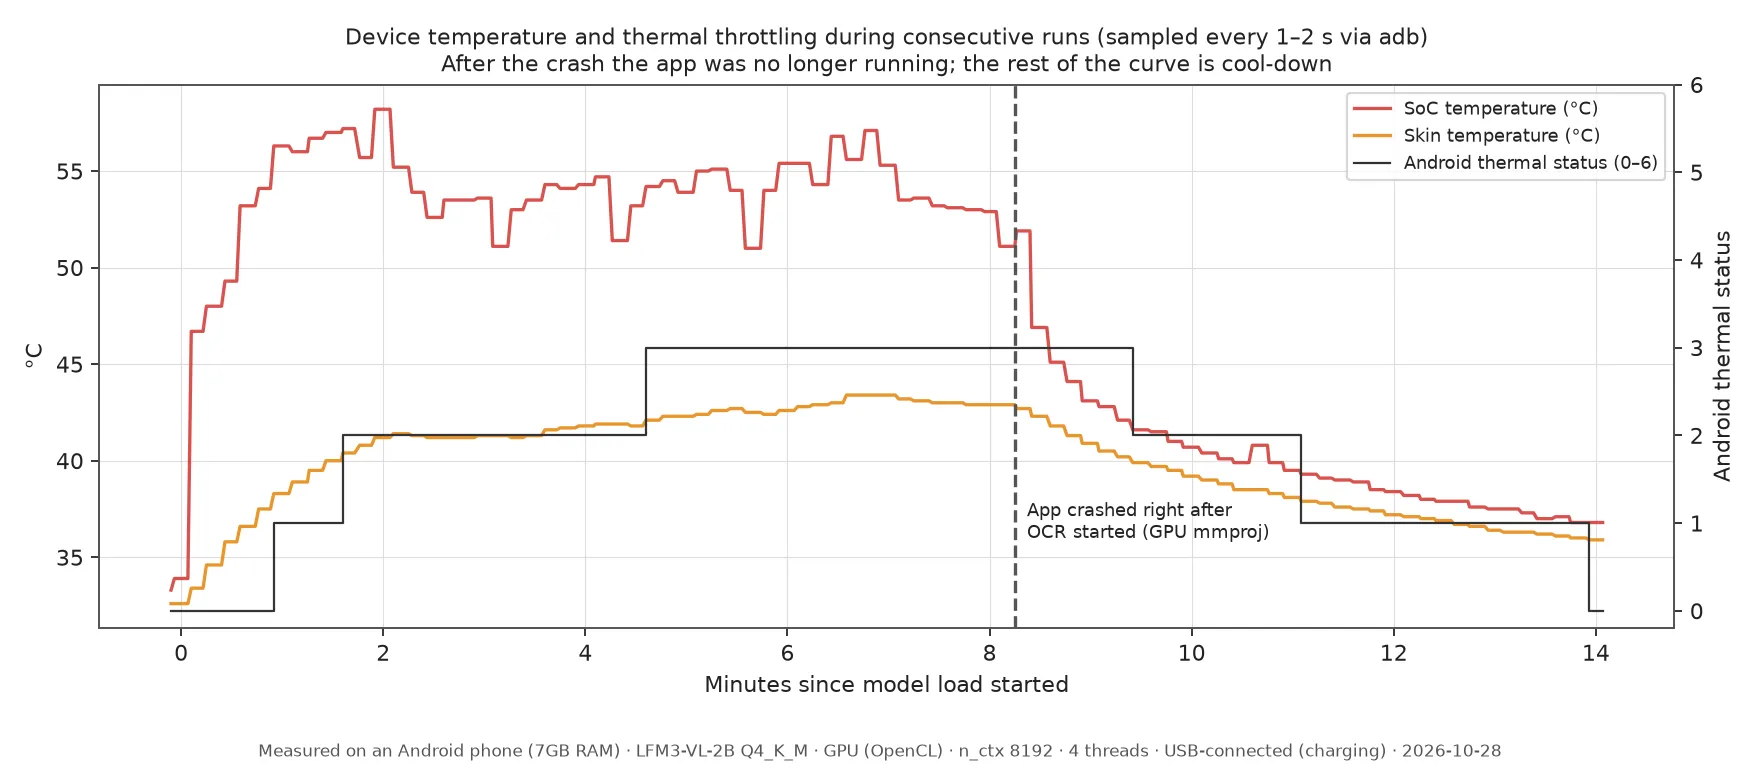
สถานะความร้อนของ Android ขึ้นเป็น 1 หลังประมาณ 1 นาที เป็น 2 หลังประมาณ 1.6 นาที และเป็น 3 หลังประมาณ 4.6 นาที อุณหภูมิลดลงในครึ่งหลังของกราฟเพราะแอปแครชระหว่างการทดสอบรูปภาพที่ตามมา
รันด้วย CPU อย่างเดียว
ตัวเลขข้างต้นมาจากการรันบน GPU เมื่อใช้ CPU อย่างเดียว การสร้างเด็คเร็วขึ้น จาก 64.2 เหลือ 46.2 วินาที แต่การใช้หน่วยความจำเพิ่มขึ้นและโทรศัพท์ร้อนเร็วขึ้น
| GPU | CPU อย่างเดียว | |
|---|---|---|
| เวลาสร้างเด็ค 10 คำ | 64.2 s | 46.2 s |
| หน่วยความจำของแอป (สูงสุด) | 1052MB | 1923MB |
| เวลาถึงสถานะความร้อน 3 | ประมาณ 2 นาที 35 วินาที | ประมาณ 1 นาที 35 วินาที |
| อุณหภูมิ SoC สูงสุด | 57.4℃ | 60.4℃ |
หน่วยความจำคือ resident memory และไม่รวม weight ที่วางไว้บน GPU
ปัญหาที่ 3: คำแปลและคำอ่านผิด
โมเดลรักษารูปแบบ JSON ได้ แต่เนื้อหามีข้อผิดพลาดชัดเจน นี่เป็นปัญหาร้ายแรงในแอปแฟลชการ์ด เพราะผู้เรียนจะจำข้อผิดพลาดไปตามนั้น
- คำอ่านภาษาญี่ปุ่นแทบไม่ถูกเลย 空港 (สนามบิน) กลายเป็น
kū kōkunและ 荷物 (สัมภาระ) กลายเป็นnagō - การแปลจากอังกฤษเป็นญี่ปุ่นบางครั้งยังคงเป็นอักษรโรมันแทนที่จะเป็นภาษาญี่ปุ่น
- มันระบุประโยคภาษาเยอรมัน “Ich habe Hunger” ว่าเป็นภาษาอังกฤษ
- เด็คเกาหลีเป็นญี่ปุ่นที่ทดสอบบน PC ได้การ์ดเพียง 1 ใบจาก 10 โดยมีภาษาญี่ปุ่นอยู่ในช่องภาษาเกาหลี
- เมื่อขอประโยคตัวอย่าง 10 ประโยค มันหยุดที่ 2 การ์ดบน GPU และ 8 การ์ดเมื่อใช้ CPU อย่างเดียว
ข้อผิดพลาดแบบเดียวกันเกิดบน PC ด้วย เราจึงมองว่าเป็นข้อจำกัดของโมเดล การใช้งานที่ตั้งใจไว้ใน model card ก็เป็นเรื่องอย่างการอ่านรูปภาพและเอกสาร การแปลและการสร้างเด็คจึงอาจไม่ใช่จุดแข็งของมัน
เปรียบเทียบกับโมเดลอื่น
เรายังลอง Gemma 4 E2B และ Qwen3.5-2B บนโทรศัพท์ด้วย
| โมเดล | ผลบนโทรศัพท์ |
|---|---|
| Gemma 4 E2B (Google ประมาณ 3.1GB) | แอปถูกปิดระหว่างโหลดทั้ง 4 ครั้ง |
| Qwen3.5-2B (ประมาณ 1.3GB) | รันได้ แต่การแปลใช้เวลา 577.4 s และเด็คได้ 1 ถึง 2 การ์ดจาก 10 |
บน PC Gemma 4 E2B มีคุณภาพดีกว่ามาก เช่น อ่าน 飛行機 (เครื่องบิน) ได้ถูกต้องเป็น hikōki แต่บนโทรศัพท์ มันโหลดไม่ได้เมื่อตั้งค่า GPU บันทึกของความพยายามครั้งแรกระบุว่า Android ปิดแอปเพราะหน่วยความจำไม่พอ เราไม่ได้ลองการตั้งค่า CPU อย่างเดียว
โหมดคิด
เรายังลองโหมดคิดโดยจำกัดที่ 1,024 token มันตอบกลับมาได้ แต่การประมวลผลใช้เวลานานขึ้นราว 3.5 ถึง 7 เท่า เด็ค 10 คำเพิ่มจาก 64.2 เป็น 257.7 วินาที และคำอ่านยังผิดอยู่
ปัญหาที่ 4: อ่านข้อความได้ แต่แต่ละภาพใช้เวลา 20 ถึง 80 วินาที
การรู้จำข้อความเป็นฟีเจอร์ที่น่าหวังที่สุดในสามฟีเจอร์ จากภาพทดสอบ 4 ภาพ มี 2 ภาพที่อ่านถูกทุกบรรทัด แต่แต่ละภาพใช้เวลา 20 ถึง 80 วินาที
| ภาพ | บรรทัดที่อ่านถูก | เวลา |
|---|---|---|
| เมนูภาษาอังกฤษ | 4 จาก 9 | 77.7 s |
| ป้ายสถานีภาษาญี่ปุ่น | 5 จาก 5 | 38.4 s |
| เมนูภาษาเกาหลี | 5 จาก 5 | 39.2 s |
| ข้อความภาษาญี่ปุ่นตัวเล็กและเบลอ | 3 จาก 4 | 18.6 s |
ภาพทั้งหมดทำขึ้นสำหรับการทดสอบนี้ ในเมนูภาษาอังกฤษ มันตกราคาไป 5 บรรทัด และในข้อความภาษาญี่ปุ่น มันอ่าน 天ぷら เป็น 天ぶら
ตอนแรกเรารันส่วนประมวลผลภาพบน GPU และแอปแครชเพราะหน่วยความจำไม่พอ หลังย้ายไปที่ CPU ทั้ง 4 ภาพรันจนจบ แต่เมื่อโทรศัพท์ร้อนอยู่แล้วจากการแปลและการสร้างเด็ค เมนูภาษาอังกฤษภาพเดิมใช้เวลา 122.6 วินาที
สิ่งที่เราได้เรียนรู้
- การรันโมเดลบนโทรศัพท์ทำได้
- การแปลและการสร้างเด็คยังไม่ถึงเกณฑ์ทั้งเรื่องเวลารอและคุณภาพ
- การรู้จำข้อความน่าหวังในด้านคุณภาพ แต่เวลารอนาน
- โมเดลที่ใหญ่กว่าซึ่งคุณภาพดีบน PC อาจโหลดไม่ได้บนโทรศัพท์ที่มี RAM 7GB
บทสรุป: ไม่ใช้กับ LangDict
ผมตัดสินใจว่าการเรียก Gemini API ต่อไปให้ประสบการณ์ผู้ใช้ที่ดีกว่า กับ local LLM เวลารอนาน และคำแปลกับคำอ่านมีข้อผิดพลาดมาก
อย่างไรก็ตาม ผมรู้สึกว่าการใช้งานได้ทันทีในที่ที่ไม่มีเครือข่าย เช่นบนเครื่องบิน จะเป็นประโยชน์จริงสำหรับแอปเรียนภาษา
รายละเอียดทางเทคนิค
บันทึกสำหรับผู้อ่านที่ต้องการรายละเอียดทางเทคนิค
- โมเดล: LFM3-VL-2B Q4_K_M (1.10GB) และ mmproj F16 (0.38GB)
- Runtime: Expo และ llama.rn เราเปลี่ยน llama.cpp เป็นเวอร์ชันที่รองรับ LFM3 และแก้บั๊กข้อจำกัด JSON ใน llama.rn ในเครื่อง
- การตั้งค่าการสร้าง: temperature 0.1, top_k 50, repetition penalty 1.0 ค่าแนะนำอย่างเป็นทางการคือ 1.1 แต่เราเปลี่ยนเพราะ JSON มักหยุดกลางคัน
- รูปแบบเอาต์พุต: กำหนดด้วย JSON schema
- PC: RTX 2060 6GB ใช้ llama-server และ Vulkan
แหล่งที่มา
ตรวจสอบเมื่อ 2026-10-31 ตัวเลขความเร็ว ความร้อน และการรู้จำข้อความทั้งหมดเป็นการวัดของเราเอง
- LiquidAI/LFM3-VL-2B (คำอธิบายโมเดลอย่างเป็นทางการ)
- LiquidAI/LFM3-VL-2B-GGUF (ไฟล์ที่เราใช้)