Chạy LFM3 trên điện thoại để xem nó có thay thế được các tính năng AI của LangDict không
Chúng tôi đã thử xem một local LLM, tức mô hình nhỏ LFM3 của Liquid AI chạy ngay trên điện thoại, có thay thế được các tính năng AI của LangDict hay không. LangDict là ứng dụng học ngôn ngữ do tôi phát triển.
Nó chạy được, nhưng sau khi thử nghiệm, tôi quyết định không đưa nó vào ứng dụng.
Chúng tôi đã thử gì
LangDict là ứng dụng thẻ ghi nhớ: bạn nhập các từ muốn học và AI tạo bản dịch, câu ví dụ và cách phát âm. Ứng dụng dùng Gemini API cho ba tính năng.
| Tính năng | Chức năng |
|---|---|
| Dịch thuật | Dịch văn bản đã nhập sang ngôn ngữ khác |
| Tạo bộ thẻ | Nhận một chủ đề như “Travel at the airport” và tạo một loạt thẻ gồm từ, bản dịch và cách đọc |
| Nhận dạng văn bản | Chuyển văn bản trong ảnh thành văn bản có thể chỉnh sửa (OCR) |
Chúng tôi thử xem local LLM có thay thế được các tính năng này không.
Chúng tôi xem xét ba điều:
- Cả ba tính năng có chạy được trên điện thoại không
- Thời gian chờ và tốc độ khi dùng liên tục
- Chất lượng đầu ra
Điều kiện thử nghiệm
| Hạng mục | Chi tiết |
|---|---|
| Điện thoại | Điện thoại Android (7GB RAM) |
| Mô hình | LFM3-VL-2B (khoảng 1,5GB gồm cả mmproj) |
| Phương pháp | Ứng dụng thử nghiệm dùng cùng prompt với LangDict, đo khi đang sạc |
| Số lần chạy | Một lần chạy cho mỗi điều kiện (không đo phương sai) |
Hãy xem các con số chỉ như tham khảo. Những mục cũng được thử trên PC được ghi chú là “trên PC”.
Vấn đề 1: bản dịch đầu tiên bị treo khoảng 20 giây
Bản dịch đầu tiên sau khi mở ứng dụng mất 21,2 giây mới bắt đầu ra văn bản, và màn hình trông như bị treo. Bản dịch thứ hai bắt đầu sau 0,9 giây.
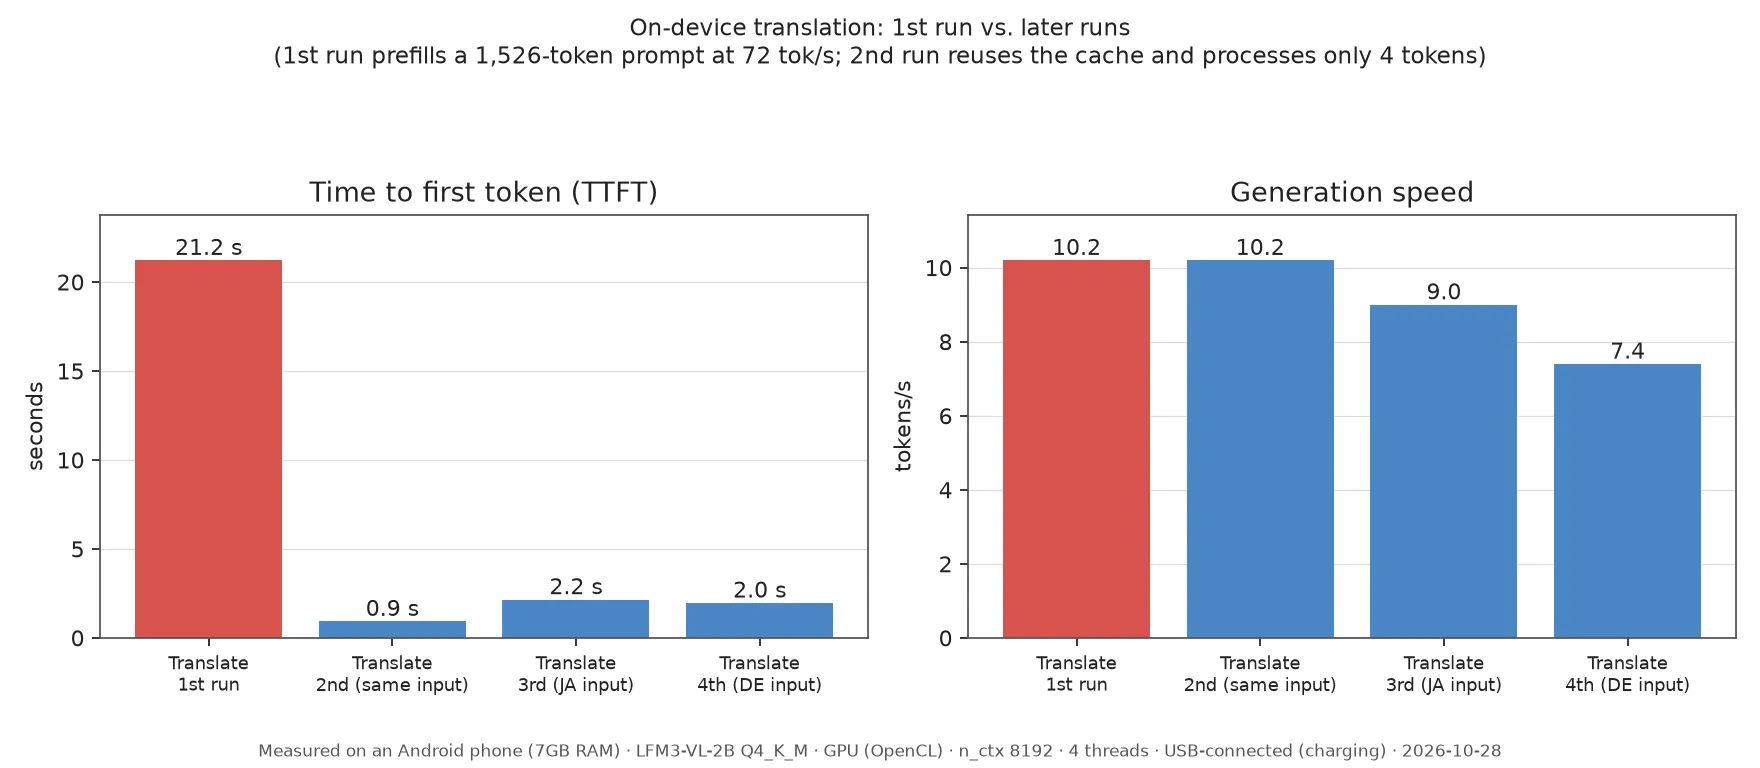
Nguyên nhân là độ dài của prompt. Prompt dịch thuật dài 1.526 token, còn điện thoại xử lý 72 tok/s, nên chỉ riêng việc đọc nó đã mất khoảng 20 giây. Lần chạy thứ hai nhanh hơn vì cache phát huy tác dụng.
Prompt gần như cố định, nên prefill nó khi mở màn hình có thể rút ngắn thời gian chờ. Đây mới chỉ là ý tưởng; chúng tôi chưa thử.
Vấn đề 2: chậm dần khi dùng liên tục
Sau vài phút sử dụng, nhiệt làm giảm tốc độ sinh, nên các tác vụ sau phải chờ lâu hơn.
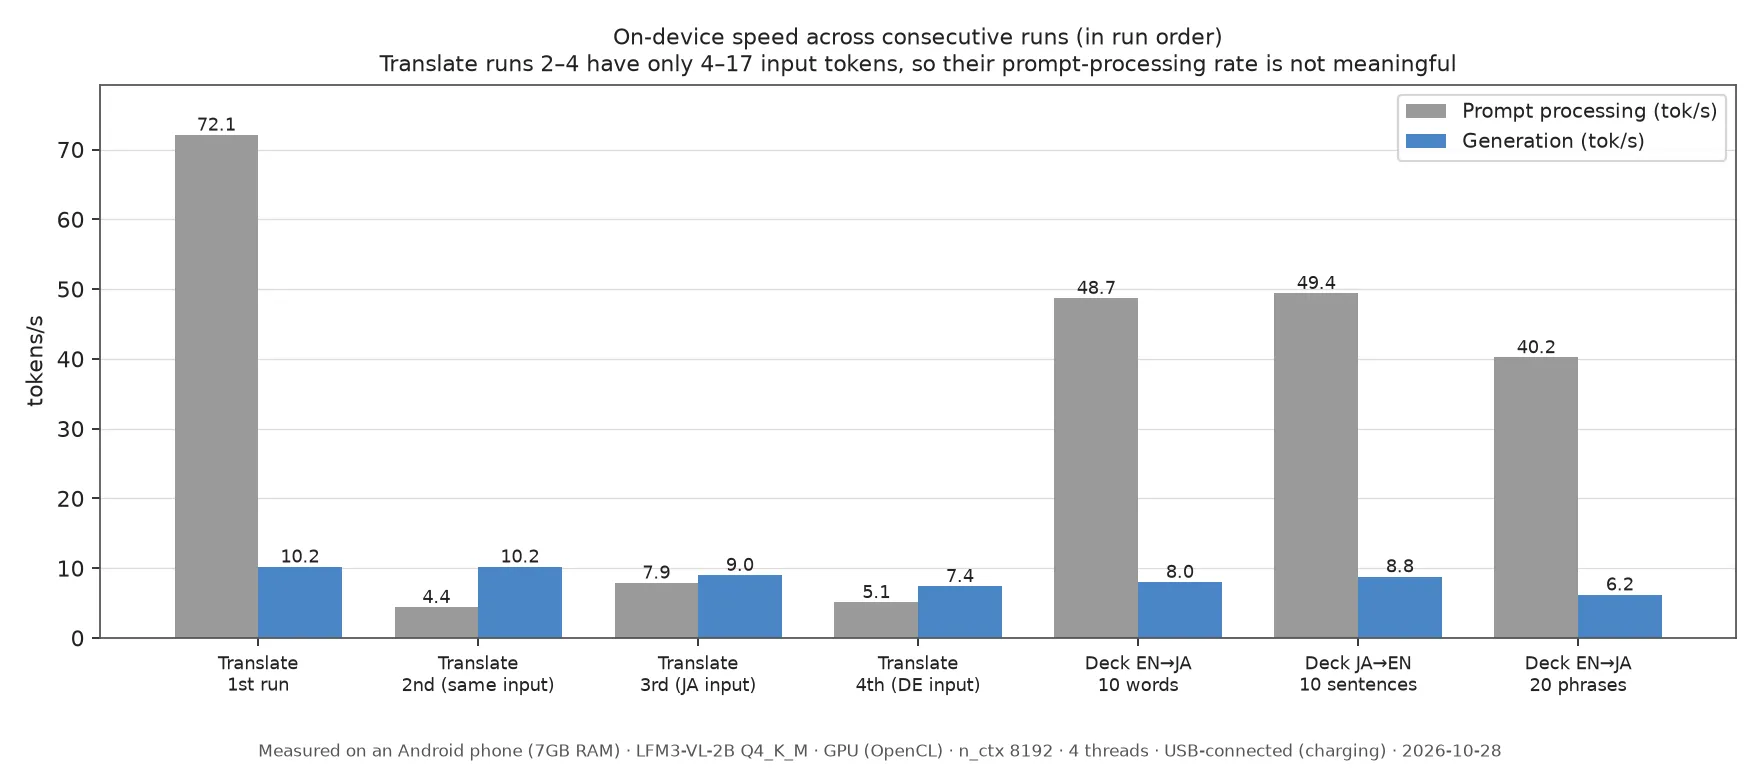
Tốc độ sinh giảm từ 10,2 tok/s xuống 6,2 tok/s. Một bộ thẻ 20 cụm từ mất 156,3 giây, và ngay cả bộ thẻ 10 từ cũng mất 66,6 giây.
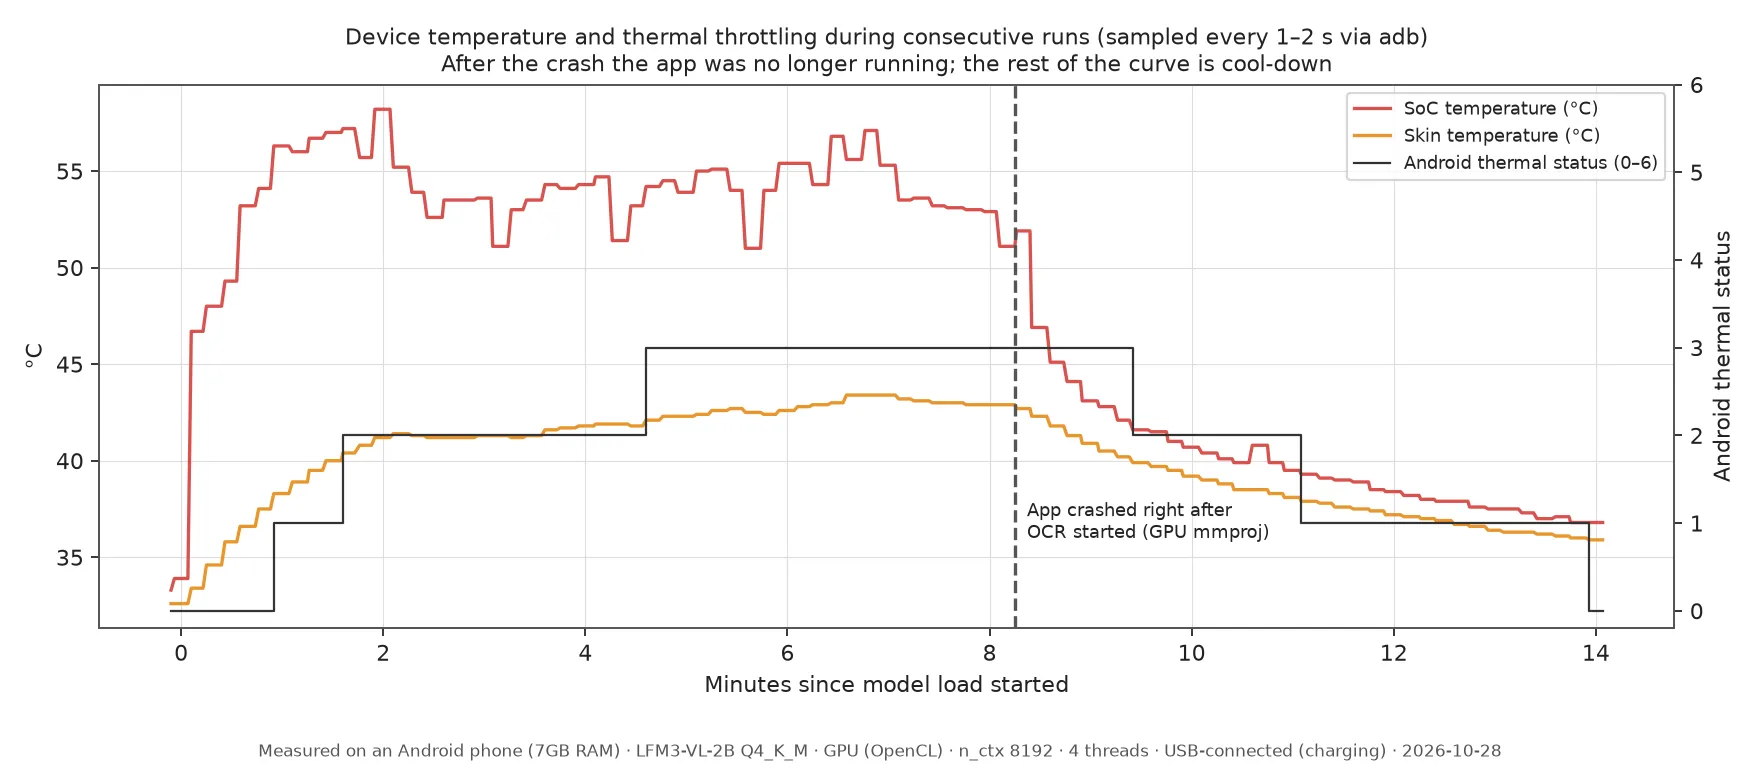
Trạng thái nhiệt của Android tăng lên 1 sau khoảng 1 phút, lên 2 sau khoảng 1,6 phút và lên 3 sau khoảng 4,6 phút. Nhiệt độ giảm ở nửa sau của đồ thị vì ứng dụng bị crash trong bài thử ảnh tiếp theo.
Chạy chỉ bằng CPU
Các con số từ đầu đến đây là khi chạy trên GPU. Chỉ dùng CPU, việc tạo bộ thẻ nhanh hơn, từ 64,2 xuống 46,2 giây, nhưng mức dùng bộ nhớ tăng lên và điện thoại nóng sớm hơn.
| GPU | Chỉ CPU | |
|---|---|---|
| Thời gian tạo bộ thẻ 10 từ | 64,2 s | 46,2 s |
| Bộ nhớ ứng dụng (đỉnh) | 1052MB | 1923MB |
| Thời gian đến trạng thái nhiệt 3 | Khoảng 2 phút 35 giây | Khoảng 1 phút 35 giây |
| Nhiệt độ SoC đỉnh | 57,4℃ | 60,4℃ |
Bộ nhớ là bộ nhớ thường trú và không bao gồm trọng số đặt trên GPU.
Vấn đề 3: bản dịch và cách đọc bị sai
Mô hình giữ đúng định dạng JSON, nhưng nội dung có lỗi rõ rệt. Đây là vấn đề nghiêm trọng trong ứng dụng thẻ ghi nhớ, vì người học sẽ ghi nhớ nguyên các lỗi đó.
- Cách đọc tiếng Nhật hầu như không bao giờ đúng. 空港 (sân bay) thành
kū kōkun, còn 荷物 (hành lý) thànhnagō. - Bản dịch từ tiếng Anh sang tiếng Nhật đôi khi vẫn là văn bản La-tinh hóa thay vì thành tiếng Nhật.
- Nó nhận câu tiếng Đức “Ich habe Hunger” là tiếng Anh.
- Một bộ thẻ Hàn sang Nhật, thử trên PC, chỉ tạo được 1 thẻ trong 10, với tiếng Nhật nằm ở trường tiếng Hàn.
- Khi yêu cầu 10 câu ví dụ, nó dừng ở 2 thẻ trên GPU và 8 thẻ khi chỉ dùng CPU.
Các lỗi tương tự cũng xuất hiện trên PC, nên chúng tôi coi đây là giới hạn của mô hình. Các mục đích sử dụng dự kiến trong model card cũng là những việc như đọc ảnh và tài liệu, nên dịch thuật và tạo bộ thẻ có thể đơn giản là không phải thế mạnh của nó.
So sánh với các mô hình khác
Chúng tôi cũng thử Gemma 4 E2B và Qwen3.5-2B trên điện thoại.
| Mô hình | Kết quả trên điện thoại |
|---|---|
| Gemma 4 E2B (Google, khoảng 3,1GB) | Ứng dụng bị chấm dứt khi đang tải, cả 4 lần |
| Qwen3.5-2B (khoảng 1,3GB) | Chạy được, nhưng dịch mất 577,4 s và bộ thẻ chỉ tạo 1 đến 2 thẻ trong 10 |
Trên PC, Gemma 4 E2B có chất lượng tốt hơn nhiều, chẳng hạn đọc đúng 飛行機 (máy bay) là hikōki. Nhưng trên điện thoại, nó không tải được với thiết lập GPU. Nhật ký của lần thử đầu ghi lại việc Android chấm dứt ứng dụng vì thiếu bộ nhớ. Chúng tôi không thử thiết lập chỉ dùng CPU.
Chế độ suy nghĩ
Chúng tôi cũng thử chế độ suy nghĩ với giới hạn 1.024 token. Nó trả về câu trả lời, nhưng việc xử lý lâu hơn khoảng 3,5 đến 7 lần. Bộ thẻ 10 từ tăng từ 64,2 lên 257,7 giây, và cách đọc vẫn sai.
Vấn đề 4: đọc được văn bản, nhưng mỗi ảnh mất 20 đến 80 giây
Nhận dạng văn bản là tính năng triển vọng nhất trong ba tính năng. Trong 4 ảnh thử nghiệm, có 2 ảnh nó đọc đúng mọi dòng. Tuy nhiên, mỗi ảnh mất 20 đến 80 giây.
| Ảnh | Số dòng đọc đúng | Thời gian |
|---|---|---|
| Thực đơn tiếng Anh | 4 trên 9 | 77,7 s |
| Biển báo nhà ga tiếng Nhật | 5 trên 5 | 38,4 s |
| Thực đơn tiếng Hàn | 5 trên 5 | 39,2 s |
| Chữ Nhật nhỏ, mờ | 3 trên 4 | 18,6 s |
Tất cả ảnh đều được làm riêng cho bài thử này. Ở thực đơn tiếng Anh, nó bỏ sót giá ở 5 dòng, và ở chữ Nhật, nó đọc 天ぷら thành 天ぶら.
Ban đầu chúng tôi chạy phần xử lý ảnh trên GPU, và ứng dụng crash vì thiếu bộ nhớ. Sau khi chuyển sang CPU, cả 4 ảnh chạy đến cùng. Nhưng khi điện thoại đã nóng sẵn do dịch thuật và tạo bộ thẻ, cùng thực đơn tiếng Anh đó mất 122,6 giây.
Những gì chúng tôi rút ra
- Chạy mô hình trên điện thoại là khả thi
- Dịch thuật và tạo bộ thẻ chưa đạt cả về thời gian chờ lẫn chất lượng
- Nhận dạng văn bản có triển vọng về chất lượng, nhưng thời gian chờ lâu
- Một mô hình lớn hơn có chất lượng tốt trên PC có thể không tải được trên điện thoại 7GB RAM
Kết luận: không dùng cho LangDict
Tôi quyết định rằng tiếp tục gọi Gemini API mang lại trải nghiệm người dùng tốt hơn. Với local LLM, thời gian chờ lâu, còn bản dịch và cách đọc có nhiều lỗi.
Dù vậy, tôi cảm thấy việc dùng được ngay tại chỗ không có mạng, như trên máy bay, sẽ là một lợi ích thực sự cho ứng dụng học ngôn ngữ.
Chi tiết kỹ thuật
Ghi chú cho những độc giả muốn biết chi tiết kỹ thuật.
- Mô hình: LFM3-VL-2B Q4_K_M (1,10GB) và mmproj F16 (0,38GB)
- Runtime: Expo và llama.rn. Chúng tôi thay llama.cpp bằng bản hỗ trợ LFM3 và sửa cục bộ một bug ràng buộc JSON trong llama.rn
- Thiết lập sinh: temperature 0.1, top_k 50, repetition penalty 1.0. Khuyến nghị chính thức là 1.1, nhưng chúng tôi đổi vì JSON hay bị dừng giữa chừng
- Định dạng đầu ra: chỉ định bằng JSON schema
- PC: RTX 2060 6GB, dùng llama-server và Vulkan
Nguồn
Kiểm tra ngày 2026-10-31. Mọi con số về tốc độ, nhiệt và nhận dạng văn bản đều do chúng tôi tự đo.
- LiquidAI/LFM3-VL-2B (mô tả mô hình chính thức)
- LiquidAI/LFM3-VL-2B-GGUF (các tệp chúng tôi đã dùng)