Ejecutar LFM3 en un teléfono para ver si puede sustituir las funciones de IA de LangDict
Probamos si un local LLM, el pequeño modelo LFM3 de Liquid AI ejecutándose en el propio teléfono, podía sustituir las funciones de IA de LangDict, una aplicación de aprendizaje de idiomas que desarrollo.
Funcionó, pero tras las pruebas decidí no incluirlo en la aplicación.
Qué probamos
LangDict es una aplicación de tarjetas de memoria: introduces las palabras que quieres aprender y la IA genera traducciones, frases de ejemplo y pronunciaciones. Usa la Gemini API para tres funciones.
| Función | Qué hace |
|---|---|
| Traducción | Traduce el texto introducido a otro idioma |
| Generación de mazos | Toma un tema como “Travel at the airport” y crea un lote de tarjetas con palabras, traducciones y lecturas |
| Reconocimiento de texto | Convierte el texto de una foto en texto editable (OCR) |
Probamos si un local LLM podía sustituirlas.
Examinamos tres aspectos:
- Si las tres funciones se ejecutan en el teléfono
- Tiempos de espera y velocidad con uso continuo
- Calidad de la salida
Condiciones de la prueba
| Elemento | Detalles |
|---|---|
| Teléfono | Teléfono Android (7GB de RAM) |
| Modelo | LFM3-VL-2B (unos 1,5GB con mmproj) |
| Método | Una aplicación de prueba con los mismos prompts que LangDict, medida mientras cargaba |
| Ejecuciones | Una ejecución por condición (no se midió la varianza) |
Toma las cifras como orientación. Los elementos que también se probaron en PC están marcados como “en PC”.
Problema 1: la primera traducción se congela unos 20 segundos
La primera traducción tras abrir la aplicación tardó 21,2 segundos en empezar a producir texto, y la pantalla parecía congelada. La segunda empezó en 0,9 segundos.
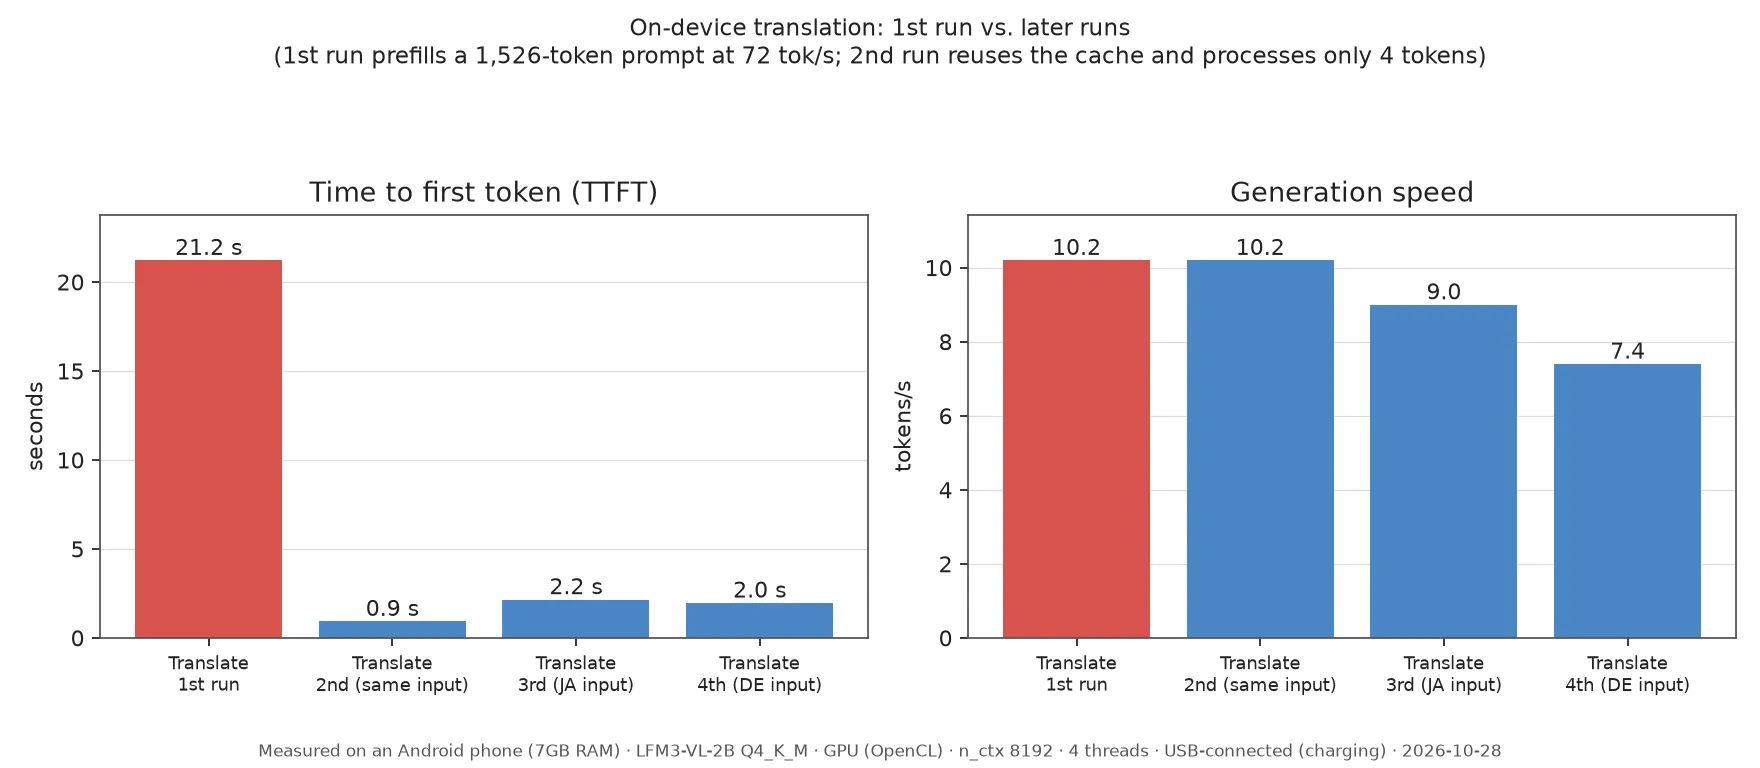
La causa fue la longitud del prompt. El prompt de traducción tiene 1.526 tokens y el teléfono procesa 72 tok/s, así que solo leerlo lleva unos 20 segundos. La segunda ejecución es más rápida porque entra en juego la caché.
El prompt es casi fijo, así que procesarlo previamente al abrir la pantalla podría acortar la espera. Es solo una idea; todavía no la hemos probado.
Problema 2: se ralentiza con el uso continuado
Tras unos minutos de uso, el calor reduce la velocidad de generación, de modo que las tareas posteriores esperan más.
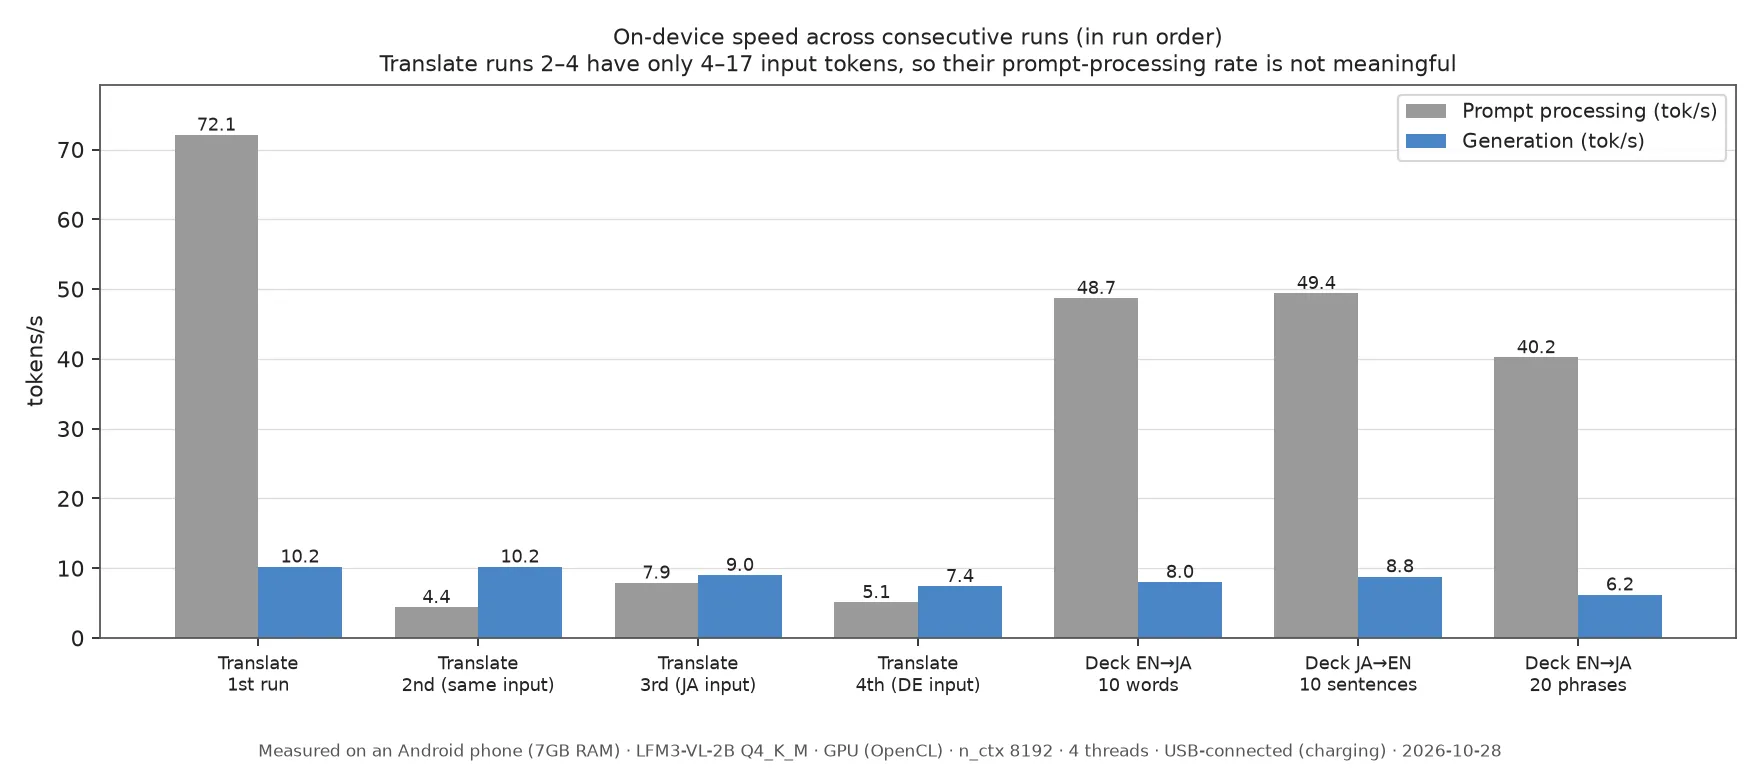
La velocidad de generación cayó de 10,2 tok/s a 6,2 tok/s. Un mazo de 20 frases tardó 156,3 segundos, e incluso un mazo de 10 palabras tardó 66,6 segundos.
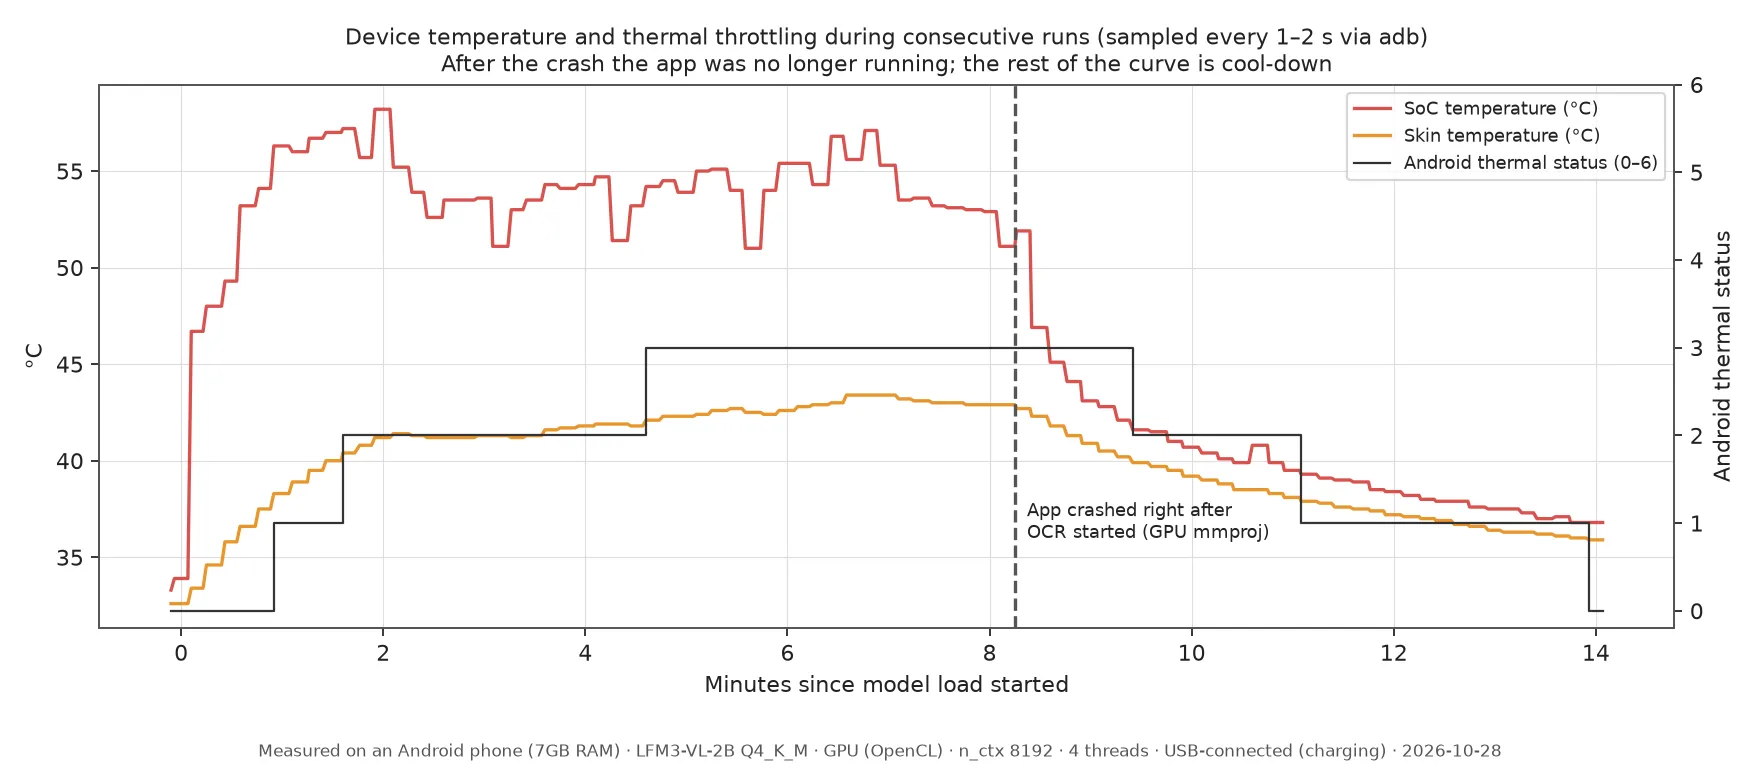
El estado térmico de Android subió a 1 tras aproximadamente 1 minuto, a 2 tras aproximadamente 1,6 minutos y a 3 tras aproximadamente 4,6 minutos. La temperatura baja en la segunda mitad del gráfico porque la aplicación se cerró durante la prueba de imágenes que vino después.
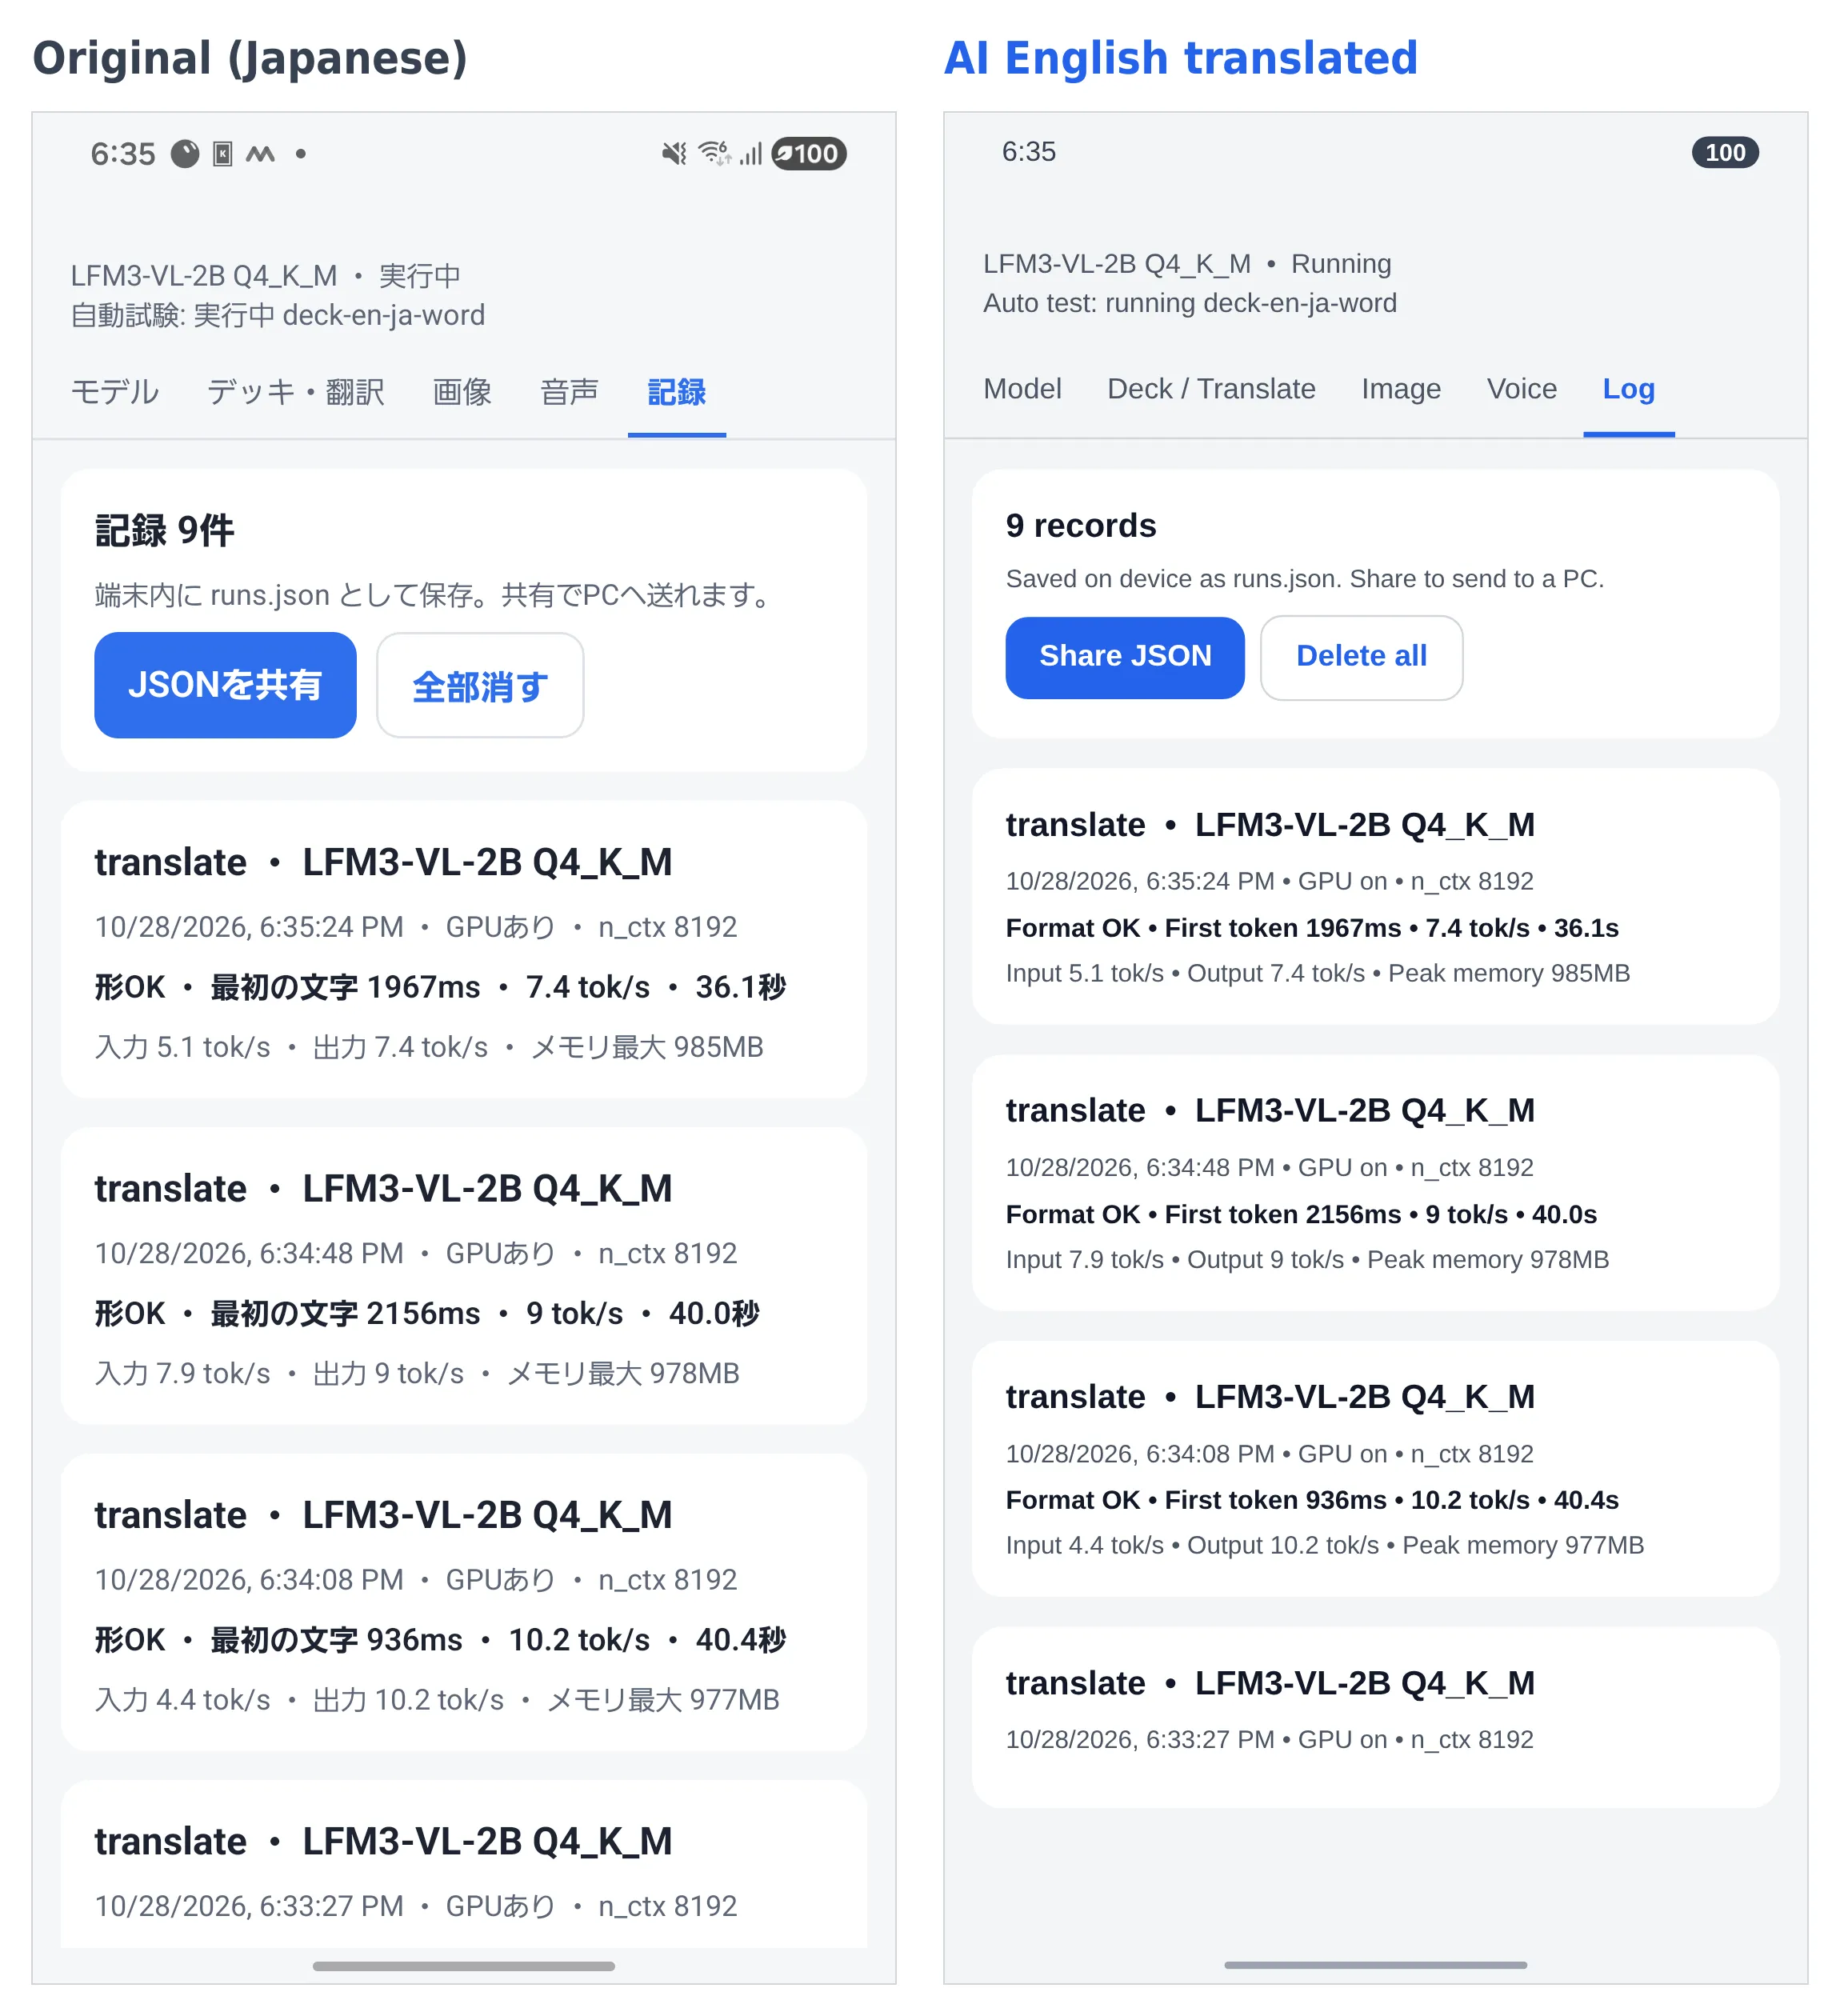
Ejecución solo con CPU
Las cifras anteriores provienen de la ejecución en GPU. Solo con CPU, la generación de un mazo fue más rápida, de 64,2 a 46,2 segundos, pero aumentó el uso de memoria y el teléfono se calentó antes.
| GPU | Solo CPU | |
|---|---|---|
| Tiempo para generar un mazo de 10 palabras | 64,2 s | 46,2 s |
| Memoria de la aplicación (pico) | 1052MB | 1923MB |
| Tiempo hasta el estado térmico 3 | Unos 2 min 35 s | Unos 1 min 35 s |
| Temperatura máxima del SoC | 57,4℃ | 60,4℃ |
La memoria es memoria residente y no incluye los pesos colocados en la GPU.
Problema 3: las traducciones y las lecturas son erróneas
El modelo respeta el formato JSON, pero el contenido tiene errores notables. Es un problema grave en una aplicación de tarjetas, porque los estudiantes memorizan los errores tal cual.
- Las lecturas del japonés casi nunca fueron correctas. 空港 (aeropuerto) pasó a ser
kū kōkuny 荷物 (equipaje) pasó a sernagō. - Las traducciones de inglés a japonés a veces se quedaban en texto romanizado en lugar de convertirse en japonés.
- Identificó como inglés la frase alemana “Ich habe Hunger”.
- Un mazo de coreano a japonés, probado en PC, produjo solo 1 tarjeta de 10, con japonés en el campo coreano.
- Al pedir 10 frases de ejemplo, se detuvo en 2 tarjetas en la GPU y en 8 solo con CPU.
Los mismos errores aparecieron en PC, así que lo vemos como un límite del modelo. Los usos previstos de la ficha del modelo son también cosas como leer imágenes y documentos, de modo que la traducción y la generación de mazos quizá simplemente no sean su punto fuerte.
Comparación con otros modelos
También probamos Gemma 4 E2B y Qwen3.5-2B en el teléfono.
| Modelo | Resultado en el teléfono |
|---|---|
| Gemma 4 E2B (Google, unos 3,1GB) | La aplicación se cerró durante la carga las 4 veces |
| Qwen3.5-2B (unos 1,3GB) | Funciona, pero la traducción tardó 577,4 s y los mazos produjeron de 1 a 2 tarjetas de 10 |
En PC, Gemma 4 E2B tenía una calidad mucho mejor; por ejemplo, leía correctamente 飛行機 (avión) como hikōki. Sin embargo, en el teléfono no se cargaba con la configuración de GPU. El registro del primer intento muestra que Android cerró la aplicación por falta de memoria. No probamos la configuración solo con CPU.
Modo de razonamiento
También probamos el modo de razonamiento con un límite de 1.024 tokens. Devolvió respuestas, pero el procesamiento tardó entre 3,5 y 7 veces más. Un mazo de 10 palabras pasó de 64,2 a 257,7 segundos, y las lecturas seguían siendo erróneas.
Problema 4: puede leer texto, pero cada imagen tarda de 20 a 80 segundos
El reconocimiento de texto fue la más prometedora de las tres funciones. De las 4 imágenes de prueba, leyó correctamente todas las líneas en 2. Sin embargo, cada imagen tarda de 20 a 80 segundos.
| Imagen | Líneas leídas correctamente | Tiempo |
|---|---|---|
| Menú en inglés | 4 de 9 | 77,7 s |
| Cartel de estación en japonés | 5 de 5 | 38,4 s |
| Menú en coreano | 5 de 5 | 39,2 s |
| Texto japonés pequeño y borroso | 3 de 4 | 18,6 s |
Todas las imágenes se hicieron para esta prueba. En el menú en inglés omitió el precio en 5 líneas, y en el texto japonés leyó 天ぷら como 天ぶら.
Al principio ejecutamos la parte de procesamiento de imágenes en la GPU y la aplicación se cerró por falta de memoria. Tras pasarla a la CPU, las 4 imágenes se ejecutaron hasta el final. Pero cuando el teléfono ya estaba caliente por la traducción y la generación de mazos, el mismo menú en inglés tardó 122,6 segundos.
Lo que aprendimos
- Ejecutar el modelo en un teléfono es posible
- La traducción y la generación de mazos se quedan cortas tanto en tiempo de espera como en calidad
- El reconocimiento de texto es prometedor en calidad, pero la espera es larga
- Un modelo más grande que tiene buena calidad en PC puede no cargarse en un teléfono con 7GB de RAM
Conclusión: no para LangDict
Decidí que seguir llamando a la Gemini API ofrece una mejor experiencia de usuario. Con el local LLM, las esperas eran largas y las traducciones y lecturas tenían muchos errores.
Dicho esto, sentí que poder usarlo al instante donde no hay red, como en un avión, sería un beneficio real para una aplicación de aprendizaje de idiomas.
Detalles técnicos
Notas para los lectores que quieran los detalles técnicos.
- Modelo: LFM3-VL-2B Q4_K_M (1,10GB) y mmproj F16 (0,38GB)
- Runtime: Expo y llama.rn. Cambiamos llama.cpp por una versión compatible con LFM3 y corregimos localmente un bug de restricción JSON en llama.rn
- Ajustes de generación: temperature 0.1, top_k 50, repetition penalty 1.0. La recomendación oficial es 1.1, pero lo cambiamos porque el JSON tendía a cortarse a medias
- Formato de salida: especificado con un JSON schema
- PC: RTX 2060 6GB, usando llama-server y Vulkan
Fuentes
Comprobadas el 2026-10-31. Todas las cifras de velocidad, calor y reconocimiento de texto son mediciones propias.
- LiquidAI/LFM3-VL-2B (descripción oficial del modelo)
- LiquidAI/LFM3-VL-2B-GGUF (los archivos que usamos)